Em qualquer grande organização, se você trabalha com gestão de dados mestres (MDM), está constantemente lidando com fluxos de dados de fornecedores, conformidade regulatória, métricas de sustentabilidade, compartilhamento de mercado... ao mesmo tempo em que precisa manter os custos baixos e a satisfação alta.
Com o aprendizado de máquina (ML), você pode automatizar tarefas repetitivas e demoradas a velocidades incríveis, mas confiar nas previsões da IA representa um verdadeiro desafio.
Quando seu modelo de ML sugere categorias incorretas para produtos ou identifica erroneamente relações, esses erros geram problemas a jusante que podem anular seus ganhos de eficiência.
Afinal, se você precisa verificar manualmente cada decisão da IA, será que está realmente economizando recursos?
Na Stibo Systems, estamos combinando a velocidade do ML com a verificação matemática, permitindo que você alcance a verdadeira automação com o nível de precisão que sua empresa precisa.
E, nesta postagem do blog, vou compartilhar como chegamos a esse ponto e como isso funciona. Você vai entender o contexto E as principais lições.
Por que precisamos de máquinas para ajudar no MDM?
Sua carga de trabalho de gerenciamento de dados provavelmente parece estar crescendo mais rápido do que sua capacidade de lidar com ela. Você não está sozinho. Os gerentes de dados de hoje navegam por um cenário complexo, no qual precisão, velocidade e volume disputam a prioridade.
- Incorporar enormes sortimentos de produtos de fornecedores com formatos e qualidade de dados inconsistentes
- Manter processos de governança que garantam a confiabilidade dos seus dados em todos os sistemas
- Manter a conformidade com requisitos regulatórios em constante evolução
- Gerenciar uma gama cada vez maior de dados de sustentabilidade e ESG
- Distribuir dados limpos e consistentes para diversos canais e marketplaces
As abordagens tradicionais para esses desafios costumam depender fortemente de processos manuais, regras de negócios e verificação humana.
Isso pode funcionar em menor escala, mas quando o volume de dados cresce, surgem gargalos. Um gerente de produto que antes conseguia verificar 50 novos itens por dia agora se depara com lotes de milhares, tornando a revisão manual impraticável.
E não se trata apenas de economizar tempo – trata-se de manter a vantagem competitiva. Quando seus concorrentes conseguem integrar novos produtos mais rapidamente, atualizar informações com maior agilidade e distribuir dados de forma mais eficaz, eles ganham vantagens cruciais no mercado. Os processos manuais simplesmente não conseguem se expandir para atender a essas demandas sem investimentos significativos em recursos.
O que torna esses desafios particularmente adequados para a intervenção tecnológica é sua natureza repetitiva e baseada em padrões. Muitas vezes, trata-se de reconhecer semelhanças, aplicar regras consistentes e tomar decisões baseadas em evidências.
Exatamente o tipo de trabalho em que o ML se destaca.
Como o ML mudou completamente o jogo
O ML se alinha perfeitamente às tarefas mais trabalhosas do gerenciamento de dados.
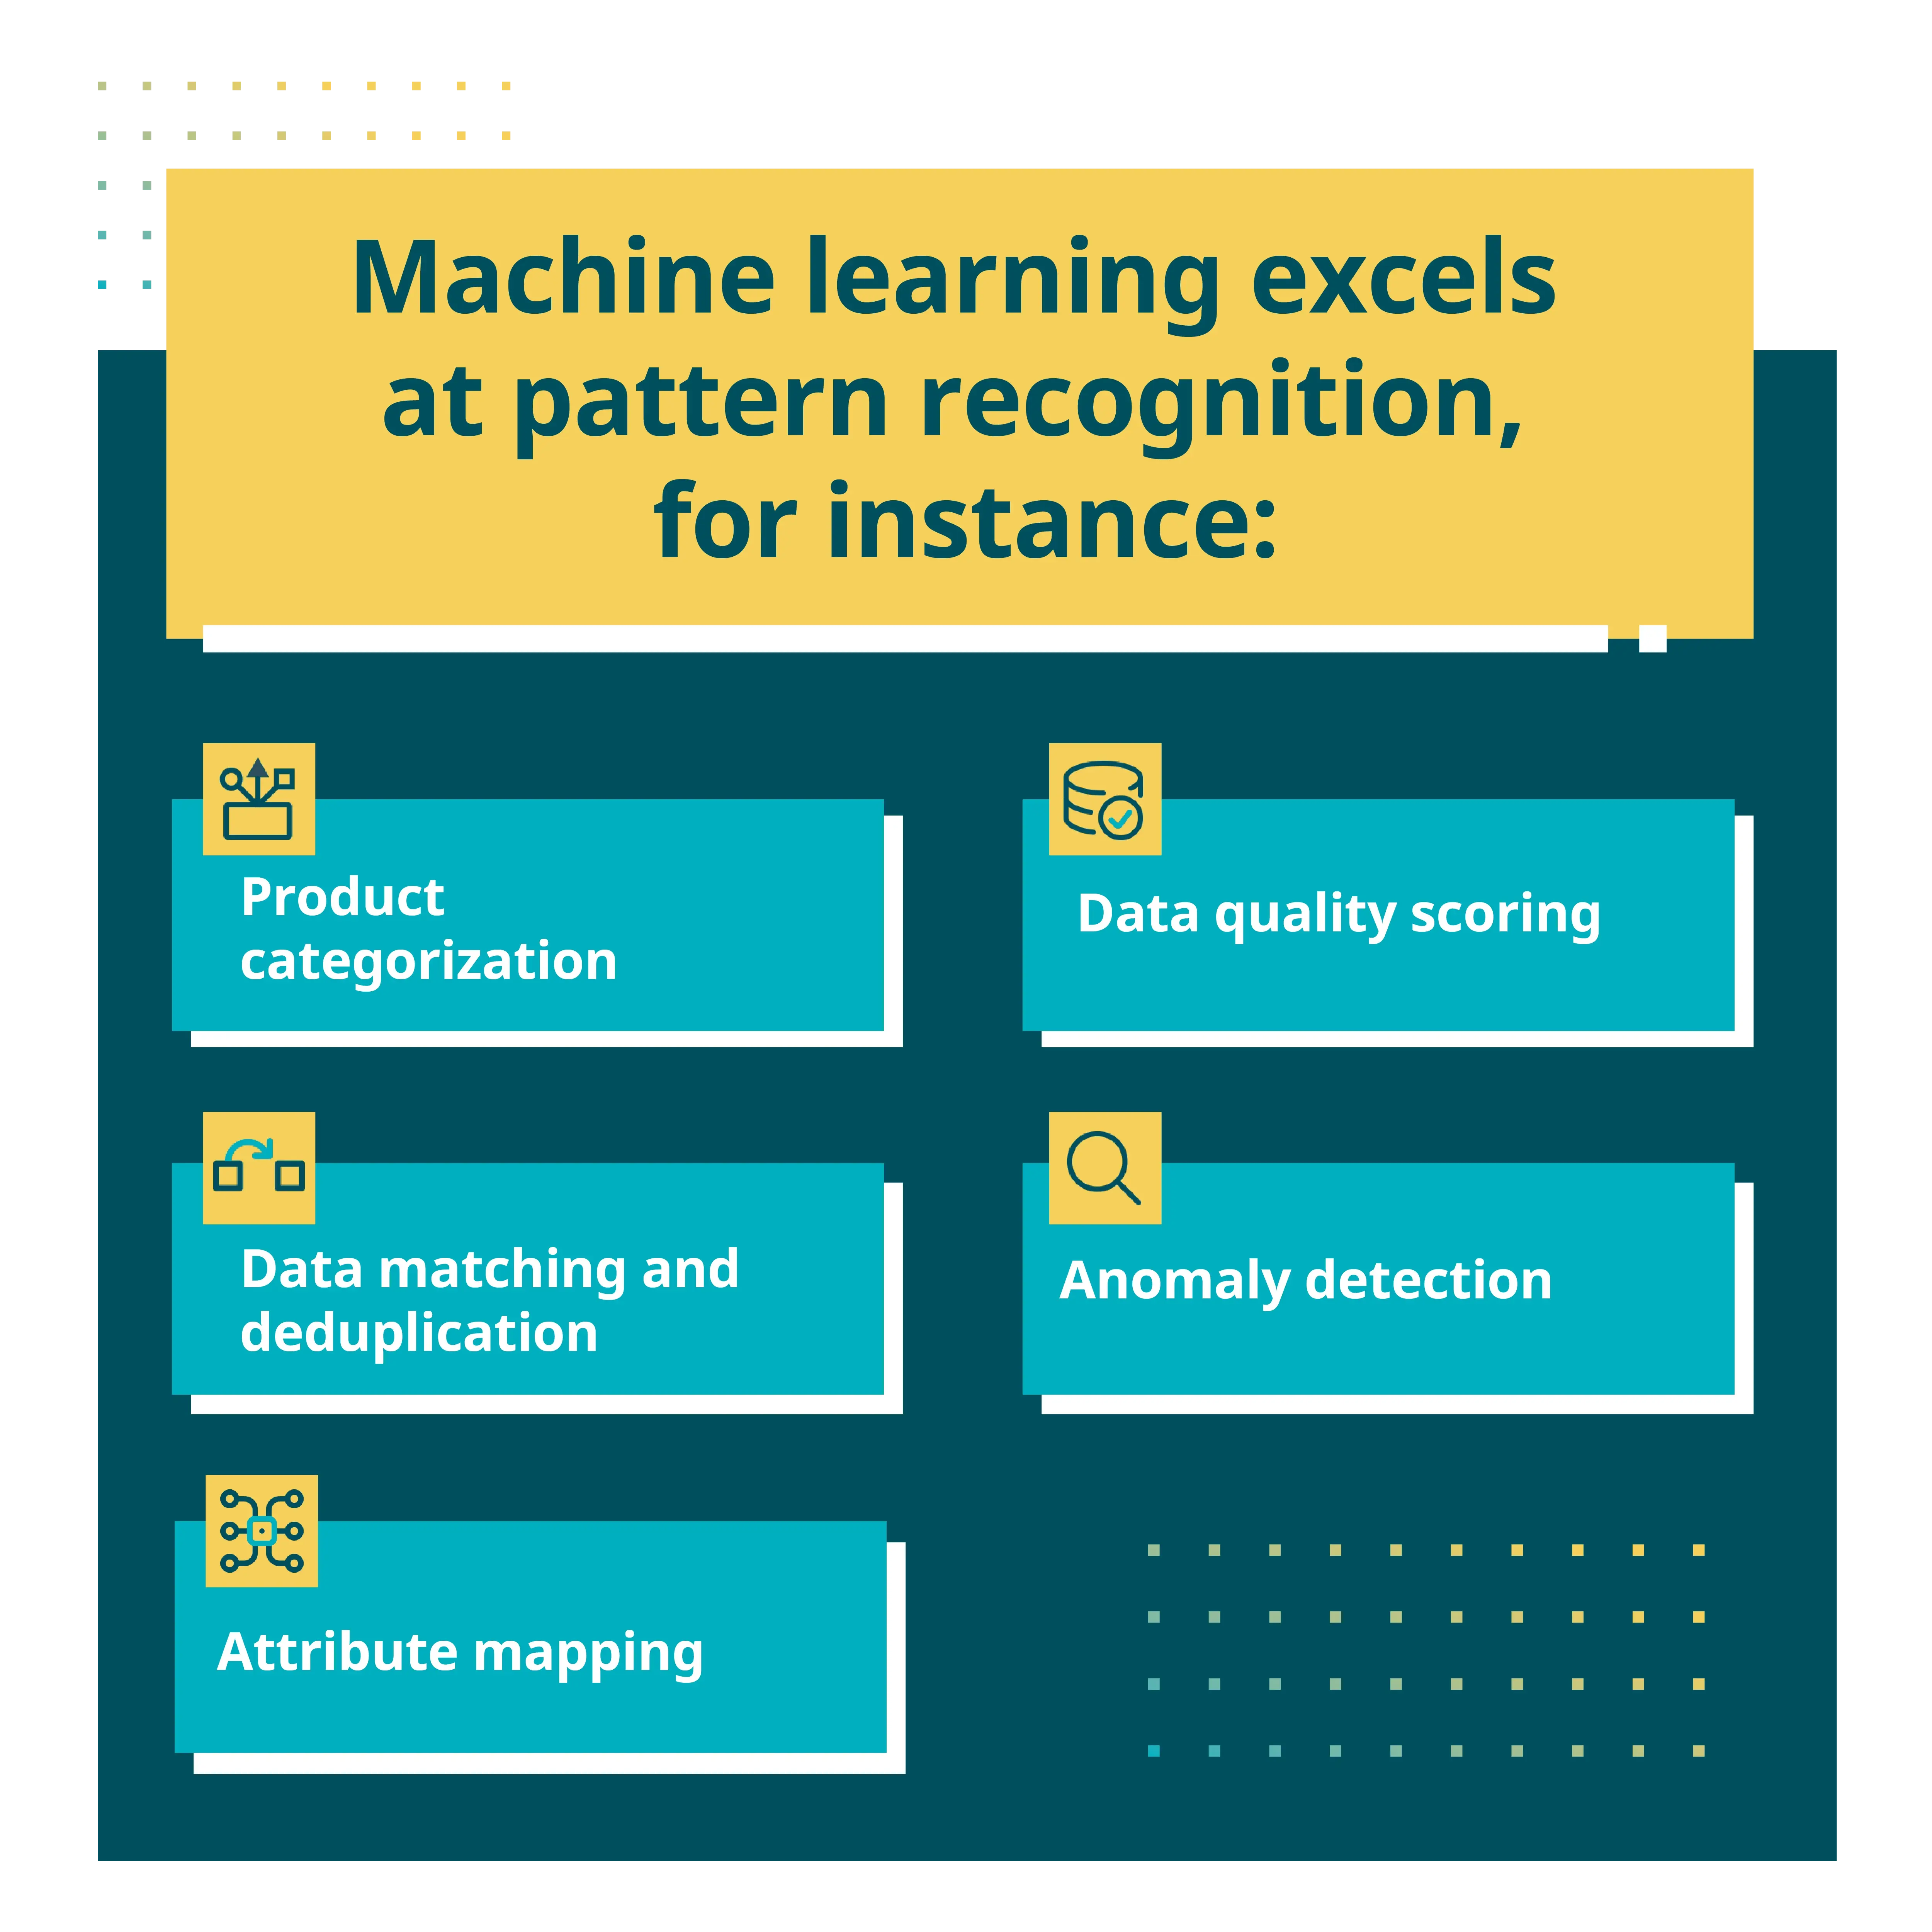
Em sua essência, o ML se destaca no reconhecimento de padrões, na categorização e na previsão – exatamente o que você precisa ao gerenciar grandes volumes de dados complexos. Veja estes exemplos:
-
Categorização de produtos
Atribuir automaticamente novos produtos às categorias corretas em sua taxonomia. -
Correspondência e deduplicação de dados
Identificação de casos em que registros diferentes representam a mesma entidade do mundo real. -
Mapeamento de atributos
Associar atributos específicos do fornecedor ao seu modelo de dados padronizado. -
Avaliação da qualidade dos dados
Previsão dos níveis de integridade e precisão sem revisão manual. -
Detecção de anomalias
Identificação de padrões de dados incomuns que possam indicar erros ou oportunidades.
Os ganhos de eficiência podem ser notáveis. Tarefas que antes levavam dias podem ser concluídas em minutos. E não se trata apenas de velocidade:
O ML traz consistência
A categorização humana varia naturalmente entre indivíduos e até mesmo pela mesma pessoa em momentos diferentes. O ML aplica a mesma lógica de forma consistente (estatisticamente). Você limita a variabilidade que causa problemas nos dados em etapas posteriores.
O ML se adapta à medida que sua empresa evolui
Com sistemas tradicionais baseados em regras, é necessário reprogramar explicitamente quando as condições do seu negócio mudam. Os modelos de ML, por outro lado, podem identificar padrões em constante mudança nos seus dados e se ajustar de acordo com eles. Essa adaptabilidade significa que seus processos de gerenciamento de dados permanecem atualizados com intervenção mínima.
Mas esses benefícios vêm com uma ressalva importante: as previsões são tão boas quanto a precisão do modelo. E é aí que muitas equipes de gerenciamento de dados encontram um obstáculo em sua jornada de automação.
Se você não puder confiar no seu ML, tudo desmorona
As previsões de ML vêm com uma incerteza inerente. Embora os modelos de ML sejam bons em reconhecer padrões, eles não oferecem a certeza de uma prova matemática. Isso cria um desafio de confiança que pode limitar significativamente o potencial de automação.
O dilema da precisão
Todo modelo de ML produz algum nível de imprecisão, que geralmente se manifesta de duas formas:
- Falsos negativos, em que correspondências válidas não são reconhecidas
- Falsos positivos, em que correspondências incorretas são feitas
Para o gerenciamento de dados, os falsos positivos representam o maior problema. Quando um modelo categoriza incorretamente um produto ou associa erroneamente dois clientes diferentes, esses erros se propagam pelos seus sistemas, gerando problemas de qualidade de dados que podem afetar as operações comerciais.
A automação parcial não é suficiente
Muitas organizações respondem a esse desafio com uma abordagem híbrida: usar o ML para o processamento inicial e, em seguida, revisar manualmente os resultados. Embora ainda seja melhor do que processos totalmente manuais, essa abordagem:
- Cria gargalos na revisão durante períodos de alto volume
- Ainda requer recursos humanos significativos
- Limita as vantagens de escalabilidade que você busca com o ML
- Atrasa processos sensíveis ao tempo
A lacuna na verificação
A questão central não é que o ML cometa erros – é a falta de um mecanismo confiável para verificar em quais previsões você pode confiar.
Sem saber quais previsões são certamente corretas, você é forçado a verificar tudo ou aceitar um certo nível de erro em seus dados mestres.
Essa lacuna de verificação representa a barreira crítica entre o processamento assistido e a verdadeira automação. E, para preencher essa lacuna, você precisa de uma abordagem fundamentalmente diferente, que combine os recursos de reconhecimento de padrões do ML com métodos capazes de fornecer certeza matemática sobre a precisão das previsões.
Afinal: você não precisa saber que seu modelo tem 95% de precisão no geral. Você precisa saber em quais 95% das previsões pode confiar.
Este é, de fato, um problema difícil de resolver — cuja natureza varia de acordo com os casos de uso. Mas, na Stibo Systems, somos incansáveis na resolução desses desafios e, para lidar com este, estamos começando pela verificação das recomendações de classificação da assistência de IA — também conhecida na pesquisa como mapeamento ontológico (de classificação).
Como incorporar mecanismos de verificação matemática ao seu modelo de aprendizado de máquina
Nossa pesquisa com a Universidade Técnica da Dinamarca (DTU) — uma das principais universidades técnicas da Europa, também considerada a melhor universidade técnica da Dinamarca — levou a uma abordagem inovadora.
Ela combina a velocidade do ML com a certeza da verificação matemática.
Os desafios de verificação que estamos resolvendo
Ao usar IA para fazer o mapeamento entre sistemas de classificação – por exemplo, associar “Ferramentas manuais” em uma taxonomia de produtos a “Ferramentas portáteis” em outra –, os modelos de ML podem fazer previsões impressionantes.
Mas essas previsões sempre trazem incerteza estatística que pode minar a confiança. E a confiança, nesse contexto, é meio que binária: ou você confia nos resultados, ou não confia (e precisa verificar novamente).
A questão principal é a consistência. Como você pode verificar se as relações de mapeamento fazem sentido lógico em todas as estruturas de classificação?
A certeza matemática encontra a aplicação prática
Em nossa solução, aplicamos métodos matemáticos formais para validar se os mapeamentos recomendados são logicamente consistentes. A prova matemática confirma quais previsões estão corretas, e não apenas estatisticamente prováveis.
Para isso, utilizamos especificamente a lógica proposicional e as “cláusulas de Horn”.
O que são cláusulas de Horn?
Elas podem parecer complexas, mas são simplesmente afirmações lógicas que seguem um padrão “se-então”. Por exemplo: “se um produto é um martelo E os martelos pertencem às ferramentas manuais, ENTÃO o produto pertence às ferramentas manuais”. Ao aplicar essas regras lógicas em todos os sistemas de classificação, podemos verificar matematicamente se os mapeamentos fazem sentido.
Mas você pode se perguntar: se os métodos formais oferecem a certeza de que precisamos, por que usar ML?
A resposta está na eficiência computacional. Aplicar apenas métodos formais a grandes estruturas de classificação seria computacionalmente oneroso demais para uso prático.
Ao combinar as abordagens, obtemos o melhor dos dois mundos:
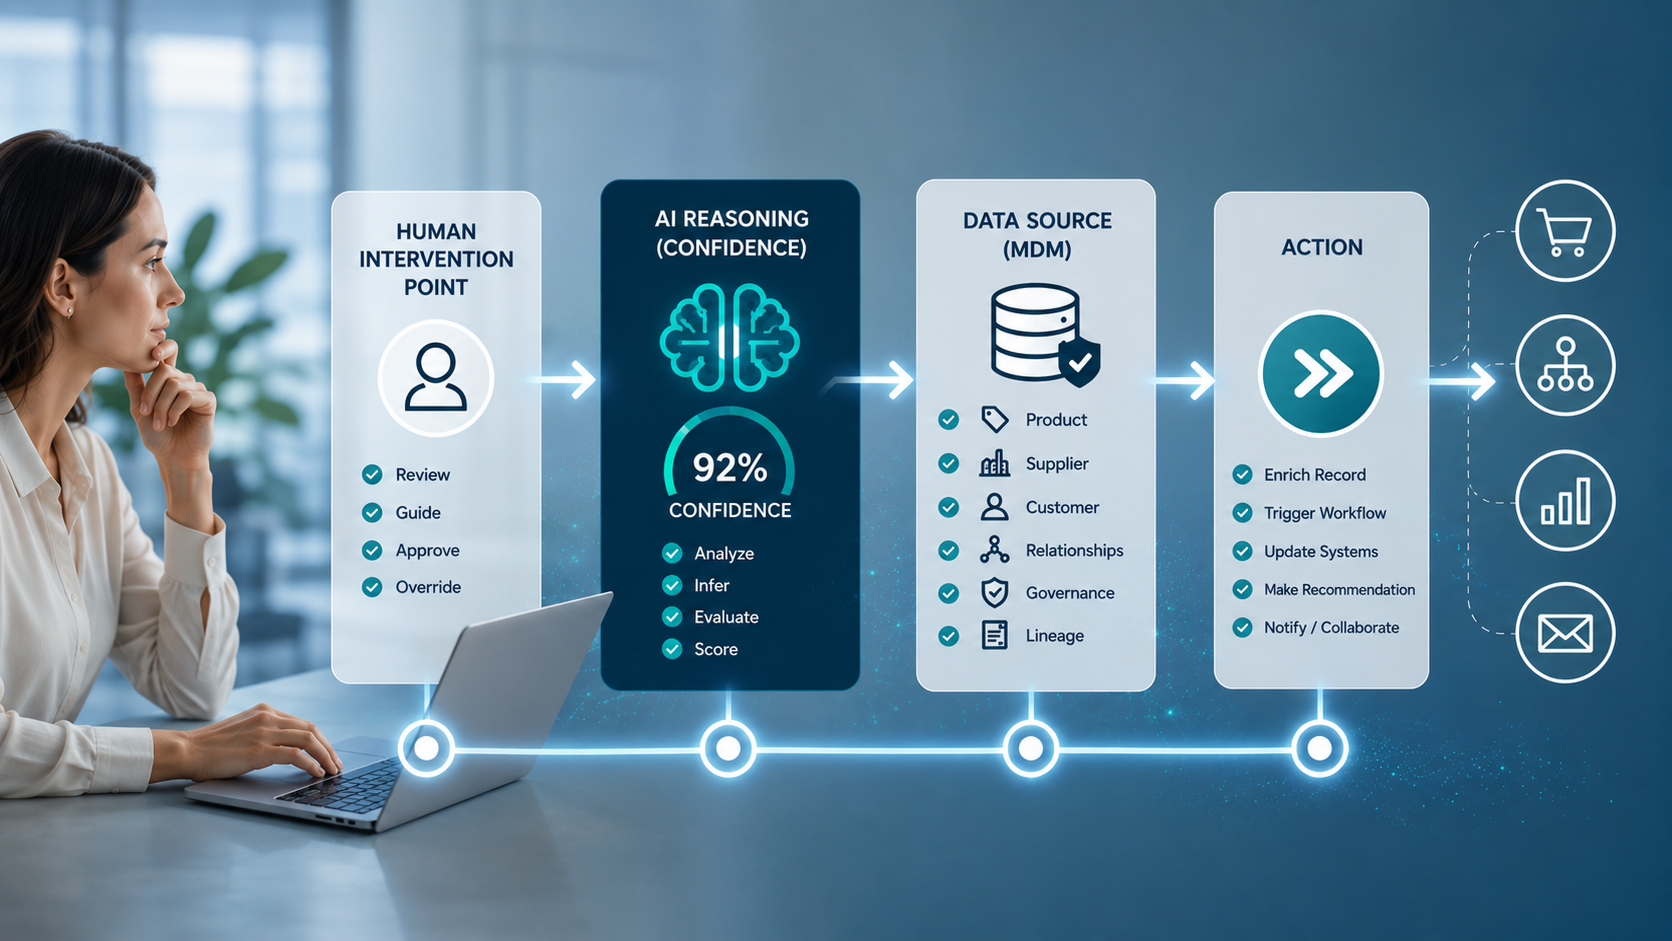
- Previsões rápidas de ML reduzem as possibilidades de mapeamento.
- A verificação matemática confirma quais previsões estão definitivamente corretas.
- Apenas as previsões incertas precisam de revisão humana.
A abordagem híbrida reduz drasticamente a carga de trabalho de verificação, mantendo a precisão, o que torna possível a verdadeira automação.
Entenda tudo isso em um nível mais profundo: este trabalho foi publicado em “The Practice of Formal Methods”, um ensaio em homenagem a Cliff Jones.
Na Stibo Systems, estamos aplicando isso na prática
Os fundamentos matemáticos são sólidos como uma rocha – a lógica formal é correta ou incorreta, sem meio-termo. A parte empolgante envolve aplicar esses princípios aos desafios reais do MDM.
Nossa implementação atualmente se concentra em cenários de alto volume, nos quais a verificação gera gargalos significativos.
Por exemplo, para varejistas que incorporam milhares de itens de fornecedores regularmente, a capacidade de validar automaticamente as categorizações sugeridas pela IA gera um valor imenso ao longo de todo o processo.
Mas trabalhamos com empresas em diversos setores, com casos de uso em potencial em todas as áreas:
- Empresas de serviços financeiros que mapeiam categorias de transações entre diferentes sistemas
- Organizações da área da saúde que alinham taxonomias de codificação médica
- Empresas de manufatura que padronizam classificações de peças de vários fornecedores
- Órgãos do setor público que harmonizam categorias de serviços entre departamentos
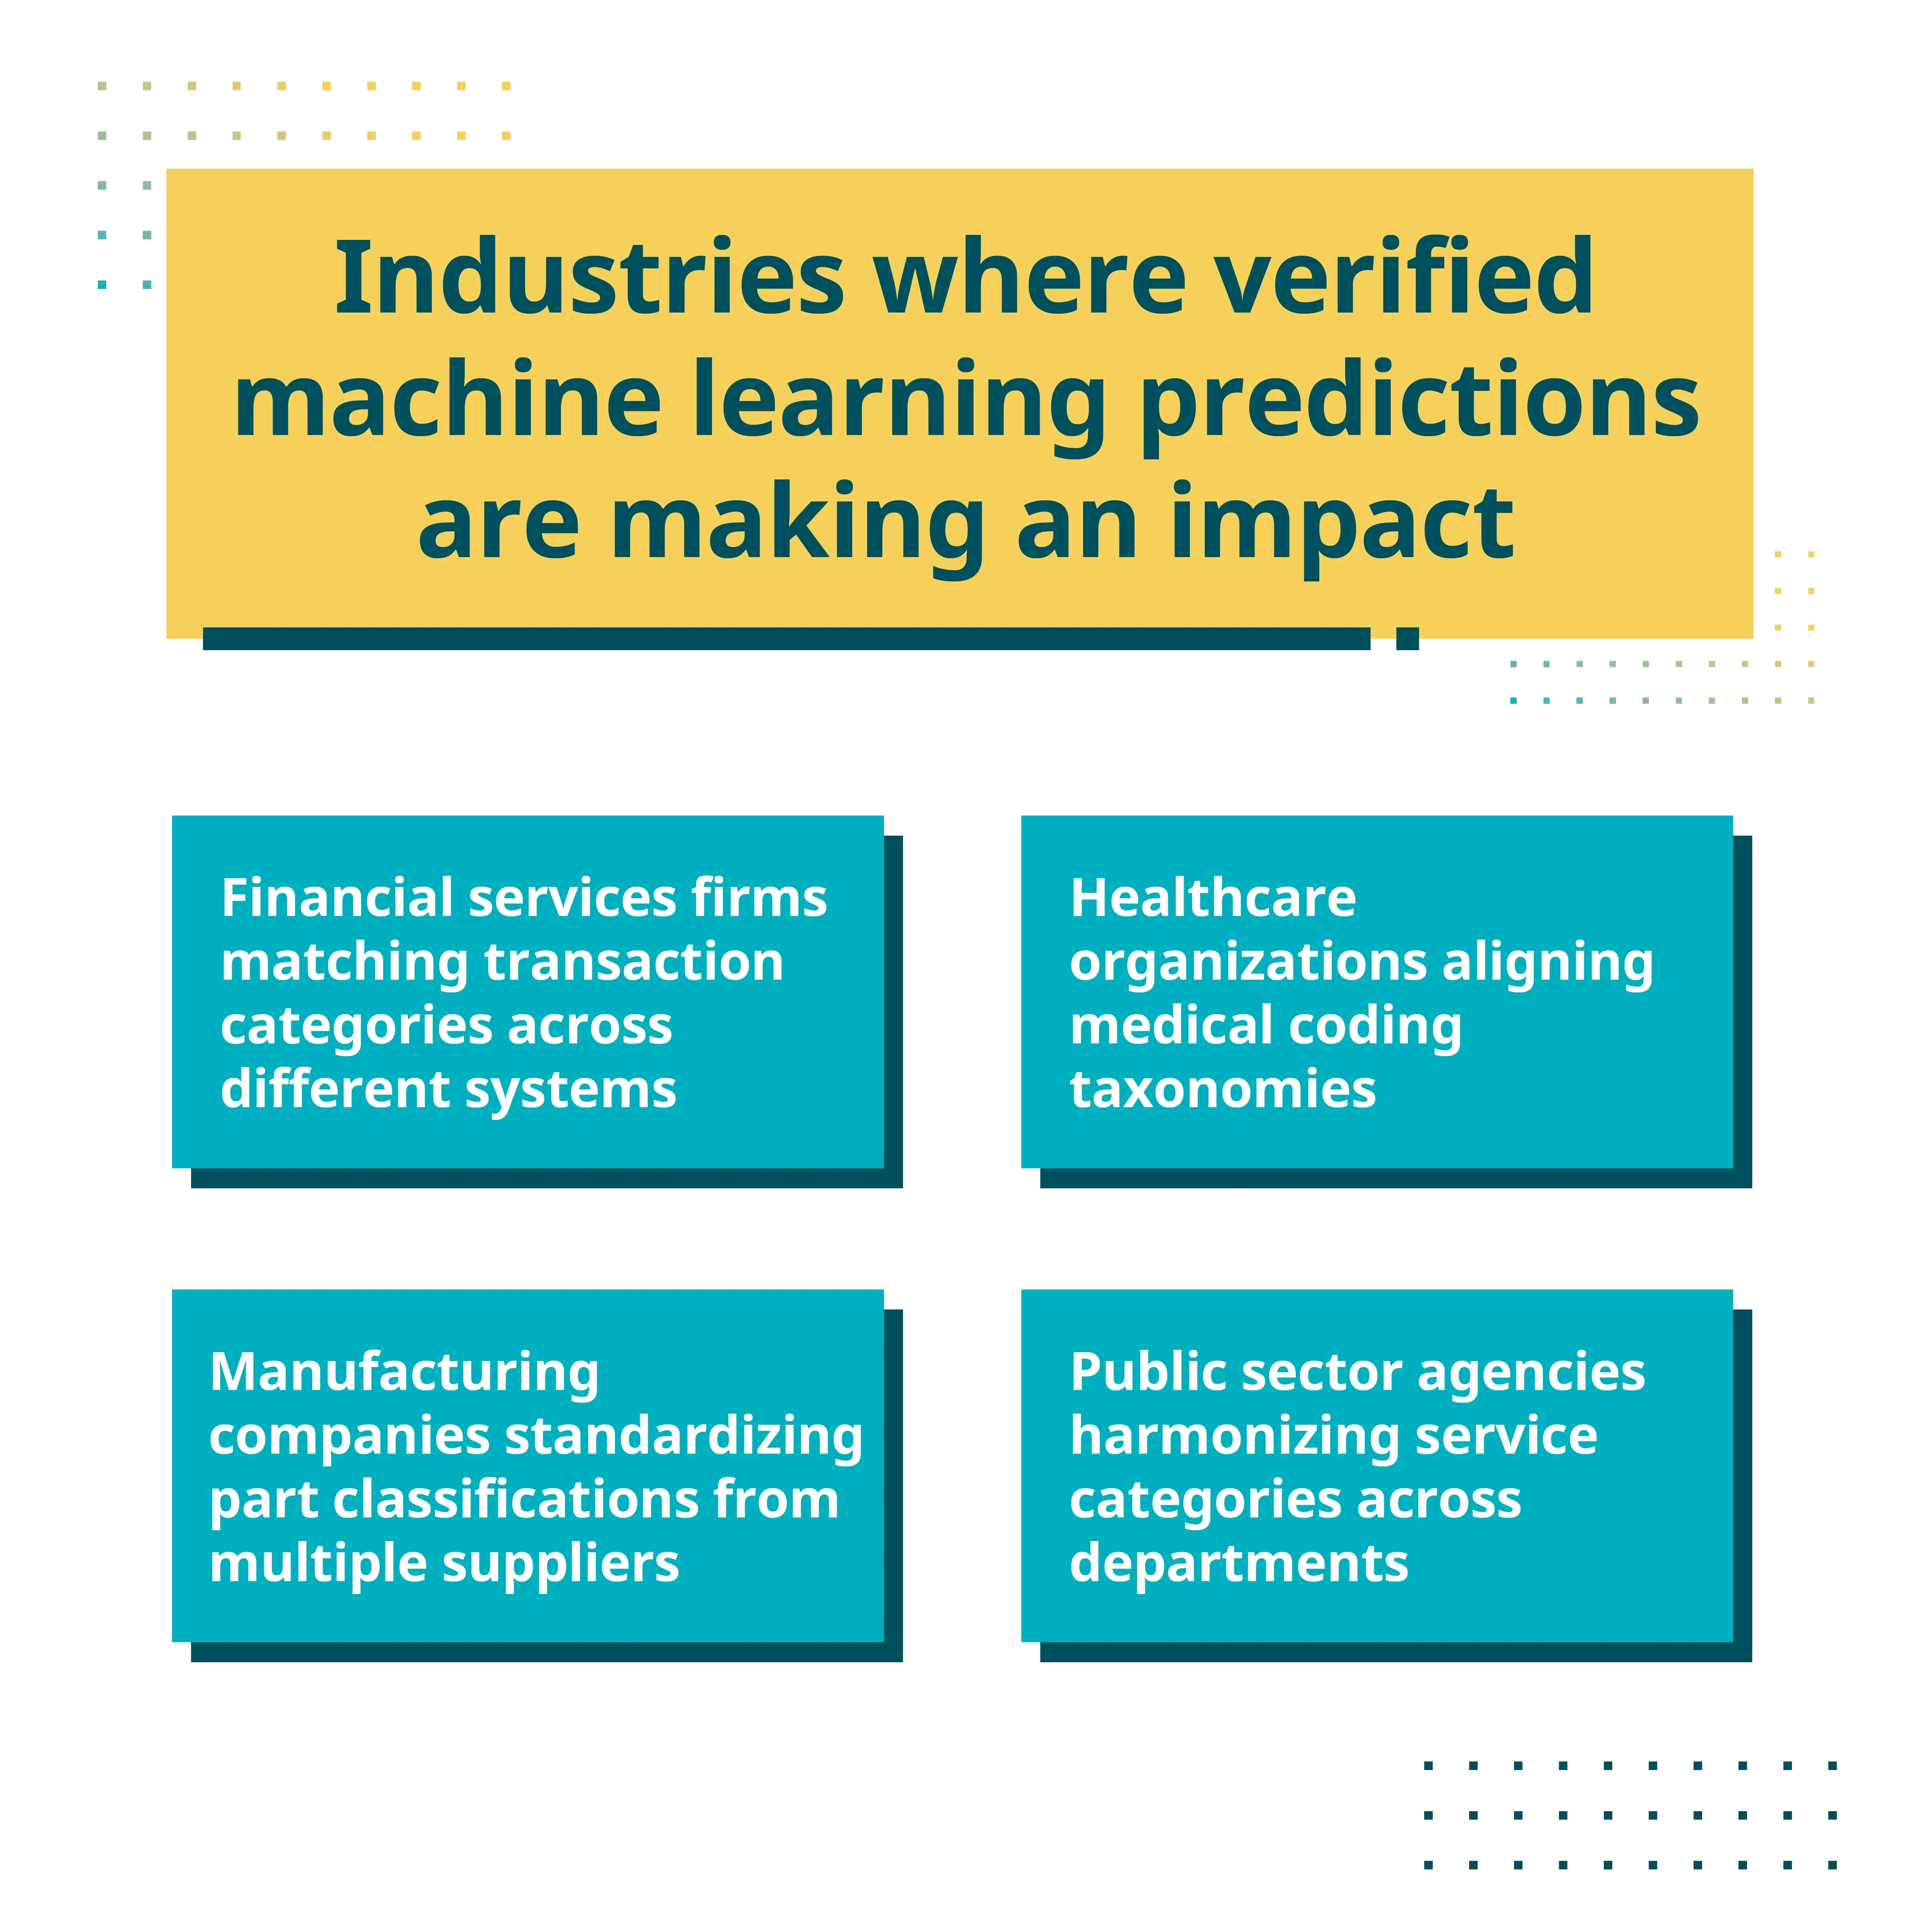
Qualquer situação que envolva alinhamento de taxonomias, correspondência de classificações ou padronização entre sistemas pode se beneficiar de previsões verificadas.
Situação atual de nossa implementação
No momento, estamos testando protótipos em ambientes reais.
Embora ainda estejamos no início da implementação, a verificação matemática funciona exatamente como esperado – ela identifica corretamente quais previsões são confiáveis. A próxima fase envolve aprimorar a experiência do usuário e expandir os recursos de verificação para mais cenários de gerenciamento de dados.
Vamos resumir
A confiança continua sendo o maior obstáculo para a verdadeira automação no gerenciamento de dados. Nossa combinação de aprendizado de máquina (ML) com verificação matemática nos oferece um caminho prático a seguir, que não obriga você a escolher entre velocidade e precisão.
O papel humano sempre será importante no gerenciamento de dados, mas agora podemos direcionar essa expertise para onde ela agrega mais valor – e não para tarefas rotineiras que a IA verificada pode realizar de forma confiável.
Quando você puder confiar nas previsões do ML, poderá finalmente automatizar com confiança.
Gestão de Dados Mestres Potenciada por IA
Desbloqueie o poder da IA em seus processos de MDM para navegar nas dinâmicas complexas da cadeia de suprimentos com maior agilidade e previsibilidade.