大規模な組織において、マスターデータ管理(MDM)に携わっている場合、サプライヤーデータの流れ、規制順守、サステナビリティ指標、マーケットプレイスでの情報共有などに常に頭を悩ませつつ、コストを抑え、満足度を高め続けなければなりません。
機械学習(ML)を活用すれば、反復的で時間のかかるタスクを驚異的なスピードで自動化できますが、AIの予測を信頼することには大きな課題が伴います。
MLモデルが製品に対して誤ったカテゴリを提案したり、関係性を誤って識別したりすると、それらのエラーが下流に問題を引き起こし、効率化の成果を台無しにしてしまう可能性があります。
結局のところ、AIの判断をすべて手作業で検証しなければならないとしたら、本当にリソースを節約できていると言えるでしょうか?
Stibo Systemsでは、MLのスピードと数学的な検証を組み合わせることで、ビジネスに必要な精度レベルを保ちながら、真の自動化を実現できるようにしています。
このブログ記事では、私たちがどのようにしてそこに至ったのか、そしてそれがどのように機能するのかについてお伝えします。背景と重要なポイントの両方をご理解いただけるでしょう。
なぜMDMに機械の支援が必要なのでしょうか?
データ管理の業務負荷は、それを処理する能力よりも速いペースで増大しているように感じられるでしょう。そう感じているのはあなただけではありません。今日のデータ管理者は、正確性、スピード、データ量がすべて優先順位を競い合う複雑な状況の中で業務を進めています。
- データ形式や品質が統一されていないサプライヤーからの膨大な商品ラインナップの取り込み
- システム間でデータの信頼性を維持するためのガバナンスプロセスの運用
- 絶えず変化する規制要件への準拠を維持すること
- 増え続けるサステナビリティおよびESGデータ項目の管理
- クリーンで一貫性のあるデータをさまざまなチャネルやマーケットプレイスに配信すること
これらの課題に対する従来のアプローチは、多くの場合、手作業によるプロセス、ビジネスルール、および人による検証に大きく依存しています。
小規模な範囲であればこれで機能する場合もありますが、データ量が増加するとボトルネックが発生します。かつては1日あたり50件の新規項目を検証できていたプロダクトマネージャーも、今では数千件単位のバッチを処理しなければならず、手動によるレビューは現実的ではなくなっています。
これは単に時間を節約するだけでなく、競争優位性を維持することにもつながります。競合他社が新製品の登録をより迅速に行い、情報の更新をより速く行い、データをより効果的に配信できれば、彼らは市場において決定的な優位性を獲得することになります。手作業によるプロセスでは、多大なリソースを投入しない限り、こうした需要に対応できる規模への拡張は不可能です。
こうした課題が技術的な介入に特に適している理由は、その反復的でパターンに基づいた性質にあります。多くの場合、類似点を認識し、一貫したルールを適用し、証拠に基づいた意思決定を行うことが求められます。
まさに、機械学習(ML)が得意とする業務です。
MLがどのようにゲームチェンジをもたらしたか
MLは、データ管理において最も労力を要するタスクに完璧に適合します。
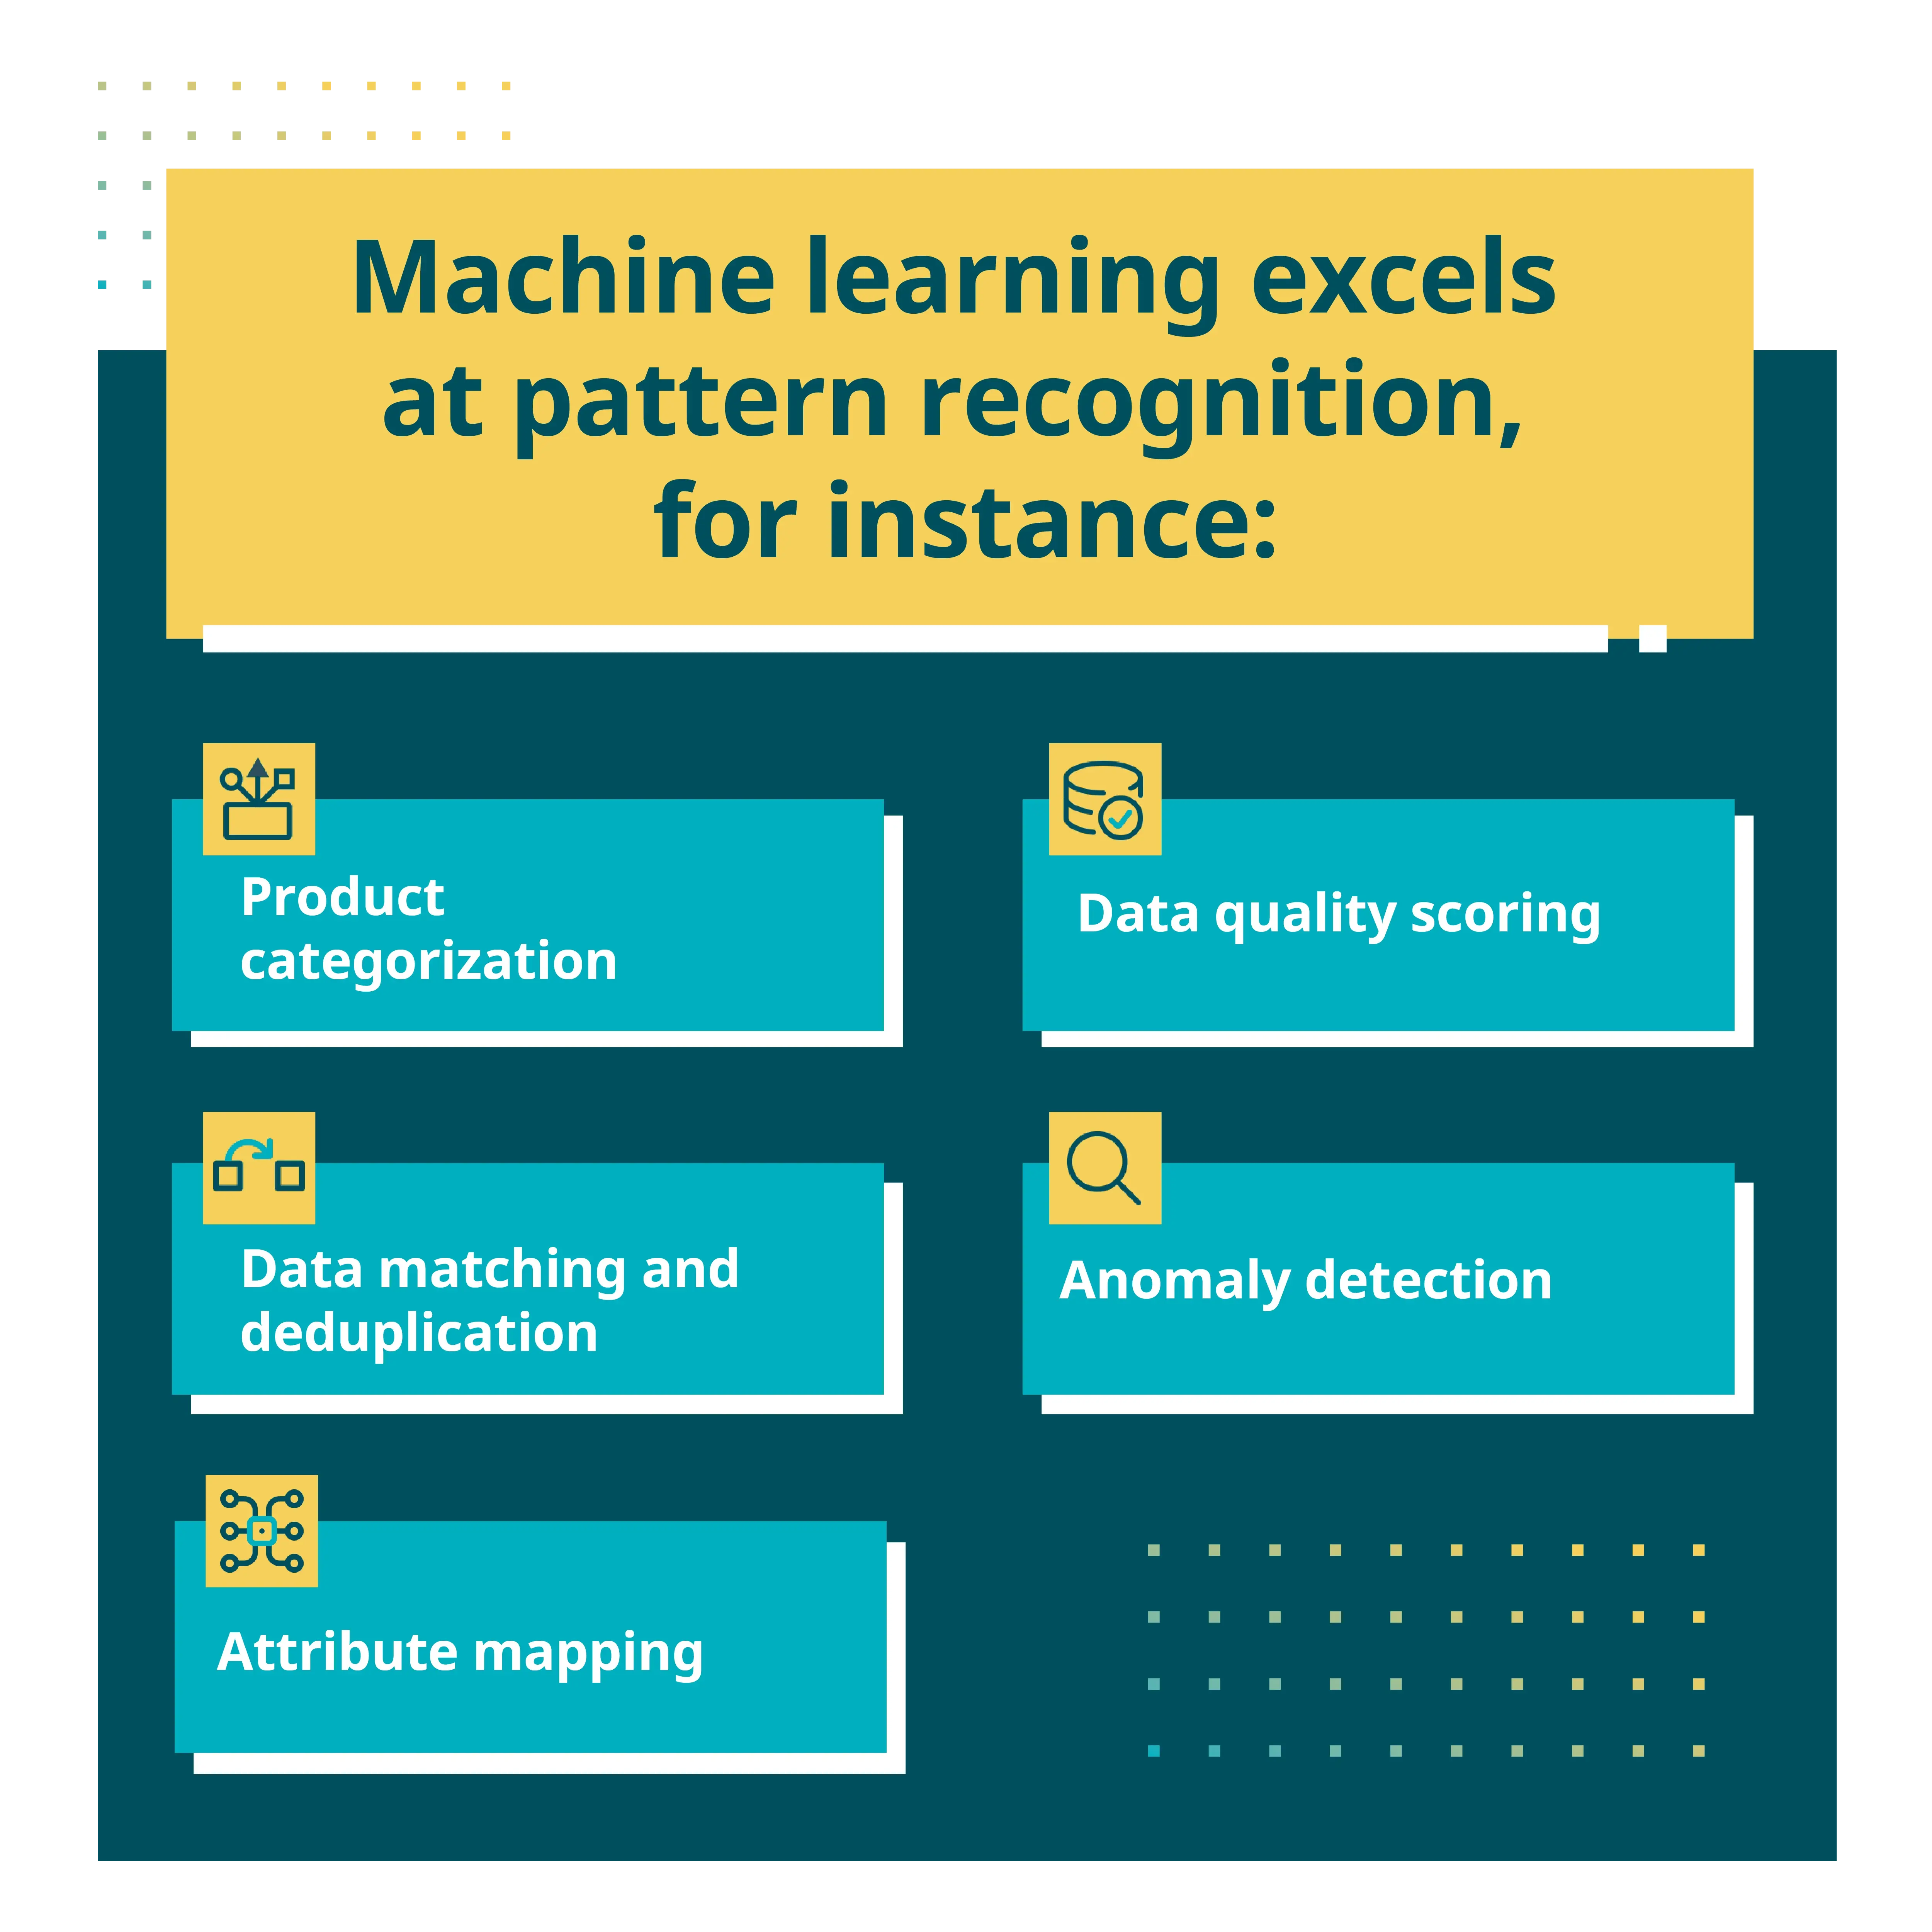
本質的に、MLはパターン認識、分類、予測に優れており、これらはまさに大量の複雑なデータを管理する際に必要とされる能力です。例えば、次のようなケースが挙げられます:
-
製品の分類
新しい製品を、分類体系内の適切なカテゴリに自動的に割り当てること。 -
データの照合と重複排除
異なるレコードが現実世界の同一の実体を表しているかどうかを特定します。 -
属性のマッピング
サプライヤー固有の属性を、標準化されたデータモデルに関連付けること。 -
データ品質スコアリング
手動によるレビューを行わずに、データの完全性と正確性のレベルを予測します。 -
異常検出
エラーや改善の機会を示唆する可能性のある、異常なデータパターンを特定します。
効率の向上は目覚ましいものとなります。かつては数日かかっていた作業も、数分で完了できるようになります。そして、それは単にスピードの向上だけではありません:
MLは一貫性をもたらす
人間による分類は、当然ながら個人によって、さらには同じ人であっても時期によってばらつきが生じます。MLは(統計的に)一貫して同じロジックを適用します。これにより、下流のデータ処理で問題を引き起こすばらつきを抑制できます。
MLはビジネスの進化に合わせて適応します
従来のルールベースのシステムでは、ビジネス環境が変化した際に、明示的な再プログラミングが必要となります。一方、MLモデルはデータ内の変化するパターンを検知し、それに応じて調整することができます。この適応性により、最小限の介入でデータ管理プロセスを常に最新の状態に保つことができます。
しかし、これらのメリットには重要な注意点があります。予測の精度は、モデルの精度に左右されるということです。そして、多くのデータ管理チームが自動化の道のりで壁にぶつかるのは、まさにこの点なのです。
MLを信頼できなければ、すべてが台無しになる
MLによる予測には、本質的な不確実性が伴います。MLモデルはパターンの認識には優れていますが、数学的証明のような確実性を提供してくれるわけではありません。これにより信頼性の課題が生じ、自動化の可能性を著しく制限する恐れがあります。
精度のジレンマ
どのMLモデルにもある程度の不正確さが伴い、それは通常、次の2つの形で現れます:
- 「偽陰性」:有効な一致が認識されない場合
- 偽陽性:誤った一致が判定される
データ管理において、偽陽性はより大きな問題を引き起こします。モデルが製品を誤って分類したり、異なる2人の顧客を誤って結びつけたりすると、これらのエラーはシステム全体に波及し、業務運営に影響を及ぼす可能性のあるデータ品質の問題を引き起こします。
部分的な自動化では不十分
多くの組織は、この課題に対してハイブリッドなアプローチを採用しています。つまり、初期処理に機械学習(ML)を使用し、その結果を手動でレビューするというものです。完全に手作業によるプロセスよりは優れていますが、このアプローチには次のような問題があります:
- 処理量が集中する時期には、レビューのボトルネックが生じる
- 依然として多大な人的リソースを必要とする
- MLに期待されるスケーラビリティの利点を制限してしまう
- 時間的制約のあるプロセスの遅延を招く
検証のギャップ
根本的な問題は、MLが誤りを犯すことではなく、どの予測を信頼できるかを確認するための信頼性の高いメカニズムが欠如している点にあります。
どの予測が確実に正しいのかが分からなければ、すべてを検証するか、マスターデータにある程度の誤差を容認せざるを得なくなります。
この検証のギャップこそが、支援型処理と真の自動化との間の重大な障壁となっています。そして、このギャップを埋めるには、MLのパターン認識能力と、予測精度について数学的な確実性を提供できる手法とを組み合わせた、根本的に異なるアプローチが必要です。
結局のところ、モデル全体の精度が95%であるかどうかを知る必要はありません。信頼できる予測の95%がどれなのかを知る必要があるのです。
これは確かに取り組むのが難しい問題であり、ユースケースによってその性質も異なります。しかし、Stibo Systemsではこうした課題の解決にたゆまぬ努力を続けており、この問題に取り組むため、まずはAIアシスタンスによる分類推奨事項の検証から着手しています。これは研究分野では「オントロジー(分類)マッピング」としても知られています。
MLモデルに数学的な検証メカニズムを組み込む方法
ヨーロッパ有数の工科大学であり、デンマークで最高の工科大学にも選ばれているデンマーク工科大学(DTU)との共同研究により、画期的なアプローチが生まれました。
これは、MLのスピードと数学的検証の確実性を融合させたものです。
私たちが解決しようとしている検証上の課題
AI を使用して分類システム間のマッピングを行う場合(たとえば、ある製品分類体系の「手工具」を別の分類体系の「ハンドヘルドツール」に照合する場合など)、ML モデルは驚くほど正確な予測を行うことができます。
しかし、そうした予測には常に統計的な不確実性が伴い、信頼性を損なう恐れがあります。そして、この文脈における信頼性は、いわば二値的なものです。結果を信頼できるか、できないか(そして再確認が必要か)のどちらかです。
鍵となるのは一貫性です。分類構造全体を通じて、対応関係が論理的に妥当であることを、どのように検証すればよいのでしょうか?
数学的な確実性と実用的な応用
当社のソリューションでは、形式的な数学的手法を適用し、推奨されるマッピングが論理的に一貫していることを検証します。数学的証明により、単に統計的に可能性が高いだけでなく、どの予測が正しいかが確認されます。
このために、具体的には命題論理と「ホーン節」を用います。
ホーン節とは何でしょうか?
複雑に聞こえるかもしれませんが、これは単に「もし~なら」というパターンに従う論理的な命題です。例えば、「ある製品がハンマーであり、かつハンマーが手工具に属する場合、その製品は手工具に属する」といったものです。これらの論理ルールを分類システム全体に適用することで、マッピングが理にかなっているかどうかを数学的に検証することができます。
しかし、こう疑問に思うかもしれません。「形式的手法が必要な確実性を提供してくれるのなら、なぜわざわざ機械学習(ML)を使う必要があるのか?」
その答えは、計算効率にあります。大規模な分類構造に形式的手法のみを適用すると、計算コストが高すぎて実用には適しません。
両方のアプローチを組み合わせることで、双方の長所を最大限に活かすことができます:
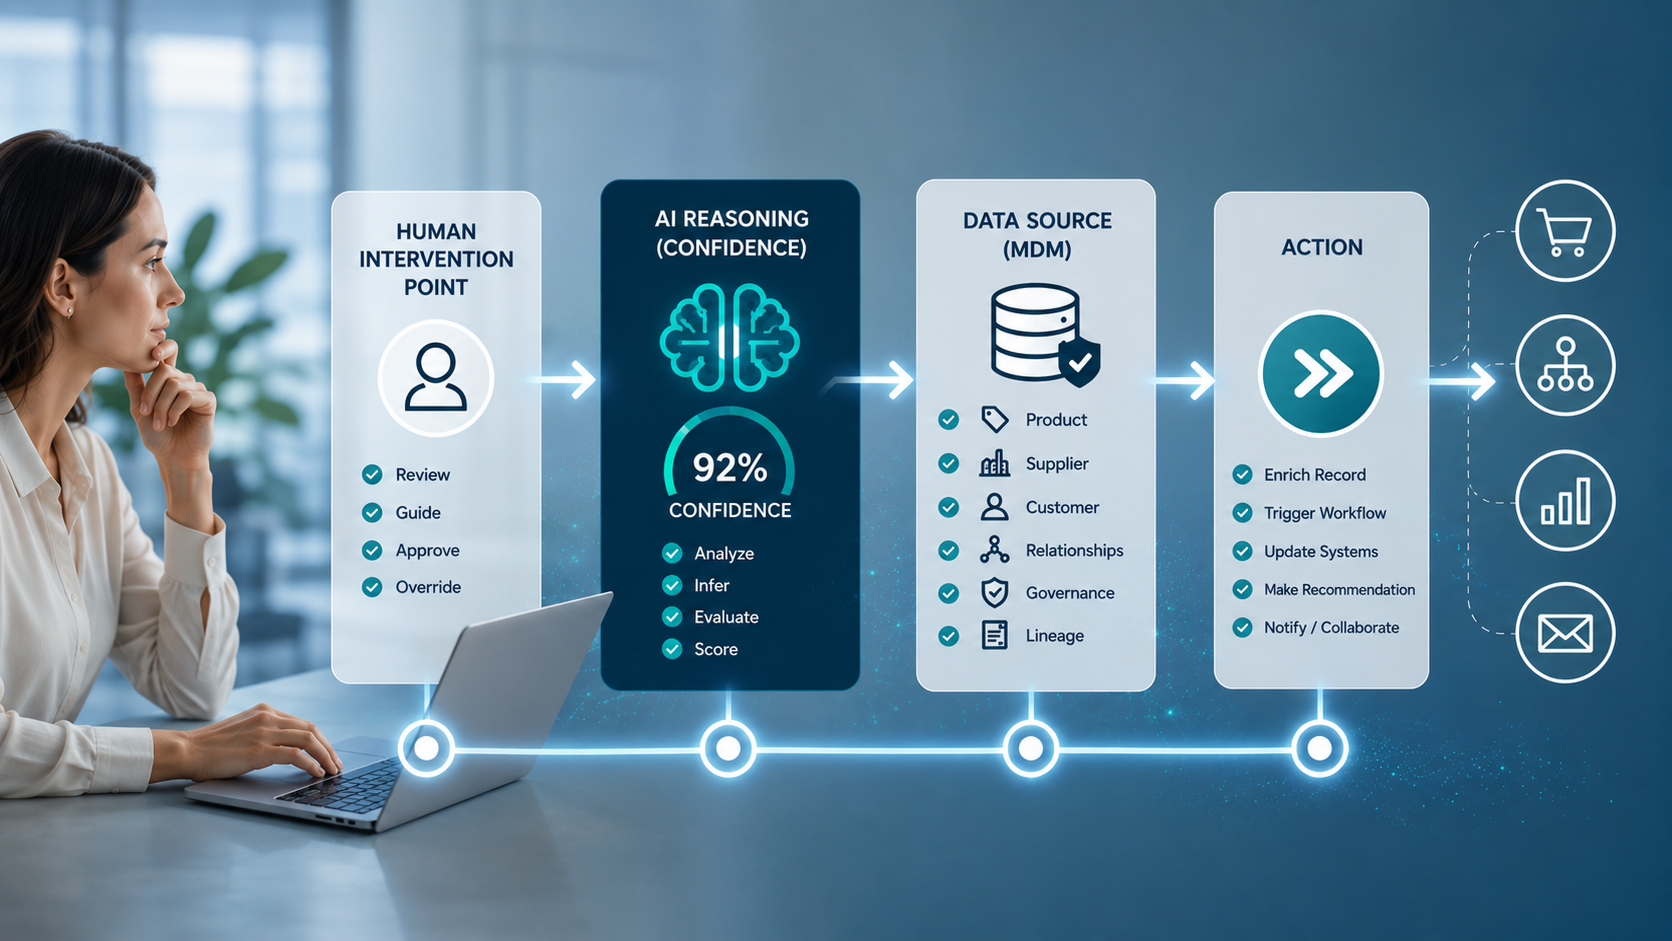
- 高速な機械学習による予測が、考えられるマッピングの候補を絞り込みます。
- 数学的検証により、どの予測が確実に正しいかを確認します。
- 不確実な予測のみが、人間による確認を必要とします。
このハイブリッドなアプローチにより、精度を維持しつつ検証の作業負荷を劇的に削減し、真の自動化を実現します。
これらについてより深く理解するには:本研究は、クリフ・ジョーンズ氏を称えるエッセイ集『The Practice of Formal Methods』に掲載されています。
Stibo Systemsでは、これを実際の業務に活用しています
その数学的基礎は揺るぎないものです。形式論理は正しいか間違っているかのいずれかであり、中間はありません。興味深いのは、これらの原則を現実世界の MDM の課題に適用することです。
現在、当社の実装は、検証が大きなボトルネックとなっている大量処理のシナリオに焦点を当てています。
たとえば、定期的に数千ものサプライヤー商品を登録する小売業者にとって、AI が提案した分類を自動的に検証できる機能は、プロセス全体を通じて多大な価値を生み出します。
しかし、当社は多くの業界の企業と提携しており、あらゆる分野で活用の可能性があります:
- 異なるシステム間で取引カテゴリを照合する金融サービス企業
- 医療コードの分類体系を整合させる医療機関
- 複数のサプライヤーからの部品分類を標準化する製造企業
- 部門間でサービスカテゴリを統一する公共機関
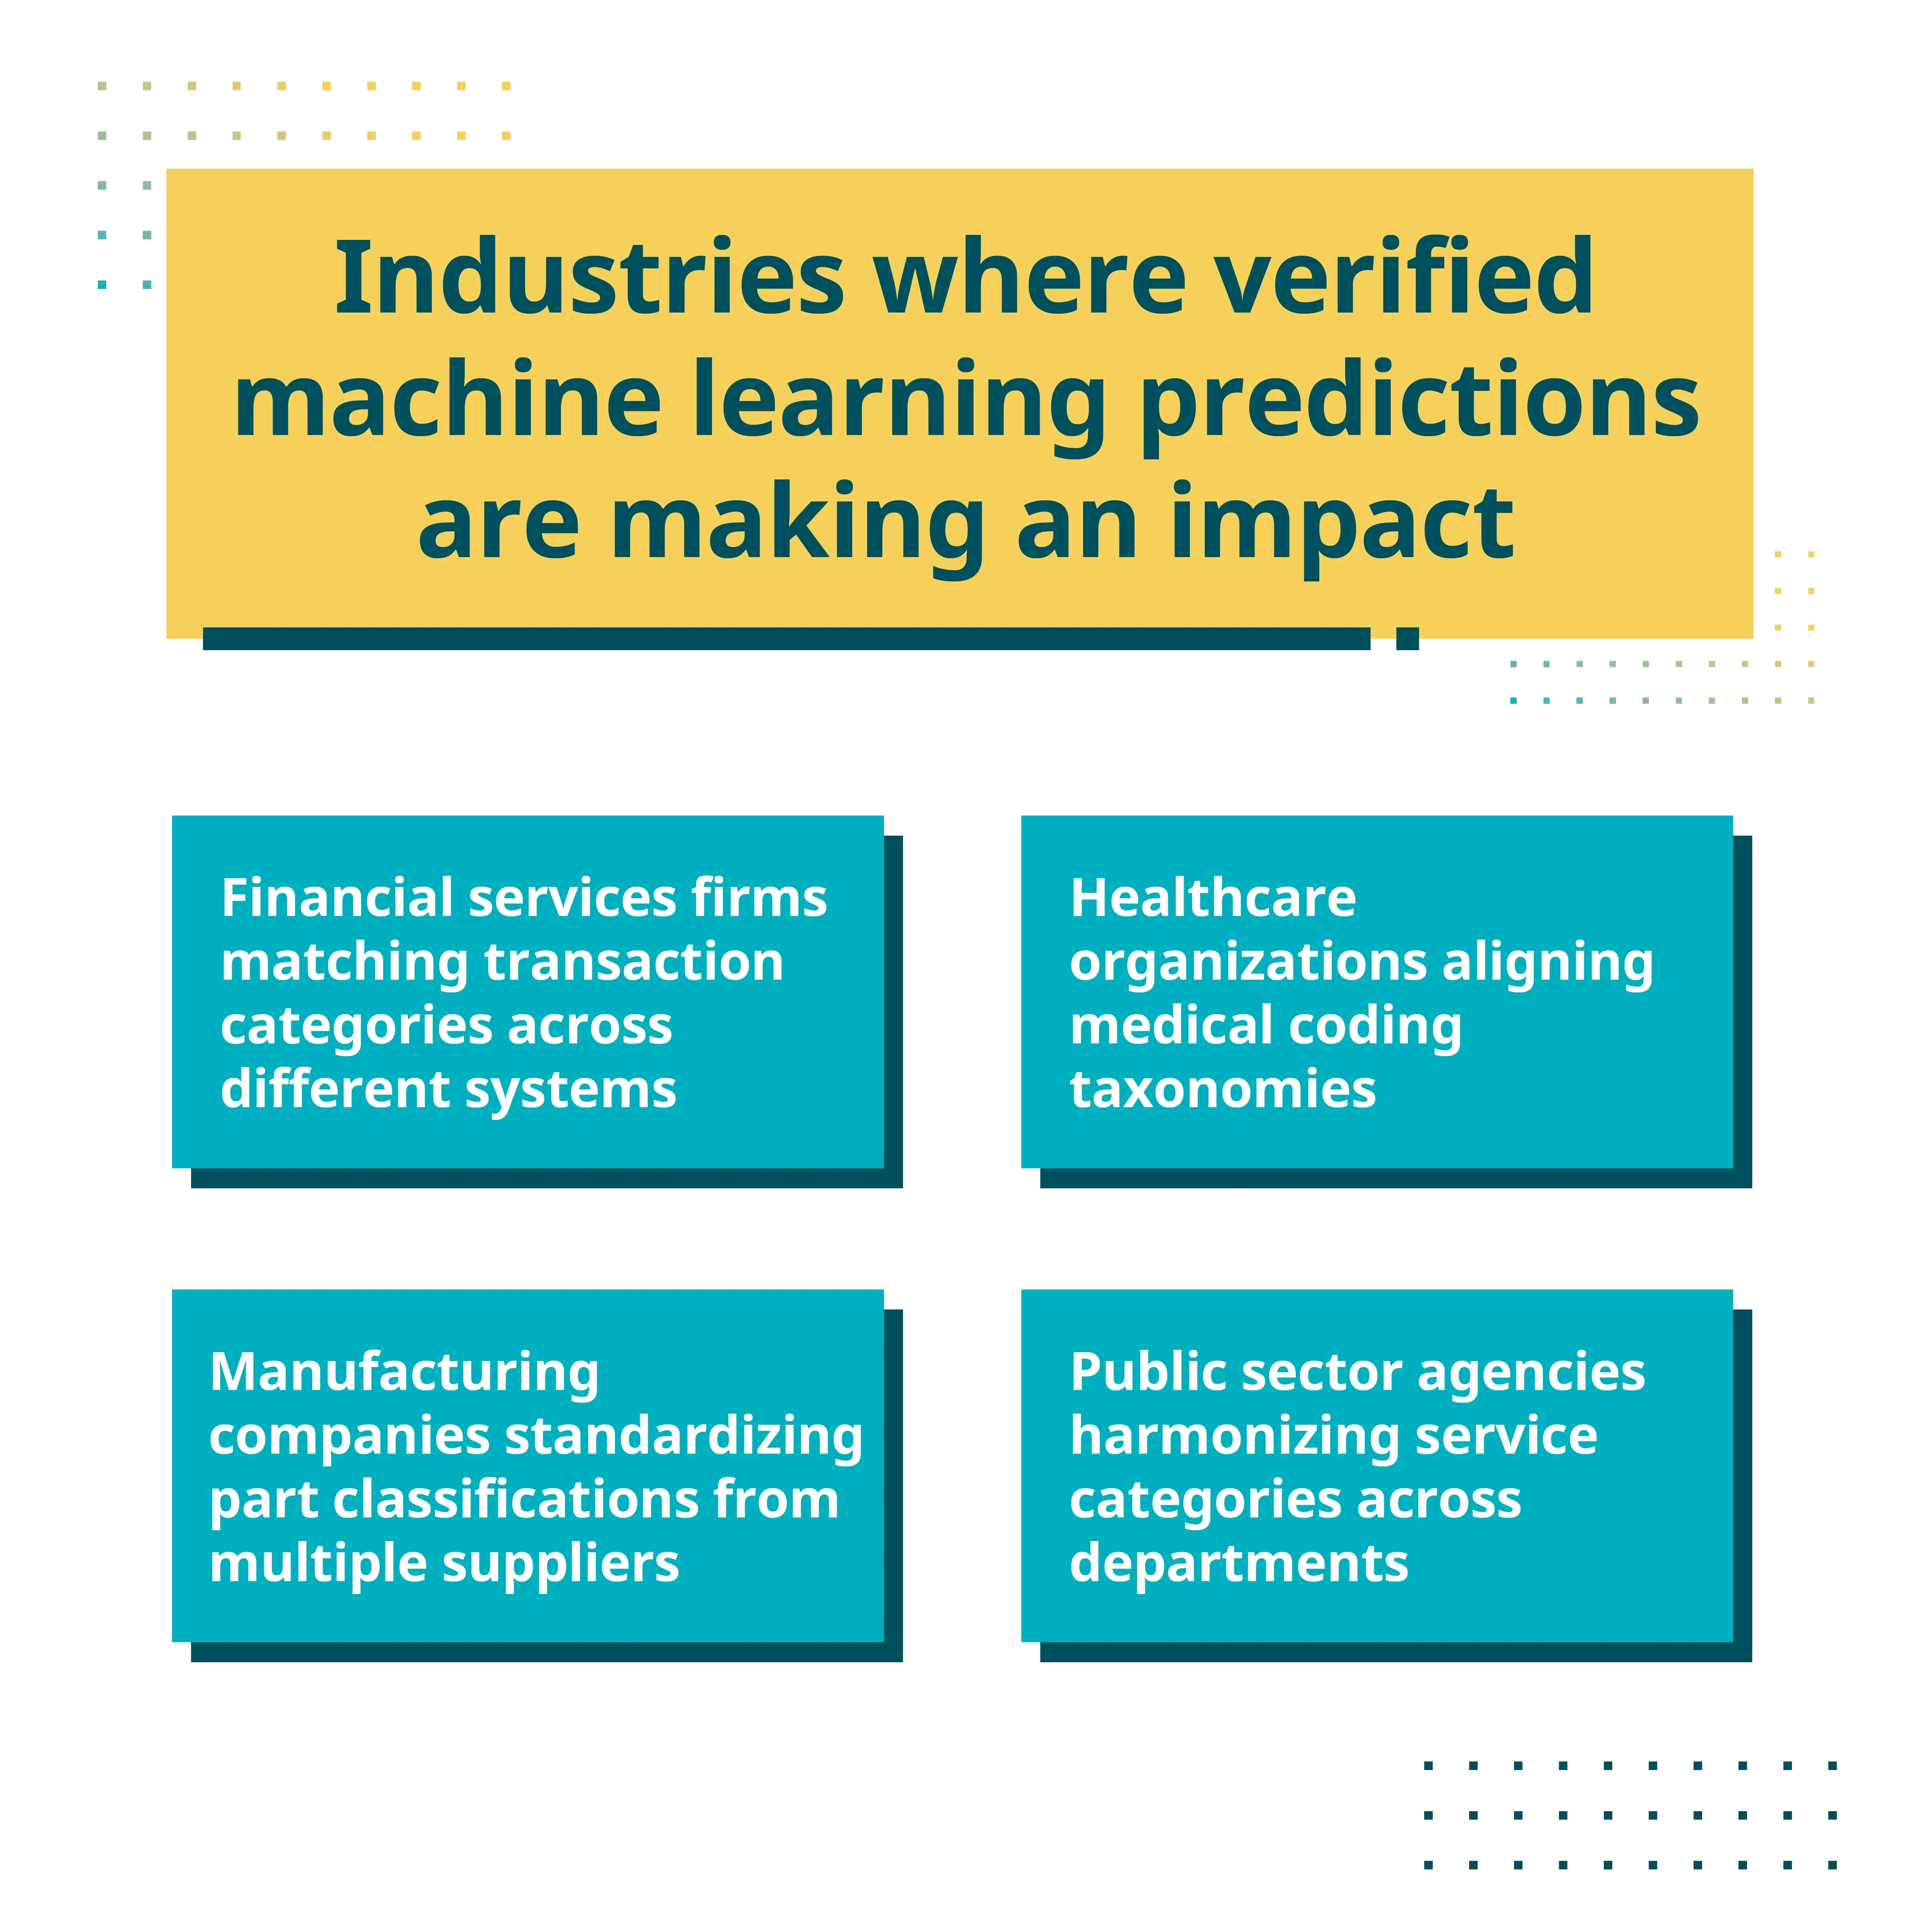
システム間の分類体系の整合、分類の照合、または標準化に関わるあらゆる状況において、検証済みの予測が役立ちます。
導入の現状
現在、実環境でのプロトタイプのテストを行っています。
導入はまだ初期段階ですが、数学的検証は期待通りに機能しており、どの予測が信頼できるかを正確に特定しています。次の段階では、ユーザー体験の洗練と、検証機能をより多くのデータ管理シナリオへと拡大することを目指します。
まとめ
データ管理における真の自動化にとって、信頼性は依然として最大の障壁です。機械学習と数学的検証を組み合わせることで、速度と精度のどちらかを選ばなければならないという状況に陥ることなく、実践的な道筋が開かれます。
データ管理において人間の役割は常に重要ですが、検証済みのAIが確実に処理できる定型業務ではなく、最も付加価値を生み出す分野にその専門知識を集中させることができるようになりました。
MLによる予測を信頼できるようになれば、ようやく自信を持って自動化を進めることができるようになります。