
In jedem großen Unternehmen, in dem Sie im Bereich Stammdatenmanagement (MDM) tätig sind, haben Sie ständig mit Lieferantendatenflüssen, der Einhaltung gesetzlicher Vorschriften, Nachhaltigkeitskennzahlen und der Datenfreigabe auf Marktplätzen zu kämpfen … und müssen gleichzeitig die Kosten niedrig und die Zufriedenheit hoch halten.
Mit maschinellem Lernen (ML) können Sie sich wiederholende, zeitaufwändige Aufgaben mit unglaublicher Geschwindigkeit automatisieren, doch das Vertrauen in KI-Prognosen stellt Sie vor eine echte Herausforderung.
Wenn Ihr ML-Modell falsche Produktkategorien vorschlägt oder Beziehungen falsch identifiziert, verursachen diese Fehler nachgelagerte Probleme, die Ihre Effizienzgewinne zunichtemachen können.
Denn wenn Sie jede KI-Entscheidung manuell überprüfen müssen, sparen Sie dann wirklich Ressourcen?
Bei Stibo Systems kombinieren wir die Geschwindigkeit von ML mit mathematischer Verifizierung, sodass Sie echte Automatisierung mit der Genauigkeit erreichen können, die Ihr Unternehmen benötigt.
Und in diesem Blogbeitrag werde ich Ihnen erläutern, wie wir dorthin gelangt sind und wie das Ganze funktioniert. Sie erhalten sowohl den Kontext als auch die wichtigsten Erkenntnisse.
Warum brauchen wir Maschinen, die uns beim MDM unterstützen?
Wahrscheinlich haben Sie das Gefühl, dass Ihr Arbeitsaufwand im Datenmanagement schneller wächst als Ihre Fähigkeit, ihn zu bewältigen. Damit sind Sie nicht allein. Datenmanager bewegen sich heute in einer komplexen Landschaft, in der Genauigkeit, Geschwindigkeit und Datenvolumen um Priorität konkurrieren.
- Die Einbindung riesiger Produktsortimente von Lieferanten mit uneinheitlichen Datenformaten und schwankender Datenqualität
- Aufrechterhaltung von Governance-Prozessen, die die Vertrauenswürdigkeit Ihrer Daten systemübergreifend gewährleisten
- Einhaltung sich ständig weiterentwickelnder regulatorischer Anforderungen
- Verwaltung einer wachsenden Vielzahl von Nachhaltigkeits- und ESG-Datenpunkten
- Verteilung sauberer, konsistenter Daten an verschiedene Kanäle und Marktplätze
Traditionelle Ansätze zur Bewältigung dieser Herausforderungen stützen sich oft stark auf manuelle Prozesse, Geschäftsregeln und menschliche Überprüfung.
Dies kann in kleinerem Maßstab funktionieren, doch wenn Ihre Datenmengen wachsen, entstehen Engpässe. Ein Produktmanager, der früher 50 neue Artikel pro Tag überprüfen konnte, sieht sich nun mit Stapeln von Tausenden konfrontiert, was eine manuelle Überprüfung unpraktikabel macht.
Und es geht nicht nur darum, Zeit zu sparen – es geht darum, den Wettbewerbsvorteil zu sichern. Wenn Ihre Wettbewerber neue Produkte schneller einbinden, Informationen zügiger aktualisieren und Daten effektiver verbreiten können, verschaffen sie sich entscheidende Marktvorteile. Manuelle Prozesse lassen sich ohne erhebliche Ressourceninvestitionen einfach nicht so skalieren, dass sie diesen Anforderungen gerecht werden.
Was diese Herausforderungen besonders für den Einsatz von Technologie prädestiniert, ist ihr repetitiver, musterbasierter Charakter. Oft geht es darum, Ähnlichkeiten zu erkennen, einheitliche Regeln anzuwenden und evidenzbasierte Entscheidungen zu treffen.
Genau die Art von Arbeit, bei der ML seine Stärken ausspielt.
Wie ML die Spielregeln komplett verändert hat
ML passt perfekt zu den arbeitsintensivsten Aufgaben des Datenmanagements.
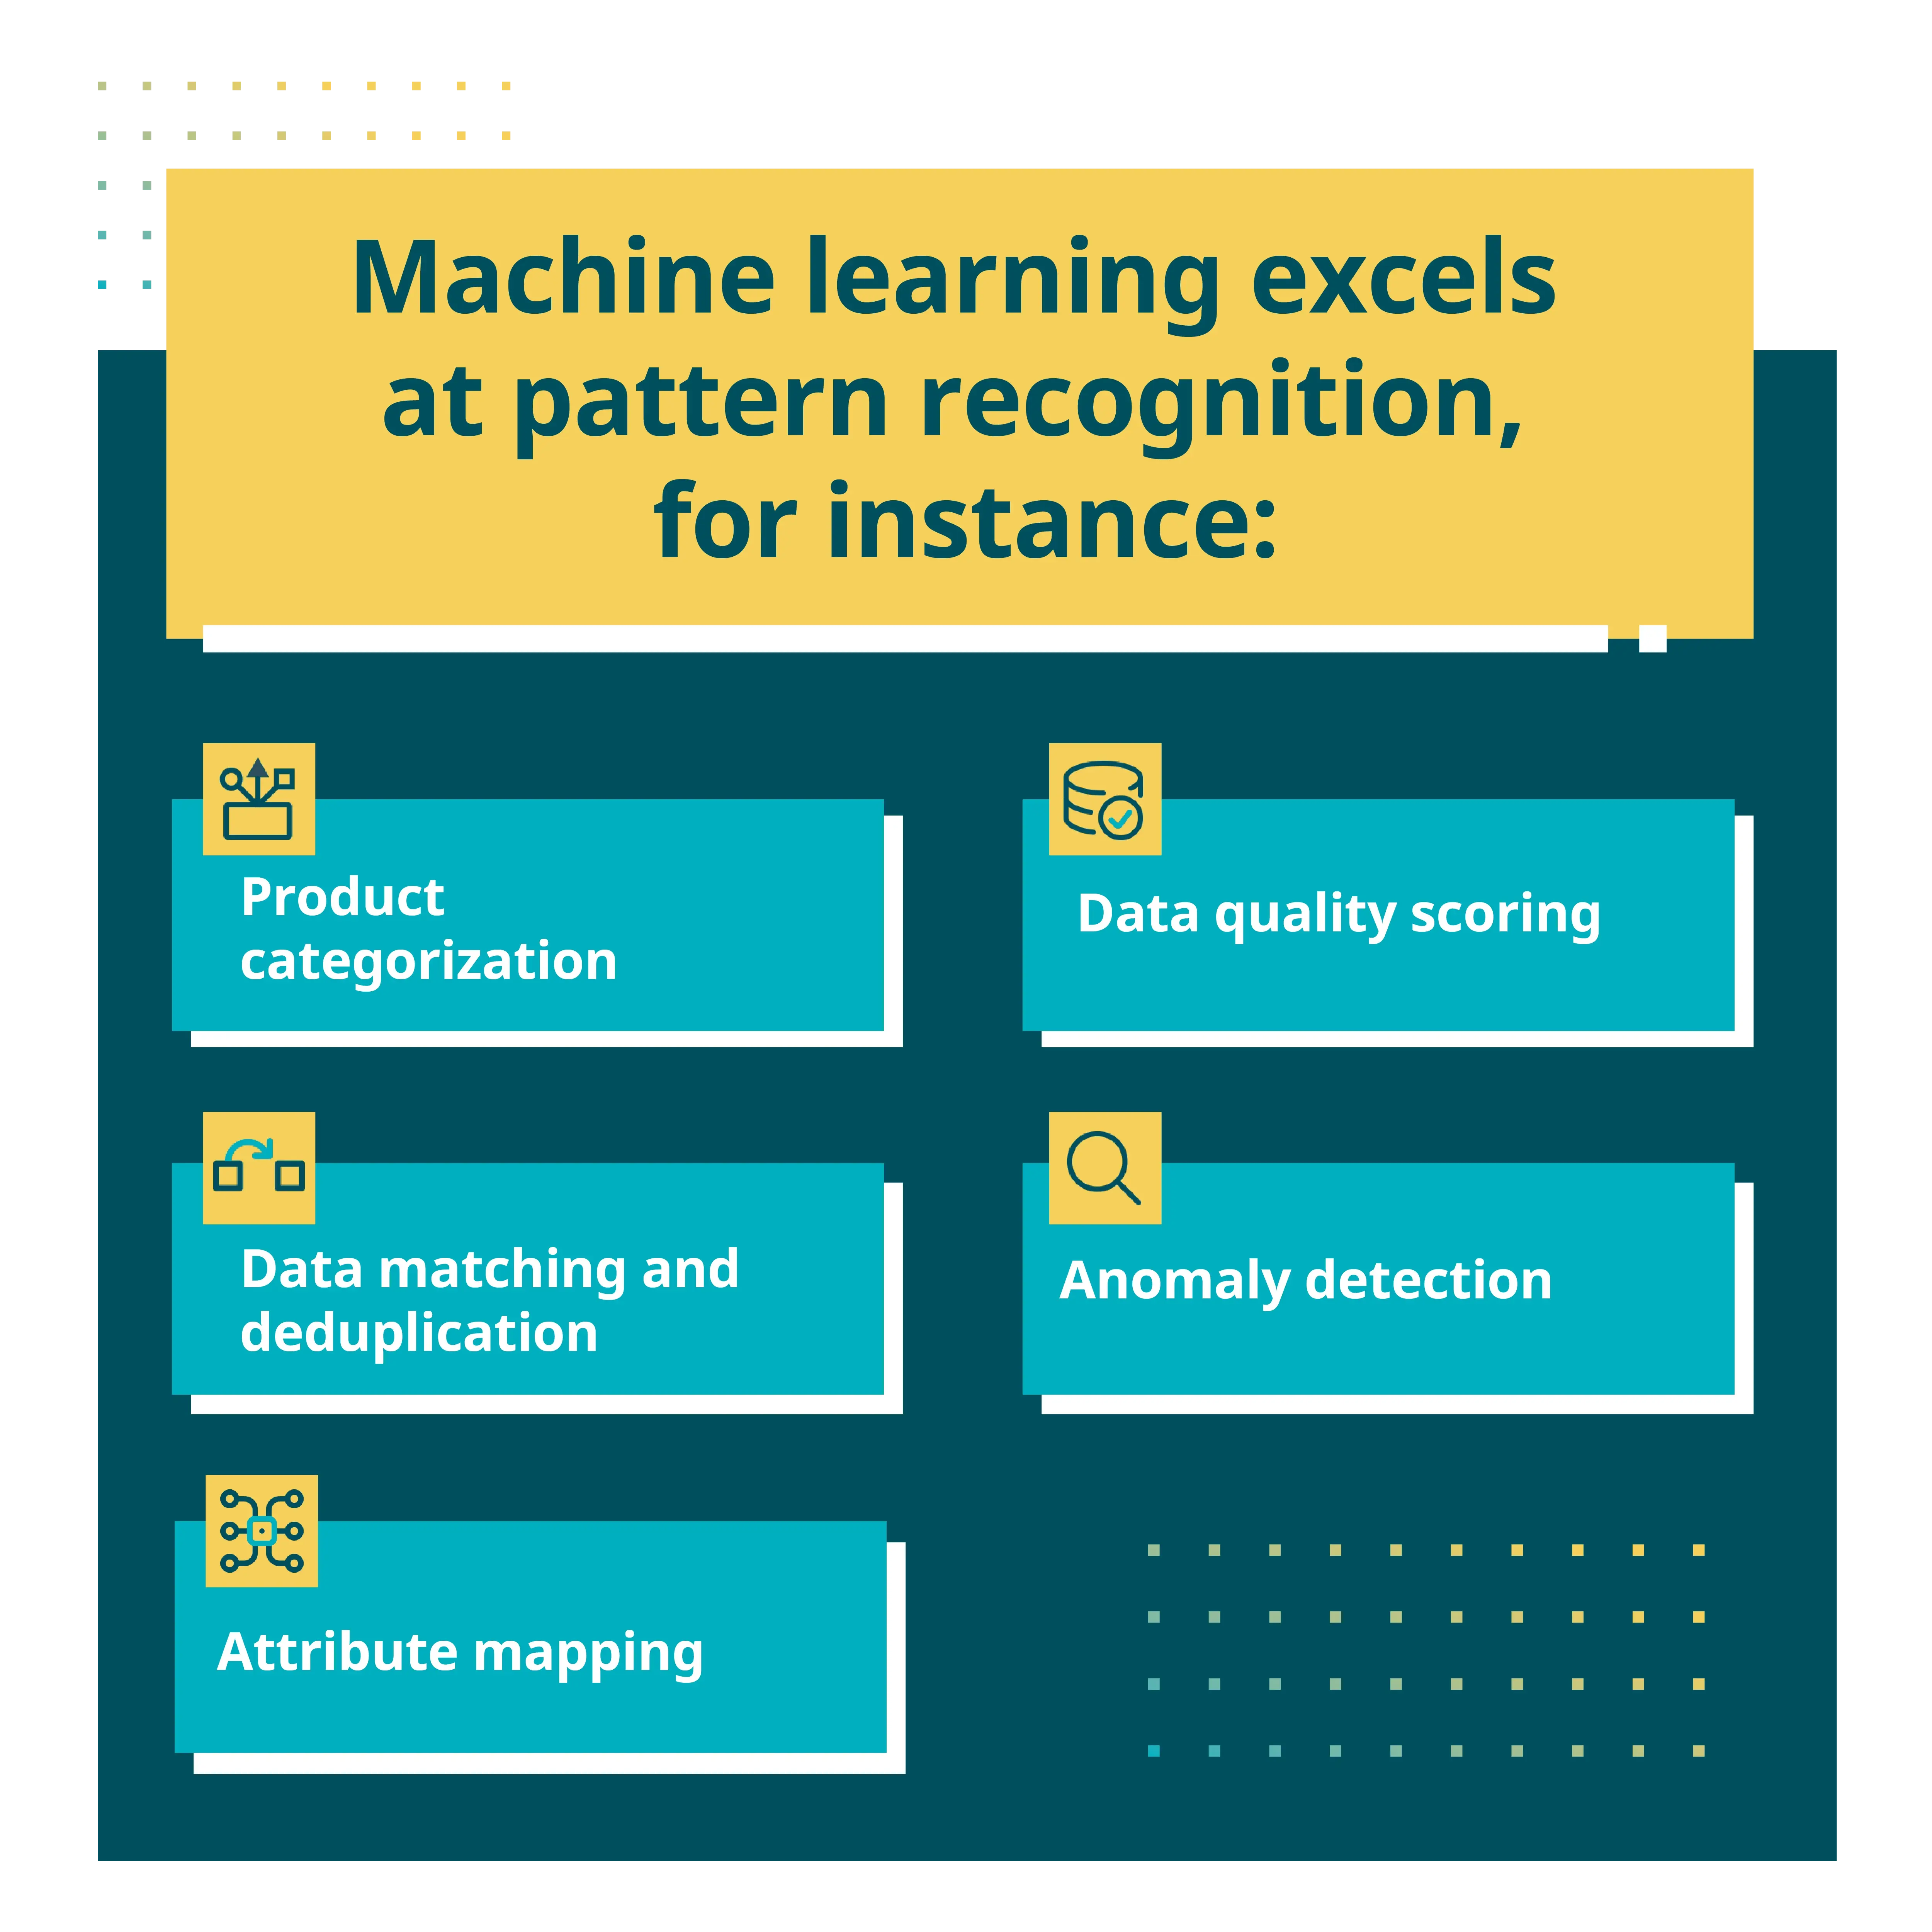
Im Kern zeichnet sich ML durch Mustererkennung, Kategorisierung und Vorhersagen aus – genau das, was man bei der Verwaltung großer Mengen komplexer Daten benötigt. Nehmen wir zum Beispiel folgende Beispiele:
-
Produktkategorisierung
Automatische Zuordnung neuer Produkte zu den richtigen Kategorien in Ihrer Taxonomie. -
Datenabgleich und Dublettenbereinigung
Erkennen, wann verschiedene Datensätze dieselbe reale Entität darstellen. -
Attributzuordnung
Zuordnung lieferantenspezifischer Attribute zu Ihrem standardisierten Datenmodell. -
Bewertung der Datenqualität
Vorhersage des Vollständigkeits- und Genauigkeitsgrades ohne manuelle Überprüfung. -
Erkennung von Anomalien
Kennzeichnung ungewöhnlicher Datenmuster, die auf Fehler oder Chancen hinweisen könnten.
Die Effizienzsteigerungen können bemerkenswert sein. Aufgaben, die früher Tage dauerten, lassen sich nun in wenigen Minuten erledigen. Und es geht nicht nur um Geschwindigkeit:
ML sorgt für Konsistenz
Die Kategorisierung durch Menschen variiert naturgemäß von Person zu Person und sogar bei derselben Person zu unterschiedlichen Zeitpunkten. ML wendet dieselbe Logik konsistent (statistisch) an. Sie begrenzen die Variabilität, die weiter unten in der Datenverarbeitung zu Problemen führt.
ML passt sich der Entwicklung Ihres Unternehmens an
Bei herkömmlichen, regelbasierten Systemen ist eine explizite Neuprogrammierung erforderlich, wenn sich Ihre Geschäftsbedingungen ändern. ML-Modelle hingegen können sich verändernde Muster in Ihren Daten erkennen und sich entsprechend anpassen. Dank dieser Anpassungsfähigkeit bleiben Ihre Datenmanagementprozesse mit minimalem Aufwand auf dem neuesten Stand.
Diese Vorteile sind jedoch mit einem wichtigen Vorbehalt verbunden: Die Vorhersagen sind nur so gut wie die Genauigkeit des Modells. Und genau hier stoßen viele Datenmanagement-Teams auf ihrer Automatisierungsreise an ihre Grenzen.
Wenn Sie Ihrem ML nicht vertrauen können, bricht alles zusammen
ML-Prognosen sind von Natur aus mit Unsicherheit behaftet. ML-Modelle sind zwar gut darin, Muster zu erkennen, bieten Ihnen jedoch nicht die Gewissheit eines mathematischen Beweises. Dies führt zu einem Vertrauensproblem, das das Automatisierungspotenzial erheblich einschränken kann.
Das Dilemma der Genauigkeit
Jedes ML-Modell weist ein gewisses Maß an Ungenauigkeit auf, das sich typischerweise in zwei Formen äußert:
- Falsch-Negative, bei denen gültige Übereinstimmungen nicht erkannt werden
- Falsch-Positive, bei denen falsche Übereinstimmungen festgestellt werden
Für das Datenmanagement stellen falsche Positive das größere Problem dar. Wenn ein Modell ein Produkt falsch kategorisiert oder zwei verschiedene Kunden fälschlicherweise miteinander in Verbindung bringt, verbreiten sich diese Fehler in Ihren Systemen und führen zu Problemen mit der Datenqualität, die den Geschäftsbetrieb beeinträchtigen können.
Eine teilweise Automatisierung reicht nicht aus
Viele Unternehmen begegnen dieser Herausforderung mit einem hybriden Ansatz: Sie nutzen ML für die Erstverarbeitung und überprüfen die Ergebnisse anschließend manuell. Dieser Ansatz ist zwar immer noch besser als vollständig manuelle Prozesse, führt jedoch zu folgenden Problemen:
- führt in Zeiten mit hohem Datenaufkommen zu Engpässen bei der Überprüfung
- erfordert nach wie vor erhebliche personelle Ressourcen
- schränkt die Skalierbarkeitsvorteile ein, die Sie sich von ML erhoffen
- verzögert zeitkritische Prozesse
Die Verifizierungslücke
Das Kernproblem ist nicht, dass ML Fehler macht – es ist das Fehlen eines zuverlässigen Mechanismus zur Überprüfung, welchen Vorhersagen Sie vertrauen können.
Ohne zu wissen, welche Vorhersagen mit Sicherheit korrekt sind, sind Sie gezwungen, alles zu überprüfen oder eine gewisse Fehlerquote in Ihren Stammdaten in Kauf zu nehmen.
Diese Verifizierungslücke stellt die entscheidende Barriere zwischen unterstützter Verarbeitung und echter Automatisierung dar. Um diese Lücke zu schließen, benötigen Sie einen grundlegend anderen Ansatz, der die Mustererkennungsfähigkeiten von ML mit Methoden kombiniert, die mathematische Gewissheit über die Vorhersagegenauigkeit liefern können.
Schließlich müssen Sie nicht wissen, dass Ihr Modell insgesamt zu 95 % genau ist. Sie müssen wissen, welchen 95 % der Vorhersagen Sie vertrauen können.
Dies ist in der Tat ein schwer zu lösendes Problem – eines, dessen Natur je nach Anwendungsfall variiert. Aber bei Stibo Systems arbeiten wir unermüdlich daran, solche Herausforderungen zu meistern, und um dieses Problem anzugehen, beginnen wir mit der Verifizierung von Klassifizierungsempfehlungen durch KI-Unterstützung – in der Forschung auch als Ontologie-(Klassifizierungs-)Mapping bekannt.
So integrieren Sie mathematische Verifizierungsmechanismen in Ihr ML-Modell
Unsere Forschung in Zusammenarbeit mit der Technischen Universität Dänemark (DTU) – einer der führenden technischen Universitäten Europas, die zudem als beste technische Universität Dänemarks gilt – hat zu einem bahnbrechenden Ansatz geführt.
Er verbindet die Geschwindigkeit des maschinellen Lernens mit der Sicherheit der mathematischen Verifizierung.
Die Verifizierungsherausforderungen, die wir lösen
Wenn KI eingesetzt wird, um Klassifikationssysteme miteinander abzugleichen – zum Beispiel, um „Handwerkzeuge“ in einer Produktaxonomie mit „Handheld-Werkzeugen“ in einer anderen abzugleichen –, können ML-Modelle beeindruckende Vorhersagen treffen.
Diese Vorhersagen sind jedoch stets mit statistischer Unsicherheit behaftet, die das Vertrauen untergraben kann. Und Vertrauen ist in diesem Zusammenhang gewissermaßen binär: Entweder kann man den Ergebnissen vertrauen oder nicht (und muss sie dann noch einmal überprüfen).
Das zentrale Problem ist die Konsistenz. Wie lässt sich überprüfen, ob die Zuordnungsbeziehungen über gesamte Klassifikationsstrukturen hinweg logisch sinnvoll sind?
Mathematische Gewissheit trifft auf praktische Anwendung
In unserer Lösung wenden wir formale mathematische Methoden an, um zu validieren, dass die empfohlenen Zuordnungen logisch konsistent sind. Ein mathematischer Beweis bestätigt, welche Vorhersagen korrekt sind – und nicht nur statistisch wahrscheinlich.
Dazu nutzen wir insbesondere die Aussagenlogik und „Horn-Klauseln“.
Was sind Horn-Klauseln?
Der Begriff mag komplex klingen, doch es handelt sich dabei lediglich um logische Aussagen, die einem „Wenn-Dann“-Muster folgen. Zum Beispiel: „Wenn ein Produkt ein Hammer ist UND Hämmer zu den Handwerkzeugen gehören, DANN gehört das Produkt zu den Handwerkzeugen.“ Durch die Anwendung dieser logischen Regeln auf Klassifizierungssysteme können wir mathematisch überprüfen, ob Zuordnungen sinnvoll sind.
Aber Sie fragen sich vielleicht: Wenn formale Methoden die nötige Sicherheit bieten, warum sollten wir dann überhaupt ML einsetzen?
Die Antwort liegt in der Recheneffizienz. Die alleinige Anwendung formaler Methoden auf große Klassifikationsstrukturen wäre für den praktischen Einsatz zu rechenintensiv.
Durch die Kombination beider Ansätze vereinen wir das Beste aus beiden Welten:
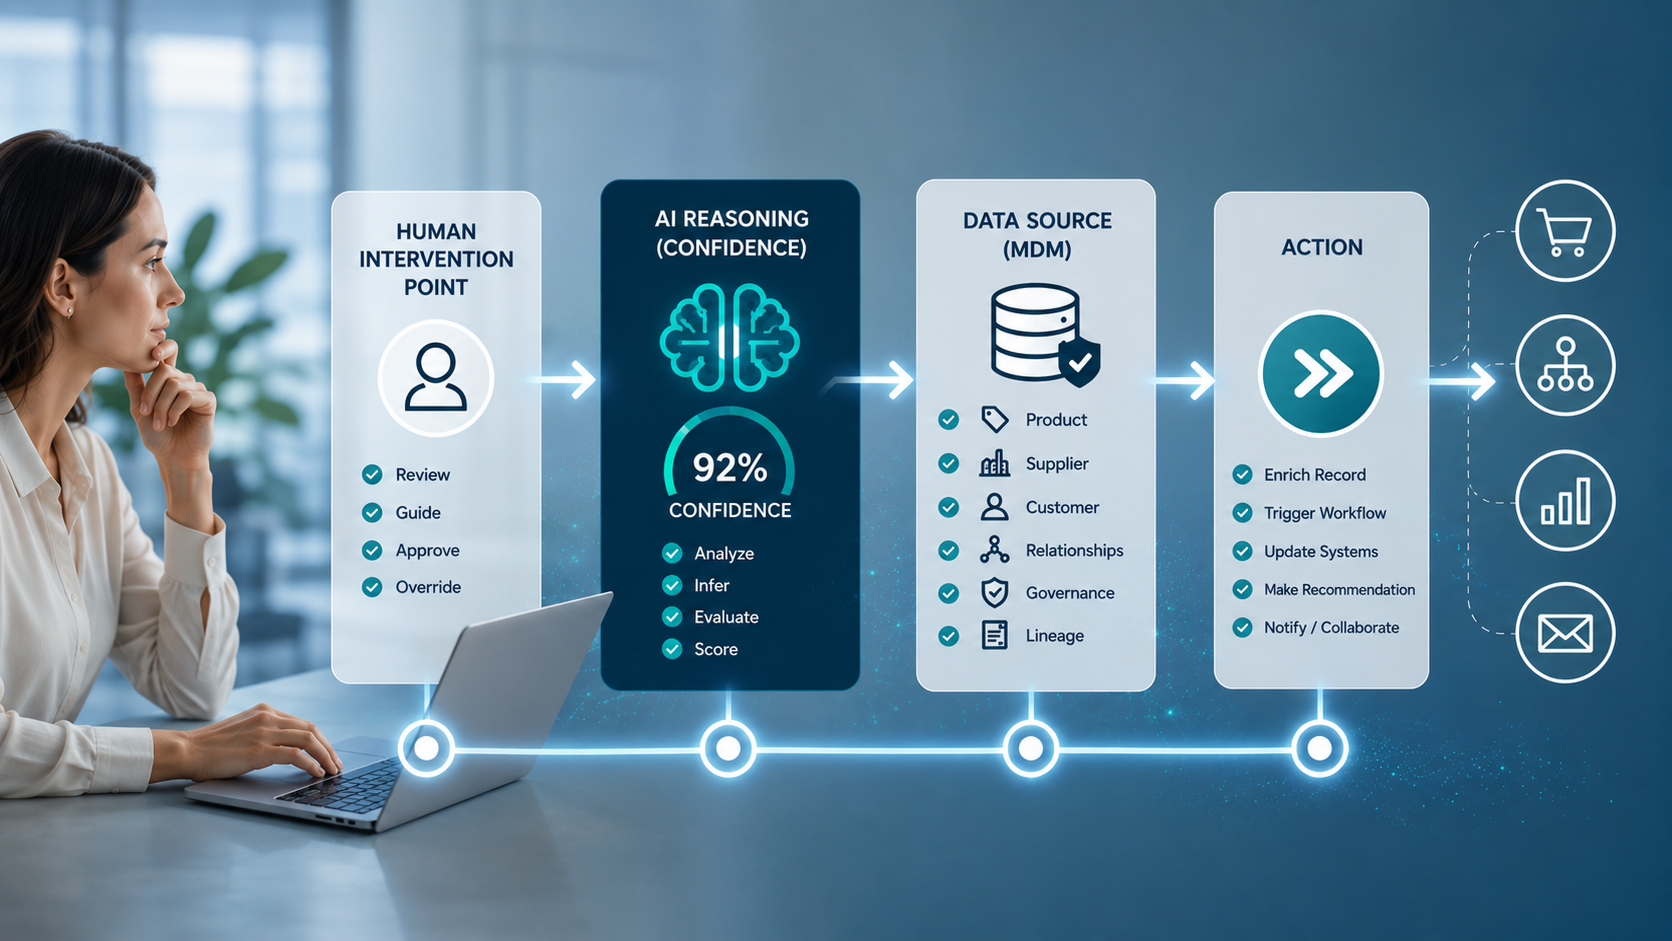
- Schnelle ML-Vorhersagen grenzen die möglichen Zuordnungen ein.
- Die mathematische Verifizierung bestätigt, welche Vorhersagen definitiv korrekt sind.
- Nur unsichere Vorhersagen müssen von Menschen überprüft werden.
Der hybride Ansatz reduziert den Verifizierungsaufwand drastisch und gewährleistet gleichzeitig die Genauigkeit, wodurch eine echte Automatisierung möglich wird.
Verstehen Sie all dies auf einer tieferen Ebene: Diese Arbeit wurde in „The Practice of Formal Methods“ veröffentlicht, einem Essay zu Ehren von Cliff Jones.
Bei Stibo Systems wenden wir dies in der Praxis an
Die mathematischen Grundlagen sind absolut solide – formale Logik ist entweder richtig oder falsch, es gibt keinen Mittelweg. Das Spannende daran ist die Anwendung dieser Prinzipien auf reale MDM-Herausforderungen.
Unsere Umsetzung konzentriert sich derzeit auf Szenarien mit hohem Datenaufkommen, in denen die Verifizierung erhebliche Engpässe verursacht.
Für Einzelhändler beispielsweise, die regelmäßig Tausende von Lieferantenartikeln einbinden, schafft die Möglichkeit, von der KI vorgeschlagene Kategorisierungen automatisch zu validieren, einen enormen Mehrwert im gesamten Prozess.
Wir arbeiten jedoch mit Unternehmen aus vielen Branchen zusammen, und potenzielle Anwendungsfälle gibt es überall:
- Finanzdienstleister, die Transaktionskategorien systemübergreifend abgleichen
- Gesundheitsorganisationen, die medizinische Kodierungstaxonomien aufeinander abstimmen
- Fertigungsunternehmen, die die Klassifizierung von Bauteilen verschiedener Lieferanten vereinheitlichen
- Behörden, die Dienstleistungskategorien abteilungsübergreifend harmonisieren
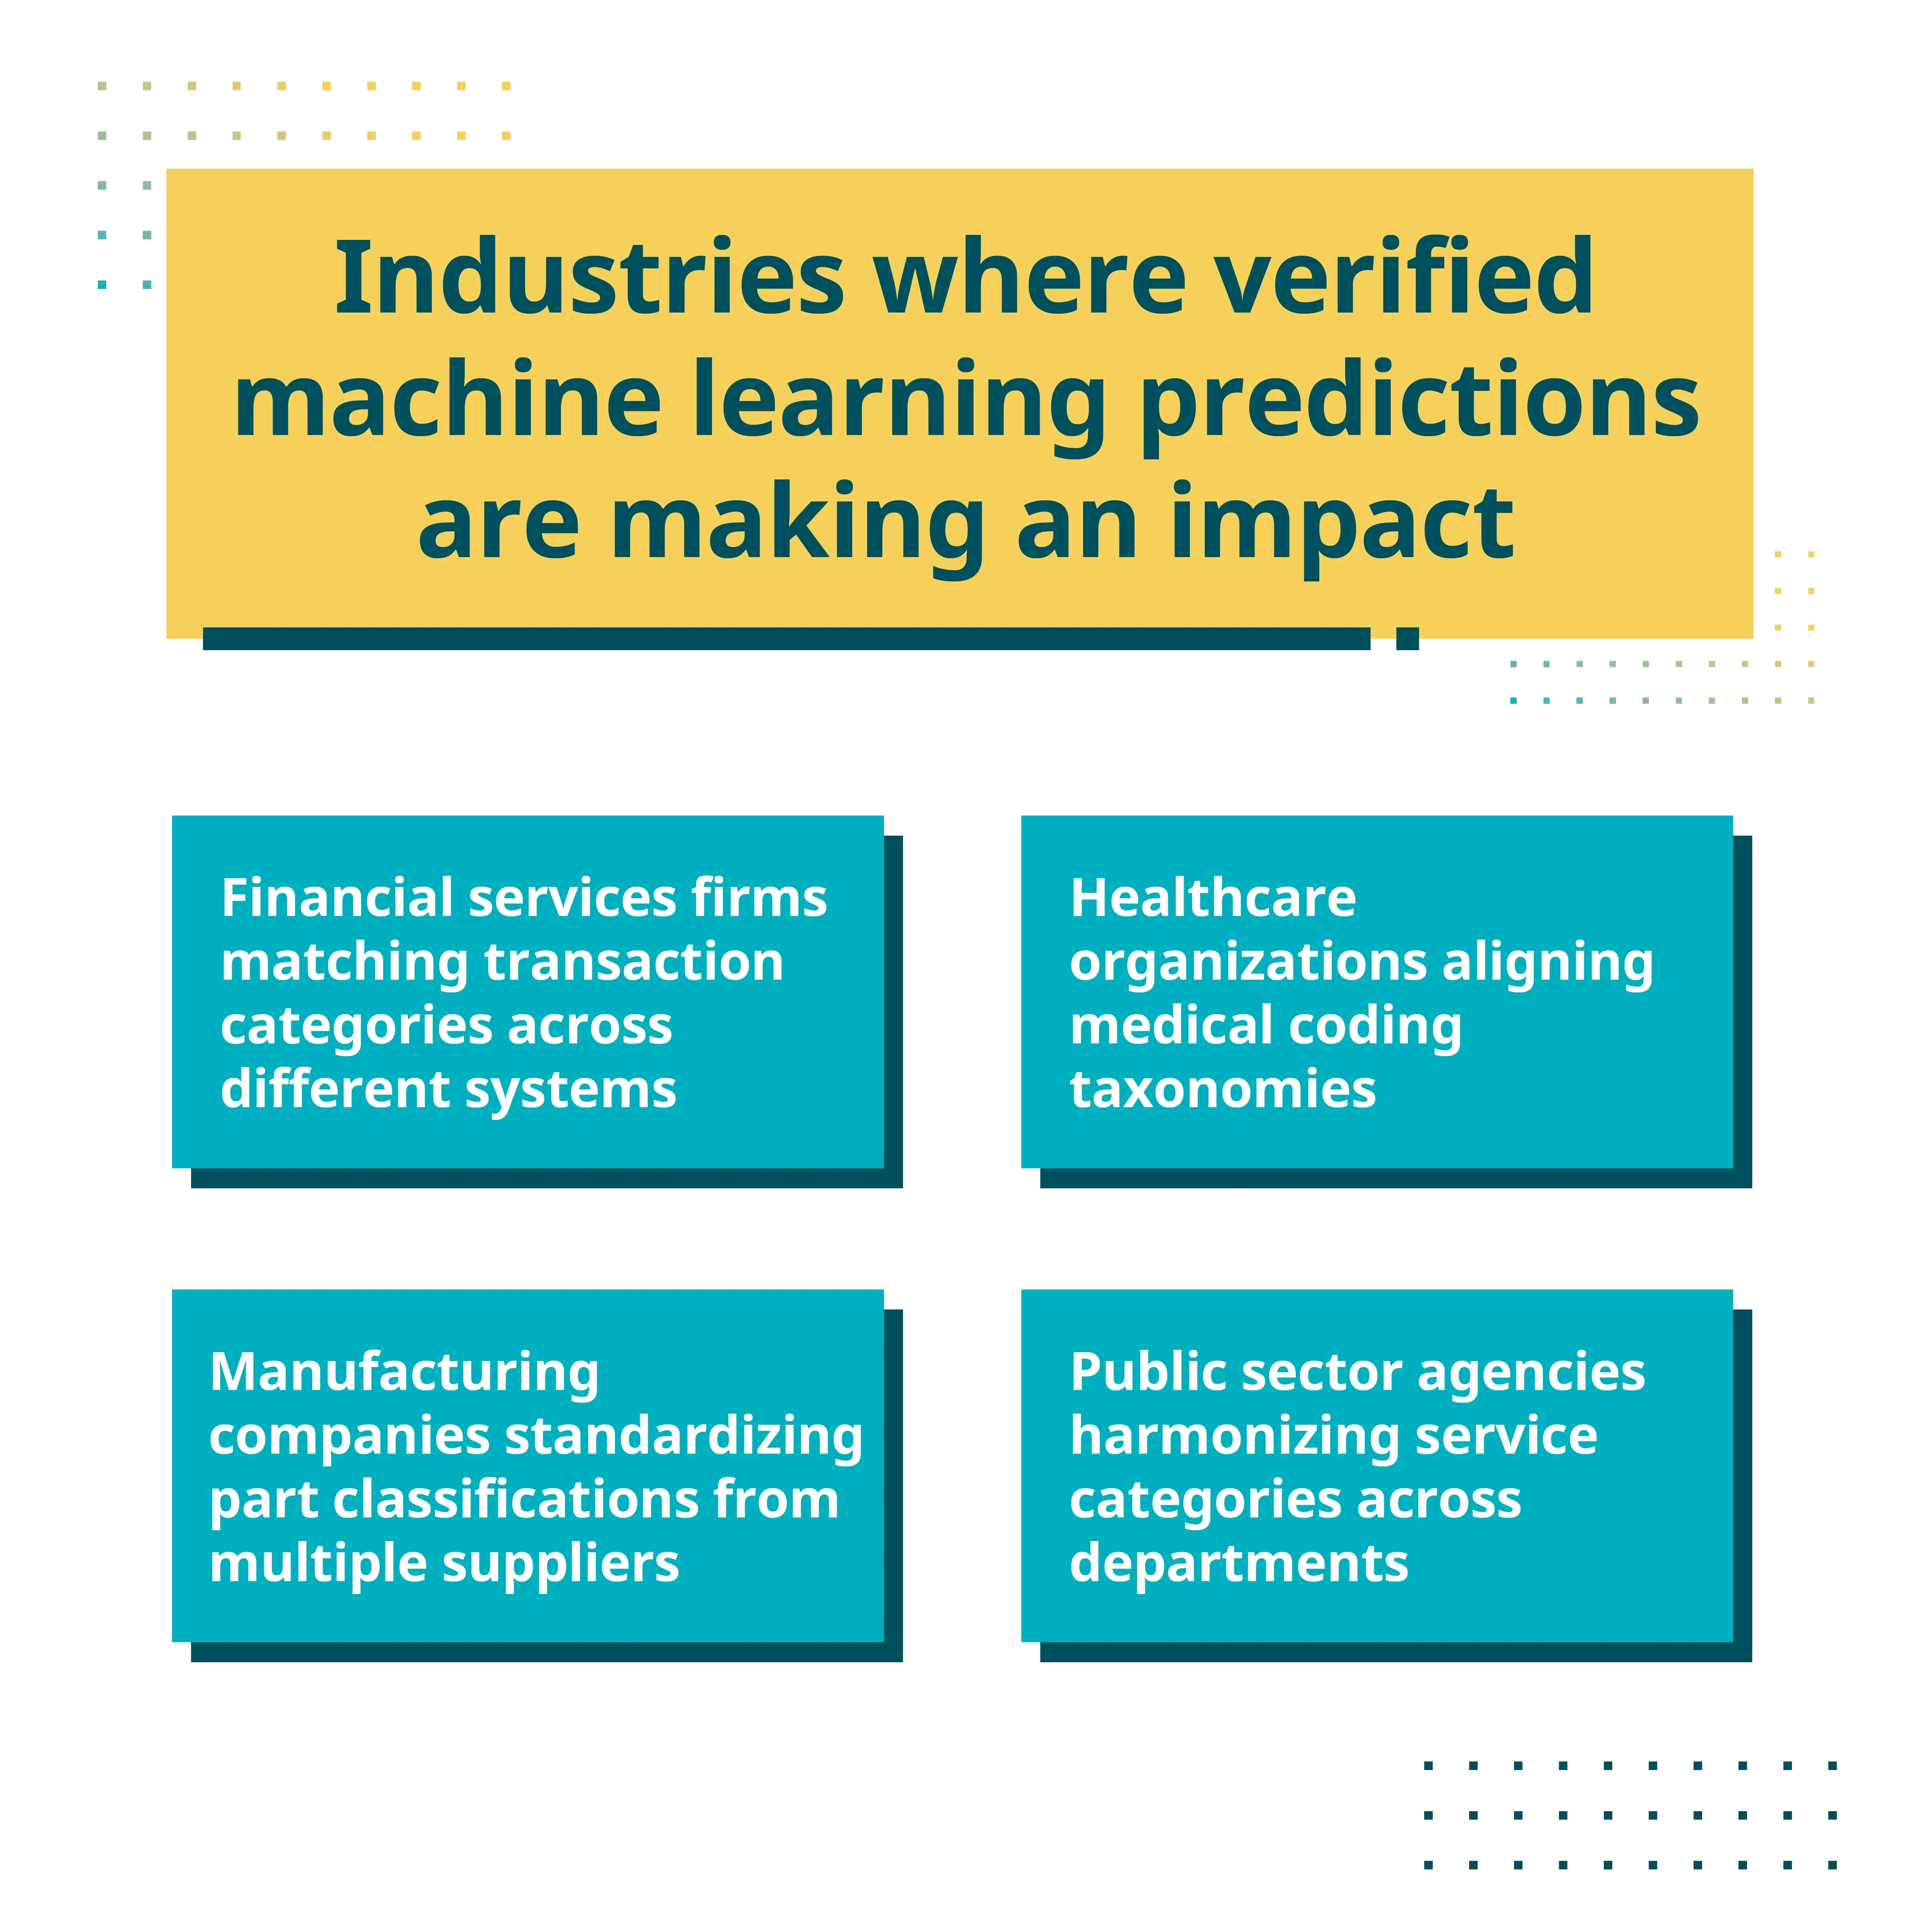
Jede Situation, in der es um die Abstimmung von Taxonomien, den Abgleich von Klassifikationen oder die systemübergreifende Standardisierung geht, könnte von verifizierten Vorhersagen profitieren.
Aktueller Stand unserer Implementierung
Derzeit testen wir Prototypen in realen Umgebungen.
Obwohl wir noch am Anfang der Umsetzung stehen, funktioniert die mathematische Verifizierung genau wie erwartet – sie identifiziert korrekt, welchen Vorhersagen man vertrauen kann. In der nächsten Phase geht es darum, die Benutzererfahrung zu verfeinern und die Verifizierungsfunktionen auf weitere Datenverwaltungsszenarien auszuweiten.
Fassen wir zusammen
Vertrauen bleibt die größte Hürde für eine echte Automatisierung im Datenmanagement. Unsere Kombination aus maschinellem Lernen und mathematischer Verifizierung bietet uns einen praktischen Weg nach vorn, bei dem Sie sich nicht zwischen Geschwindigkeit und Genauigkeit entscheiden müssen.
Die Rolle des Menschen wird im Datenmanagement immer von Bedeutung sein, aber wir können dieses Fachwissen nun dort einsetzen, wo es den größten Mehrwert bringt – und nicht bei Routineaufgaben, die eine verifizierte KI zuverlässig bewältigen kann.
Wenn Sie Ihren ML-Vorhersagen vertrauen können, können Sie endlich mit Zuversicht automatisieren.
Stammdatenmanagement Powered by AI
Nutzen Sie die Kraft der KI in Ihren MDM-Prozessen, um komplexe Lieferketten-Dynamiken mit größerer Agilität und Weitblick zu navigieren.