
Dans toute grande entreprise, si vous travaillez dans le domaine de la gestion des données de référence (MDM), vous êtes constamment confronté aux flux de données fournisseurs, à la conformité réglementaire, aux indicateurs de développement durable, au partage des données sur les places de marché… tout en devant maîtriser les coûts et maintenir un niveau élevé de satisfaction.
Grâce à l’apprentissage automatique (ML), vous pouvez automatiser des tâches répétitives et chronophages à une vitesse incroyable, mais faire confiance aux prédictions de l’IA représente un véritable défi.
Lorsque votre modèle d’apprentissage automatique propose des catégories erronées pour les produits ou identifie mal certaines relations, ces erreurs engendrent des problèmes en aval qui peuvent réduire à néant vos gains d’efficacité.
Après tout, si vous devez vérifier manuellement chaque décision de l’IA, économisez-vous vraiment des ressources ?
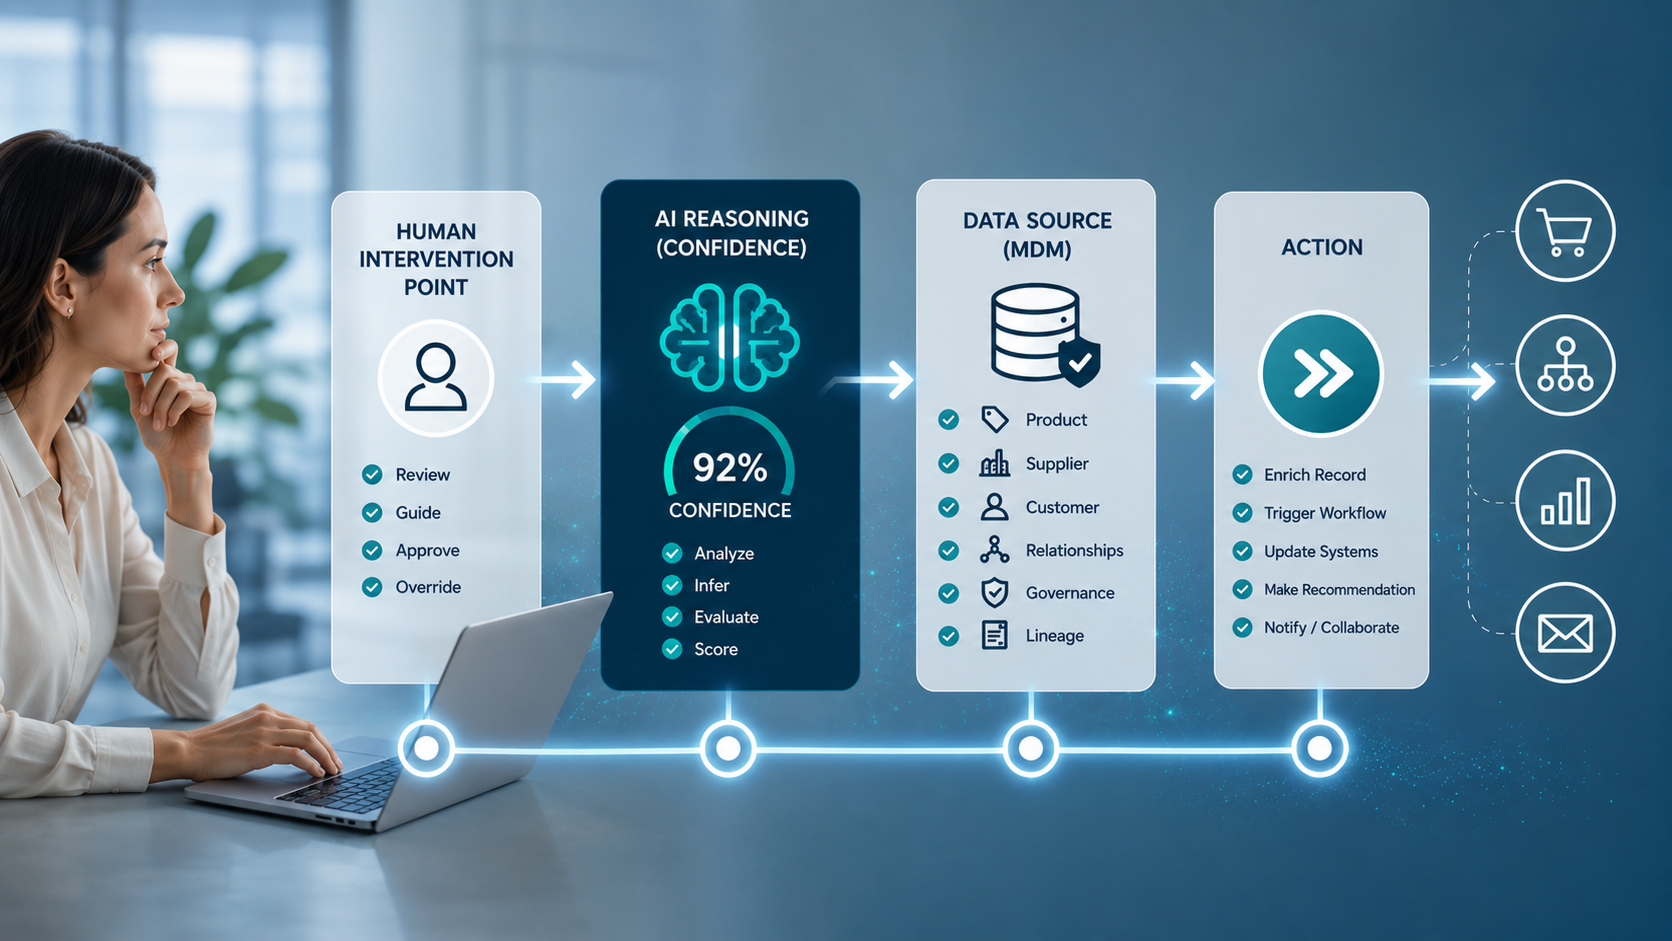
Chez Stibo Systems, nous combinons la rapidité du ML avec une vérification mathématique, ce qui vous permet d’atteindre une véritable automatisation avec le niveau de précision dont votre entreprise a besoin.
Et dans cet article de blog, je vais vous expliquer comment nous y sommes parvenus et comment cela fonctionne. Vous y trouverez à la fois le contexte ET les points à retenir.
Pourquoi avons-nous besoin de machines pour nous aider dans la gestion des données de référence (MDM) ?
Vous avez sans doute l’impression que votre charge de travail en matière de gestion des données augmente plus vite que votre capacité à la gérer. Vous n’êtes pas le seul. Les gestionnaires de données d’aujourd’hui évoluent dans un environnement complexe où précision, rapidité et volume se disputent la priorité.
- Intégrer des gammes de produits massives provenant de fournisseurs dont les formats de données et la qualité sont hétérogènes
- Maintenir des processus de gouvernance qui garantissent la fiabilité de vos données d’un système à l’autre
- Respecter des exigences réglementaires en constante évolution
- Gérer un éventail croissant de données relatives au développement durable et aux critères ESG
- Diffuser des données propres et cohérentes vers divers canaux et places de marché
Les approches traditionnelles pour relever ces défis reposent souvent largement sur des processus manuels, des règles métier et une vérification humaine.
Cela peut fonctionner à petite échelle, mais lorsque vos volumes de données augmentent, des goulots d’étranglement apparaissent. Un chef de produit qui pouvait autrefois vérifier 50 nouveaux articles par jour doit désormais traiter des lots de plusieurs milliers, ce qui rend la vérification manuelle impossible.
Et il ne s’agit pas seulement de gagner du temps, mais aussi de conserver un avantage concurrentiel. Lorsque vos concurrents peuvent intégrer de nouveaux produits plus rapidement, mettre à jour les informations plus vite et diffuser les données plus efficacement, ils acquièrent des avantages concurrentiels décisifs. Les processus manuels ne peuvent tout simplement pas s’adapter pour répondre à ces exigences sans investissements importants en ressources.
Ce qui rend ces défis particulièrement adaptés à une intervention technologique, c’est leur nature répétitive et basée sur des schémas. Il s’agit souvent de reconnaître des similitudes, d’appliquer des règles cohérentes et de prendre des décisions fondées sur des preuves.
C’est exactement le type de travail dans lequel l’apprentissage automatique excelle.
Comment l’apprentissage automatique a complètement changé la donne
L'apprentissage automatique (ML) correspond parfaitement aux tâches les plus fastidieuses de la gestion des données.
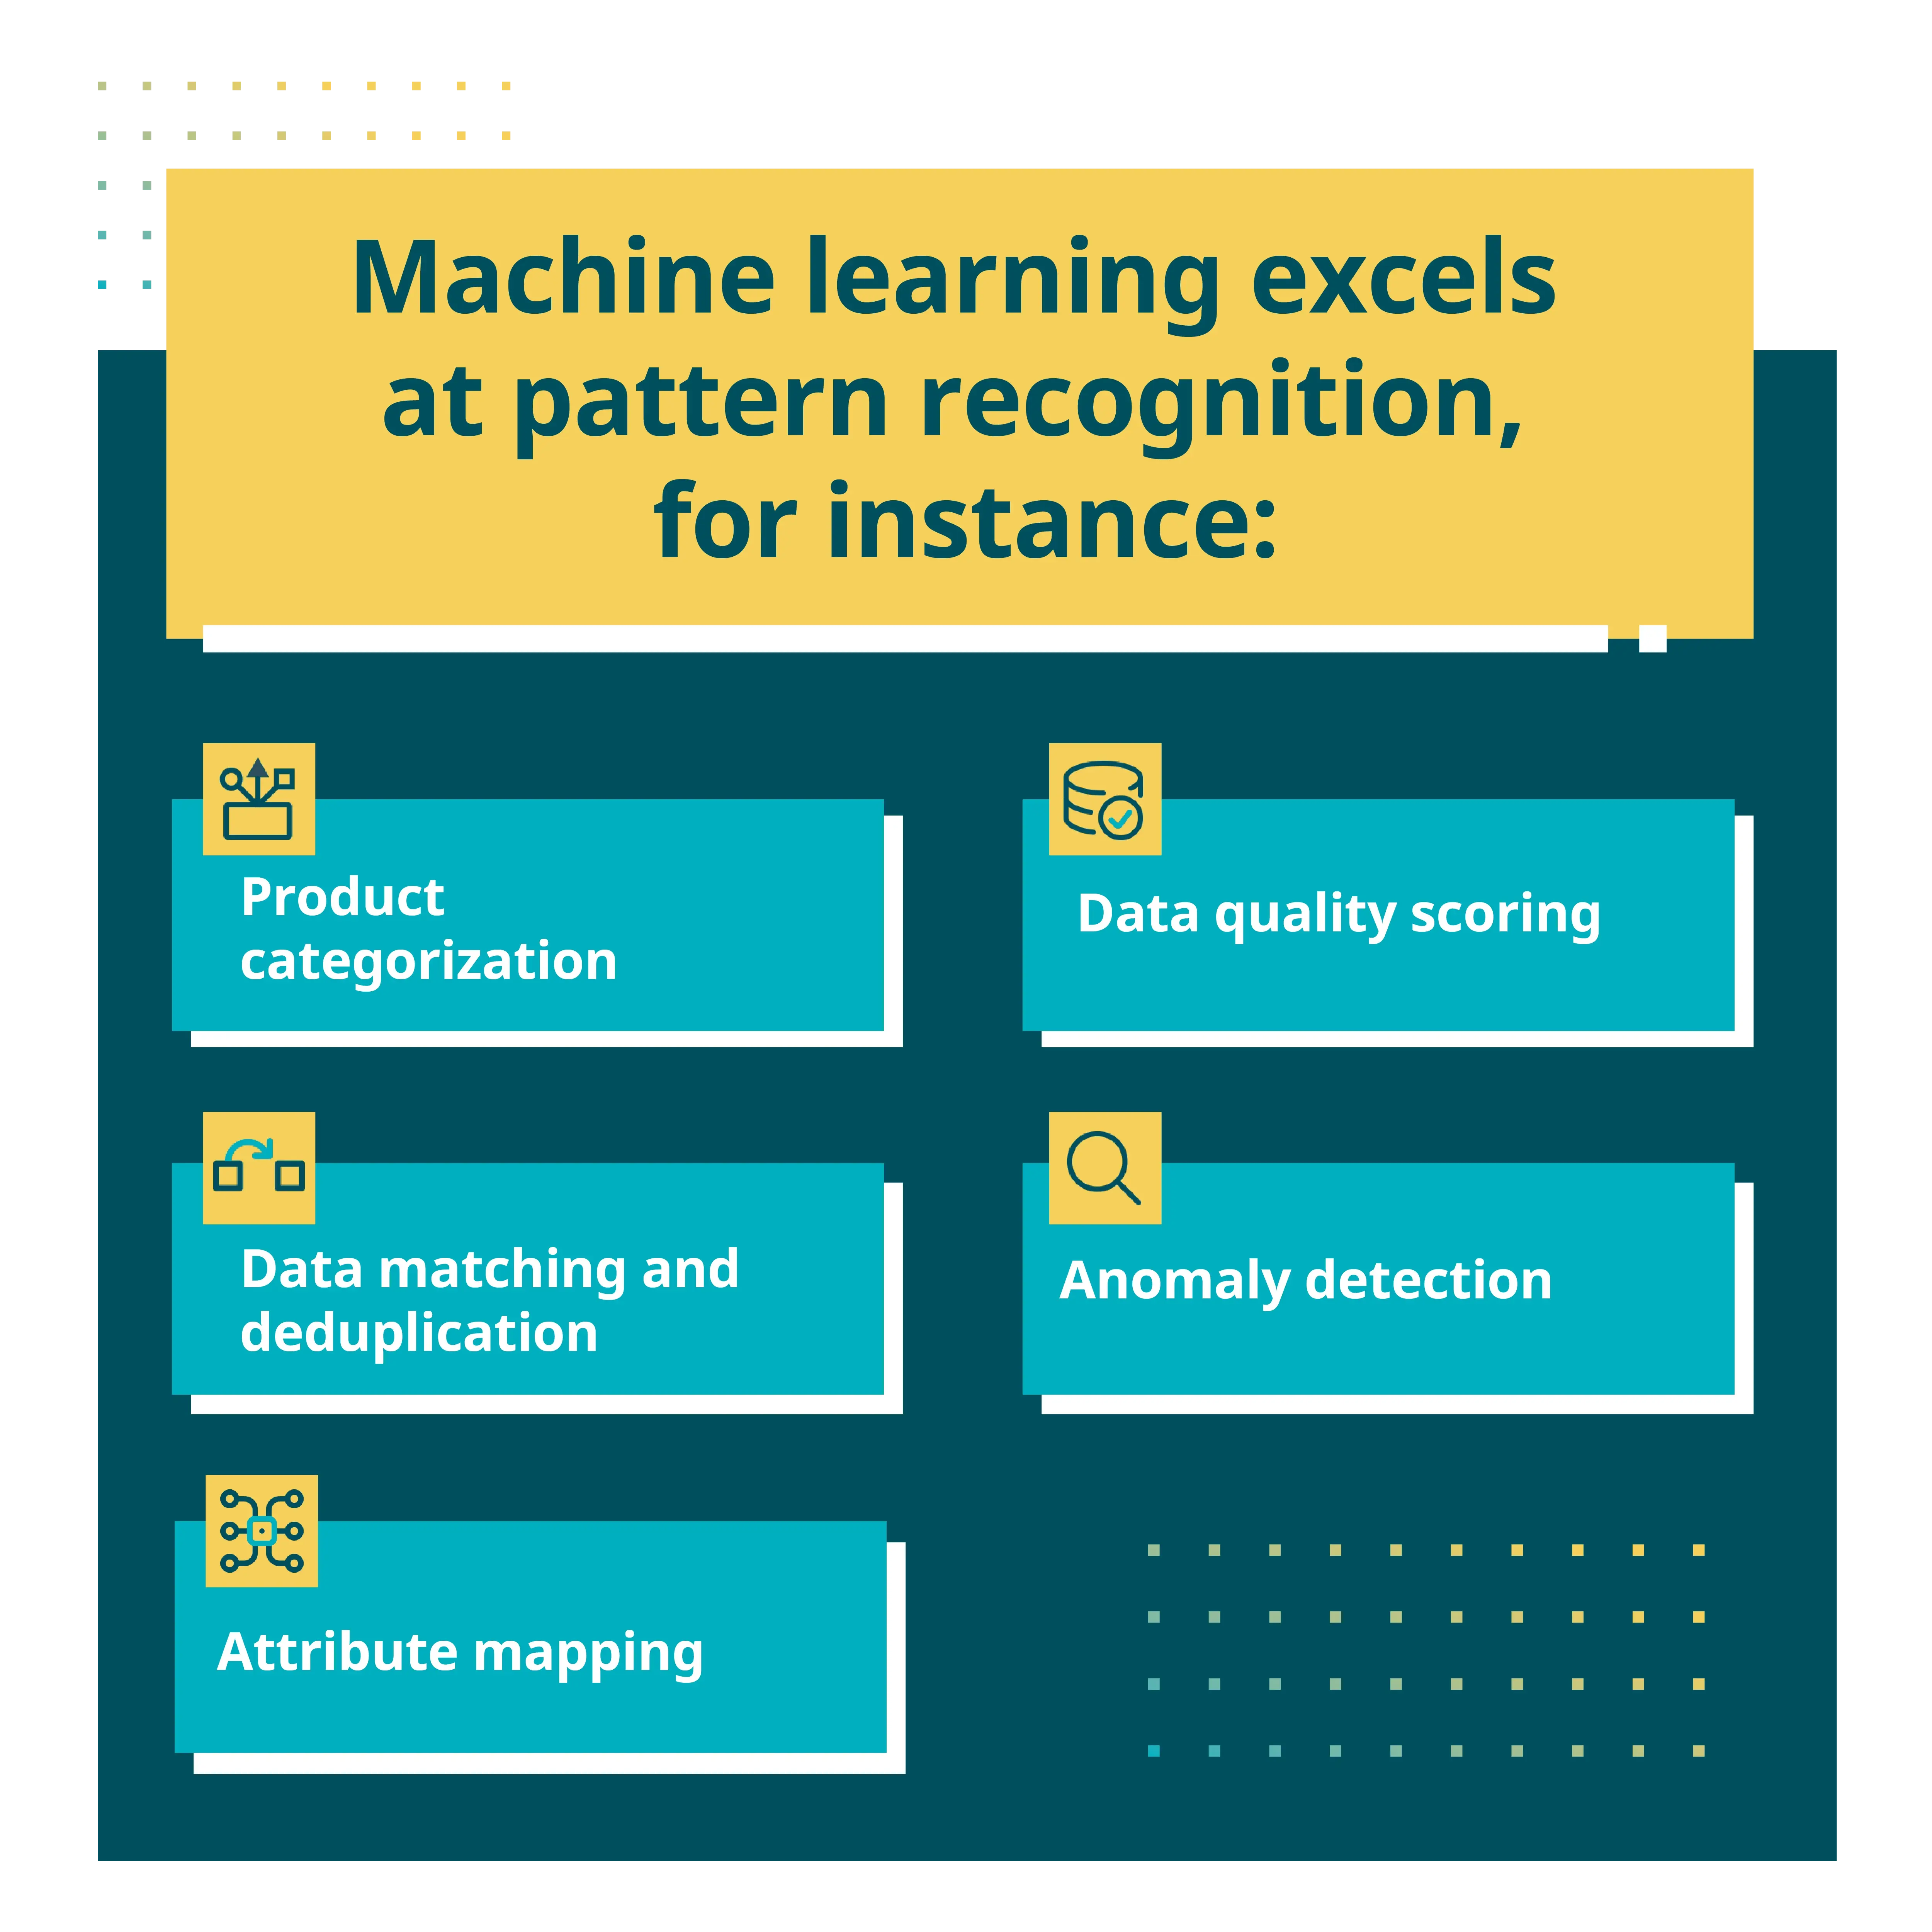
Par essence, le ML excelle dans la reconnaissance de schémas, la catégorisation et la prédiction – précisément ce dont vous avez besoin pour gérer de grands volumes de données complexes. Prenons les exemples suivants :
-
La catégorisation des produits
Attribuer automatiquement les nouveaux produits aux catégories appropriées de votre taxonomie. -
Correspondance et déduplication des données
Identification des cas où différents enregistrements correspondent à une même entité du monde réel. -
Mappage des attributs
Mise en correspondance des attributs spécifiques aux fournisseurs avec votre modèle de données standardisé. -
Évaluation de la qualité des données
Prévision des niveaux d'exhaustivité et d'exactitude sans vérification manuelle. -
Détection des anomalies
Signaler les schémas de données inhabituels pouvant indiquer des erreurs ou des opportunités.
Les gains d’efficacité peuvent être remarquables. Des tâches qui prenaient autrefois plusieurs jours peuvent désormais être réalisées en quelques minutes. Et il ne s’agit pas seulement de rapidité :
Le ML apporte de la cohérence
La catégorisation humaine varie naturellement d’une personne à l’autre, voire chez une même personne selon les moments. L’apprentissage automatique applique la même logique de manière cohérente (statistiquement). Vous limitez ainsi la variabilité qui est à l’origine de problèmes de données en aval.
Le ML s'adapte à mesure que votre entreprise évolue
Avec les systèmes traditionnels basés sur des règles, vous devez procéder à une reprogrammation explicite lorsque les conditions de votre activité changent. Les modèles d’apprentissage automatique, en revanche, peuvent détecter l’évolution des tendances dans vos données et s’ajuster en conséquence. Cette adaptabilité permet à vos processus de gestion des données de rester à jour avec un minimum d’intervention.
Mais ces avantages s’accompagnent d’une mise en garde importante : la qualité des prédictions dépend entièrement de la précision du modèle. Et c’est là que de nombreuses équipes de gestion des données se heurtent à un obstacle dans leur parcours vers l’automatisation.
Si vous ne pouvez pas faire confiance à votre ML, tout s’écroule
Les prédictions issues du ML comportent une incertitude inhérente. Si les modèles de ML sont efficaces pour reconnaître des tendances, ils ne vous offrent pas la certitude d’une preuve mathématique. Cela crée un problème de confiance qui peut limiter considérablement le potentiel d’automatisation.
Le dilemme de la précision
Chaque modèle d’apprentissage automatique génère un certain niveau d’inexactitude, qui se manifeste généralement sous deux formes :
- Les faux négatifs, où des correspondances valides ne sont pas reconnues
- Les faux positifs, c'est-à-dire lorsque des correspondances erronées sont établies
En matière de gestion des données, ce sont les faux positifs qui posent le plus gros problème. Lorsqu’un modèle classe un produit dans la mauvaise catégorie ou associe à tort deux clients différents, ces erreurs se propagent dans vos systèmes, entraînant des problèmes de qualité des données susceptibles d’affecter les opérations commerciales.
L'automatisation partielle ne suffit pas
De nombreuses entreprises répondent à ce défi par une approche hybride : elles utilisent le ML pour le traitement initial, puis vérifient manuellement les résultats. Bien qu’elle soit toujours plus efficace que des processus entièrement manuels, cette approche :
- Crée des goulots d’étranglement lors des périodes de forte activité
- Nécessite toujours d’importantes ressources humaines
- limite les avantages en termes d’évolutivité que vous recherchez avec l’apprentissage automatique
- retarde les processus où le temps est un facteur critique
Le déficit de vérification
Le problème fondamental n’est pas que le ML commette des erreurs, mais l’absence d’un mécanisme fiable permettant de vérifier quelles prédictions sont fiables.
Sans savoir quelles prédictions sont assurément correctes, vous êtes contraint de tout vérifier ou d’accepter un certain niveau d’erreur dans vos données de référence.
Ce déficit de vérification constitue l’obstacle majeur entre le traitement assisté et la véritable automatisation. Et pour combler ce déficit, vous avez besoin d’une approche fondamentalement différente qui combine les capacités de reconnaissance de formes du ML avec des méthodes capables d’apporter une certitude mathématique quant à la précision des prédictions.
Après tout : vous n’avez pas besoin de savoir que votre modèle est précis à 95 % dans l’ensemble. Vous devez savoir à quels 95 % des prédictions vous pouvez vous fier.
Il s’agit en effet d’un problème difficile à résoudre, dont la nature varie selon les cas d’utilisation. Mais chez Stibo Systems, nous ne ménageons aucun effort pour relever de tels défis, et pour y parvenir, nous commençons par la vérification des recommandations de classification fournies par l’assistance IA – un processus également appelé, dans le domaine de la recherche, « mappage ontologique » (classification).
Comment intégrer des mécanismes de vérification mathématiques dans votre modèle d’apprentissage automatique
Nos recherches menées en collaboration avec l’Université technique du Danemark (DTU) – l’une des principales universités techniques d’Europe, également désignée comme la meilleure université technique du Danemark – ont abouti à une approche révolutionnaire.
Elle allie la rapidité de l’apprentissage automatique à la certitude de la vérification mathématique.
Les défis de vérification que nous relevons
Lorsqu’on utilise l’IA pour établir des correspondances entre des systèmes de classification – par exemple, en faisant correspondre les « outils à main » d’une taxonomie de produits aux « outils portatifs » d’une autre –, les modèles d’apprentissage automatique peuvent produire des prédictions impressionnantes.
Mais ces prédictions comportent toujours une incertitude statistique susceptible de nuire à la confiance. Et la confiance, dans ce contexte, est en quelque sorte binaire : soit vous pouvez vous fier à vos résultats, soit vous ne le pouvez pas (et devez alors les vérifier).
La question clé est celle de la cohérence. Comment vérifier que les relations de mise en correspondance sont logiquement cohérentes à l’échelle de l’ensemble des structures de classification ?
La certitude mathématique au service de l’application pratique
Dans notre solution, nous appliquons des méthodes mathématiques formelles pour valider la cohérence logique des correspondances recommandées. La preuve mathématique confirme quelles prédictions sont correctes, et pas seulement statistiquement probables.
Pour cela, nous utilisons plus précisément la logique propositionnelle et les « clauses de Horn ».
Que sont les clauses de Horn ?
Le terme peut paraître complexe, mais il s’agit simplement d’énoncés logiques qui suivent un schéma « si… alors ». Par exemple : « si un produit est un marteau ET que les marteaux font partie des outils à main, ALORS le produit fait partie des outils à main ». En appliquant ces règles logiques à l’ensemble des systèmes de classification, nous pouvons vérifier mathématiquement si les correspondances sont cohérentes.
Mais vous vous demandez peut-être : si les méthodes formelles apportent la certitude dont nous avons besoin, pourquoi recourir au ML ?
La réponse réside dans l’efficacité de calcul. L’application des seules méthodes formelles à de grandes structures de classification serait trop coûteuse en termes de calcul pour une utilisation pratique.
En combinant ces deux approches, nous tirons le meilleur parti des deux mondes :
- les prédictions rapides issues de l’apprentissage automatique réduisent le nombre de correspondances possibles.
- La vérification mathématique confirme quelles prédictions sont définitivement correctes.
- Seules les prédictions incertaines nécessitent une vérification humaine.
Cette approche hybride réduit considérablement la charge de travail liée à la vérification tout en préservant la précision, rendant ainsi possible une véritable automatisation.
Pour approfondir le sujet : ces travaux ont été publiés dans « The Practice of Formal Methods », un recueil d’essais en l’honneur de Cliff Jones.
Chez Stibo Systems, nous mettons cela en pratique
Les fondements mathématiques sont inébranlables : la logique formelle est soit correcte, soit incorrecte, sans demi-mesure. Le plus passionnant réside dans l’application de ces principes aux défis concrets de la gestion des données de référence (MDM).
Notre mise en œuvre se concentre actuellement sur des scénarios à haut volume où la vérification crée d’importants goulots d’étranglement.
Par exemple, pour les détaillants qui intègrent régulièrement des milliers d’articles provenant de fournisseurs, la capacité à valider automatiquement les catégorisations suggérées par l’IA crée une valeur considérable tout au long du processus.
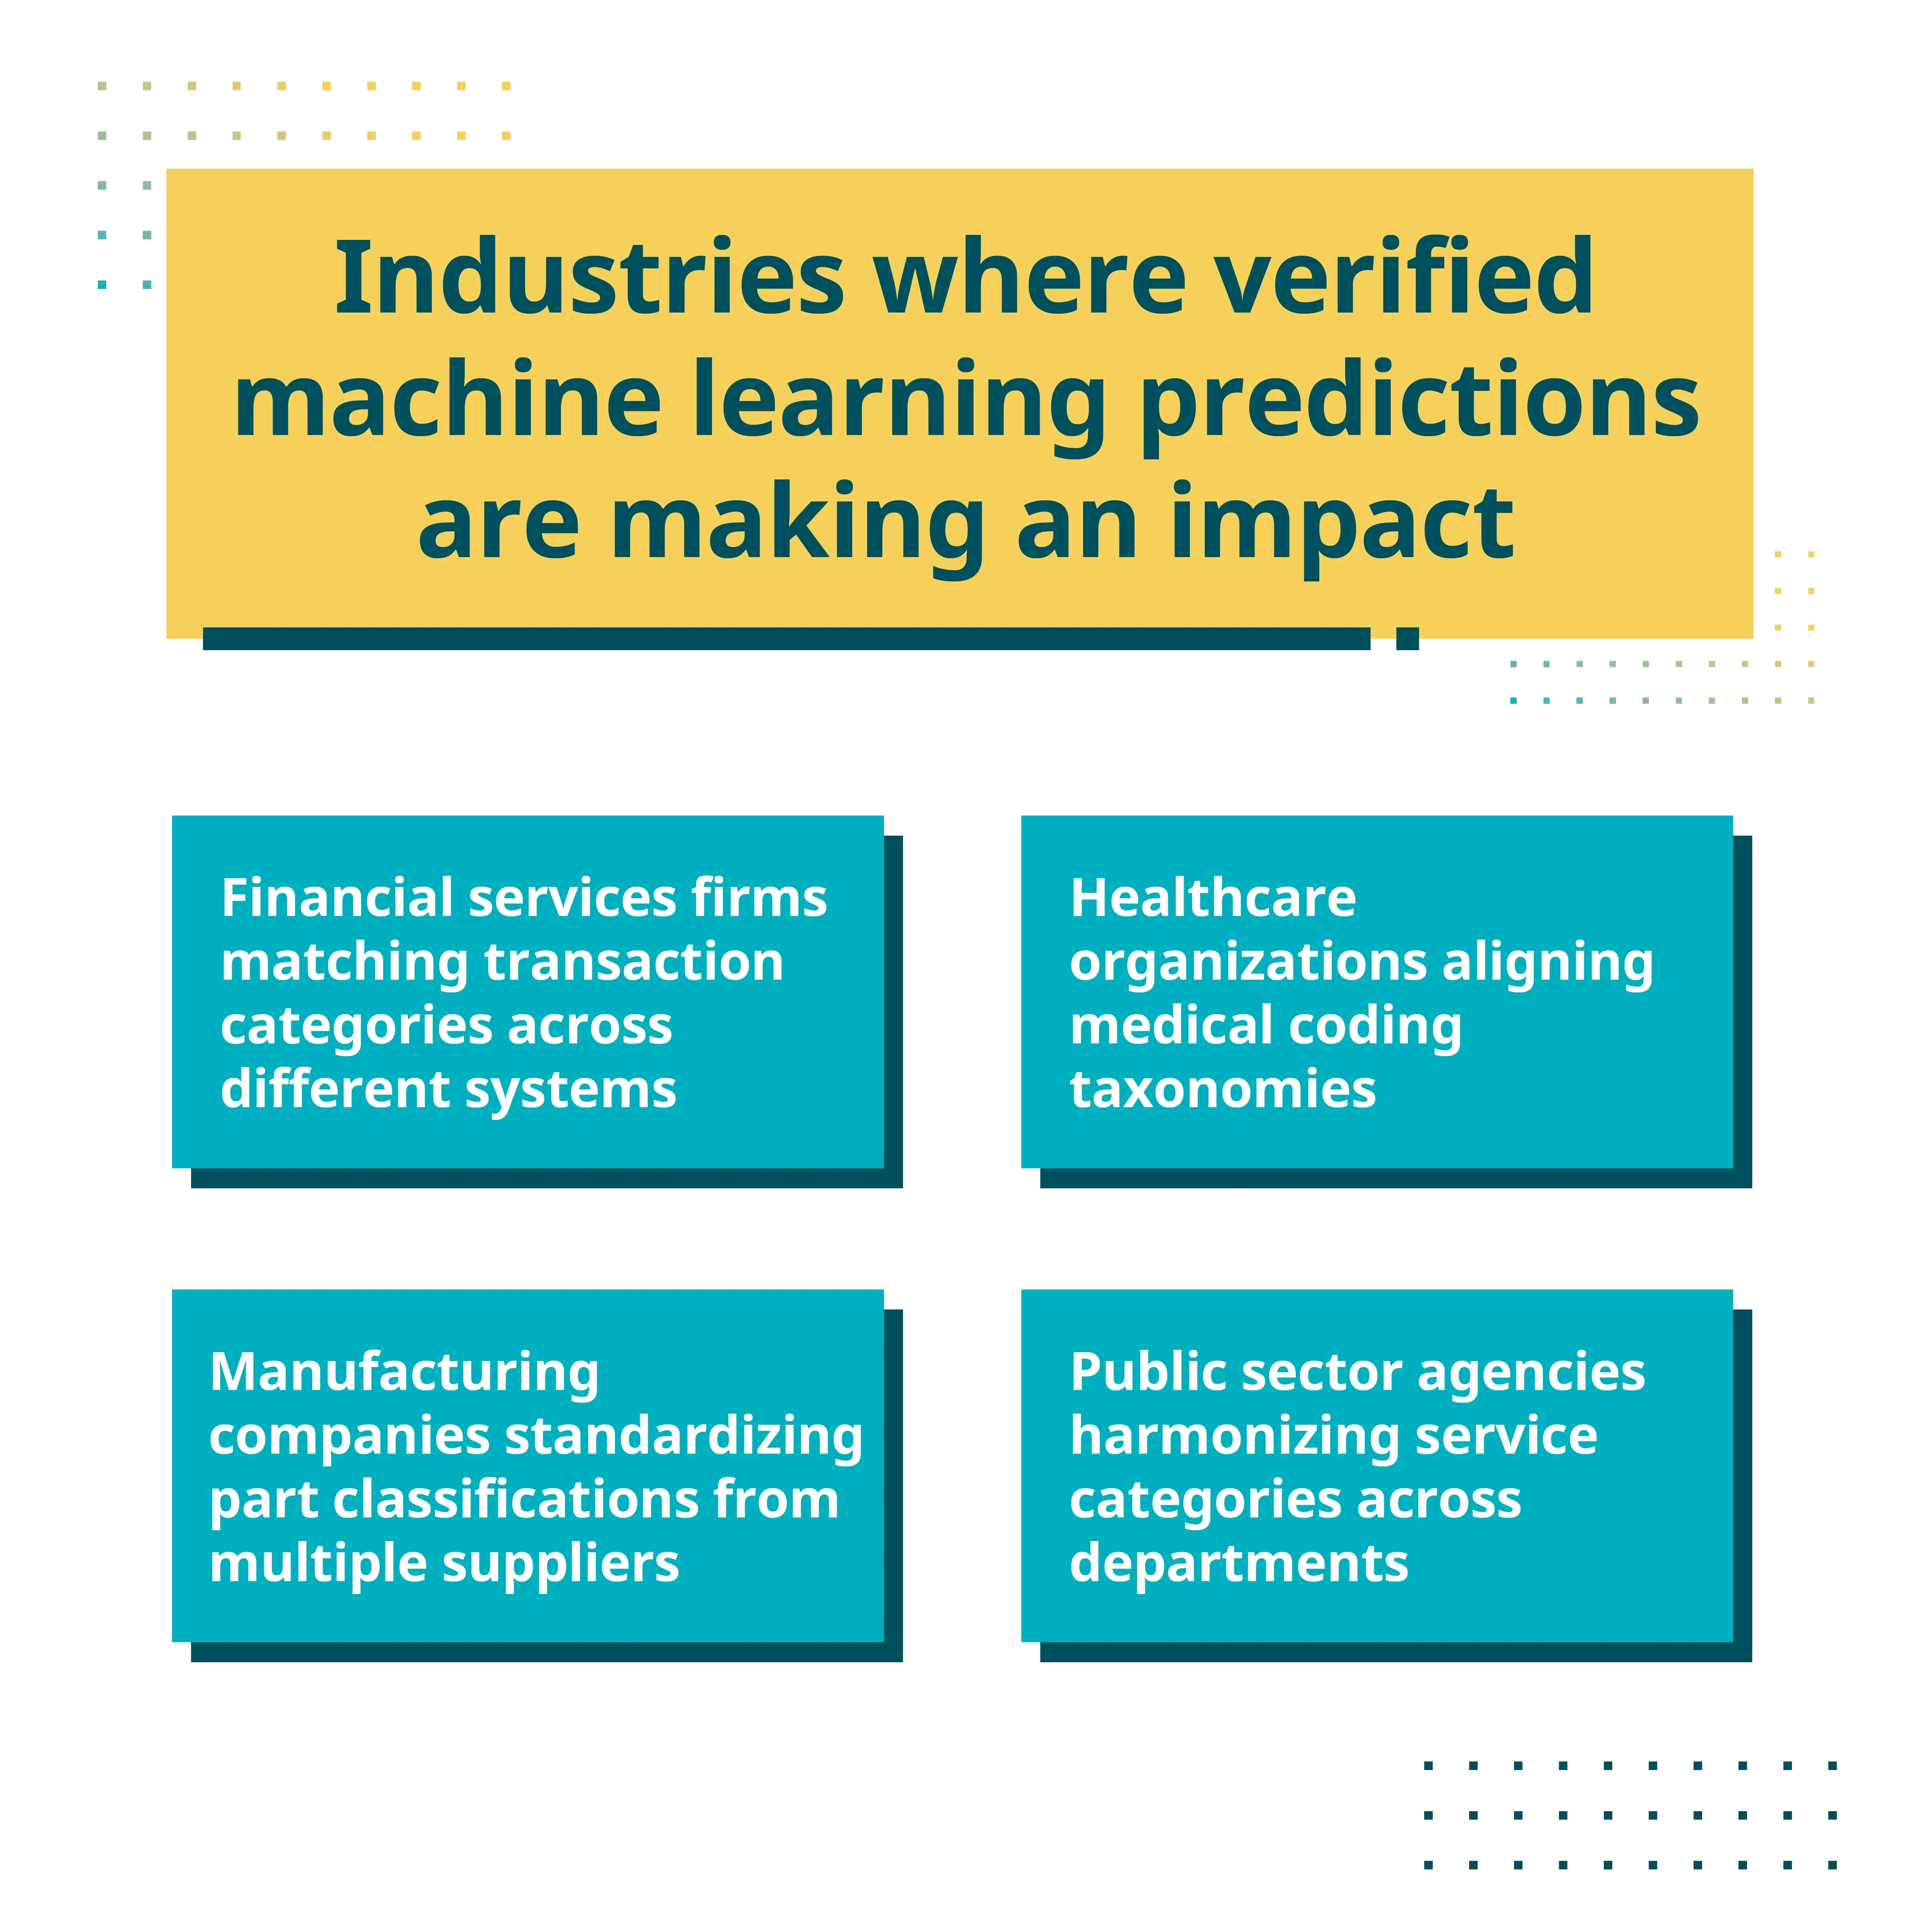
Mais nous travaillons avec des entreprises issues de nombreux secteurs, et les cas d’utilisation potentiels sont innombrables :
- Les sociétés de services financiers qui harmonisent les catégories de transactions entre différents systèmes
- Des organismes de santé harmonisant les taxonomies de codage médical
- Des entreprises manufacturières qui standardisent les classifications de pièces provenant de plusieurs fournisseurs
- Les organismes du secteur public qui harmonisent les catégories de services entre les différents services
Toute situation impliquant l’alignement de taxonomies, la mise en correspondance de classifications ou la normalisation entre différents systèmes pourrait bénéficier de prédictions vérifiées.
État d’avancement de notre mise en œuvre
Nous testons actuellement des prototypes en conditions réelles.
Bien que la mise en œuvre n’en soit qu’à ses débuts, la vérification mathématique fonctionne exactement comme prévu : elle identifie correctement les prédictions fiables. La prochaine étape consistera à affiner l’expérience utilisateur et à étendre les capacités de vérification à davantage de scénarios de gestion des données.
Résumons
La confiance reste le principal obstacle à une véritable automatisation de la gestion des données. Notre combinaison d’apprentissage automatique et de vérification mathématique nous offre une voie pratique qui ne vous oblige pas à choisir entre rapidité et précision.
Le rôle de l’humain restera toujours essentiel dans la gestion des données, mais nous pouvons désormais orienter cette expertise là où elle apporte le plus de valeur ajoutée – et non vers des tâches routinières que l’IA vérifiée peut gérer de manière fiable.
Lorsque vous pouvez vous fier aux prédictions de votre apprentissage automatique, vous pouvez enfin automatiser en toute confiance.
Gestion des données de référence alimentée par l'IA
Débloquez la puissance de l'IA dans vos processus MDM pour naviguer dans les dynamiques complexes de la chaîne d'approvisionnement avec plus d'agilité et de prévoyance.