En cualquier gran organización, si te dedicas a la gestión de datos maestros (MDM), te enfrentas constantemente a los flujos de datos de los proveedores, el cumplimiento normativo, los indicadores de sostenibilidad, el reparto de cuotas de mercado... todo ello mientras debes mantener bajos los costes y alta la satisfacción.
Con el aprendizaje automático (ML), puedes automatizar tareas repetitivas y que requieren mucho tiempo a una velocidad increíble, pero confiar en las predicciones de la IA supone un verdadero reto.
Cuando tu modelo de ML sugiere categorías incorrectas para los productos o identifica erróneamente las relaciones, esos errores generan problemas posteriores que pueden anular las mejoras en eficiencia.
Al fin y al cabo, si tienes que verificar manualmente cada decisión de la IA, ¿realmente estás ahorrando recursos?
En Stibo Systems, combinamos la velocidad del ML con la verificación matemática, lo que te permite alcanzar una verdadera automatización con el nivel de precisión que tu empresa necesita.
Y en esta entrada del blog, compartiré cómo hemos llegado hasta aquí y cómo funciona. Obtendrás el contexto Y las conclusiones clave.
¿Por qué necesitamos que las máquinas nos ayuden con la gestión de datos maestros (MDM)?
Probablemente te parezca que tu carga de trabajo en la gestión de datos está creciendo más rápido que tu capacidad para gestionarla. No estás solo. Los gestores de datos de hoy en día se mueven en un panorama complejo en el que la precisión, la velocidad y el volumen compiten por la prioridad.
- Incorporar surtidos masivos de productos de proveedores con formatos de datos y calidad inconsistentes
- Mantener procesos de gobernanza que garanticen la fiabilidad de tus datos en todos los sistemas
- Cumplir con unos requisitos normativos en constante evolución
- Gestionar una gama cada vez mayor de datos sobre sostenibilidad y ESG
- Distribuir datos limpios y coherentes a diversos canales y mercados
Los enfoques tradicionales para abordar estos retos suelen depender en gran medida de procesos manuales, reglas de negocio y la verificación humana.
Esto puede funcionar a pequeña escala, pero cuando los volúmenes de datos crecen, surgen cuellos de botella. Un gestor de producto que antes podía verificar 50 nuevos artículos al día se enfrenta ahora a lotes de miles, lo que hace que la revisión manual resulte inviable.
Y no se trata solo de ahorrar tiempo, sino de mantener la ventaja competitiva. Cuando tus competidores pueden incorporar nuevos productos más rápido, actualizar la información con mayor rapidez y distribuir los datos de forma más eficaz, obtienen ventajas cruciales en el mercado. Los procesos manuales simplemente no pueden escalar para satisfacer estas demandas sin una inversión significativa en recursos.
Lo que hace que estos retos sean especialmente adecuados para la intervención tecnológica es su naturaleza repetitiva y basada en patrones. A menudo se trata de reconocer similitudes, aplicar reglas coherentes y tomar decisiones basadas en pruebas.
Exactamente el tipo de trabajo en el que destaca el aprendizaje automático (ML).
Cómo el aprendizaje automático (ML) ha cambiado por completo las reglas del juego
El aprendizaje automático (ML) encaja a la perfección con las tareas más laboriosas de la gestión de datos.
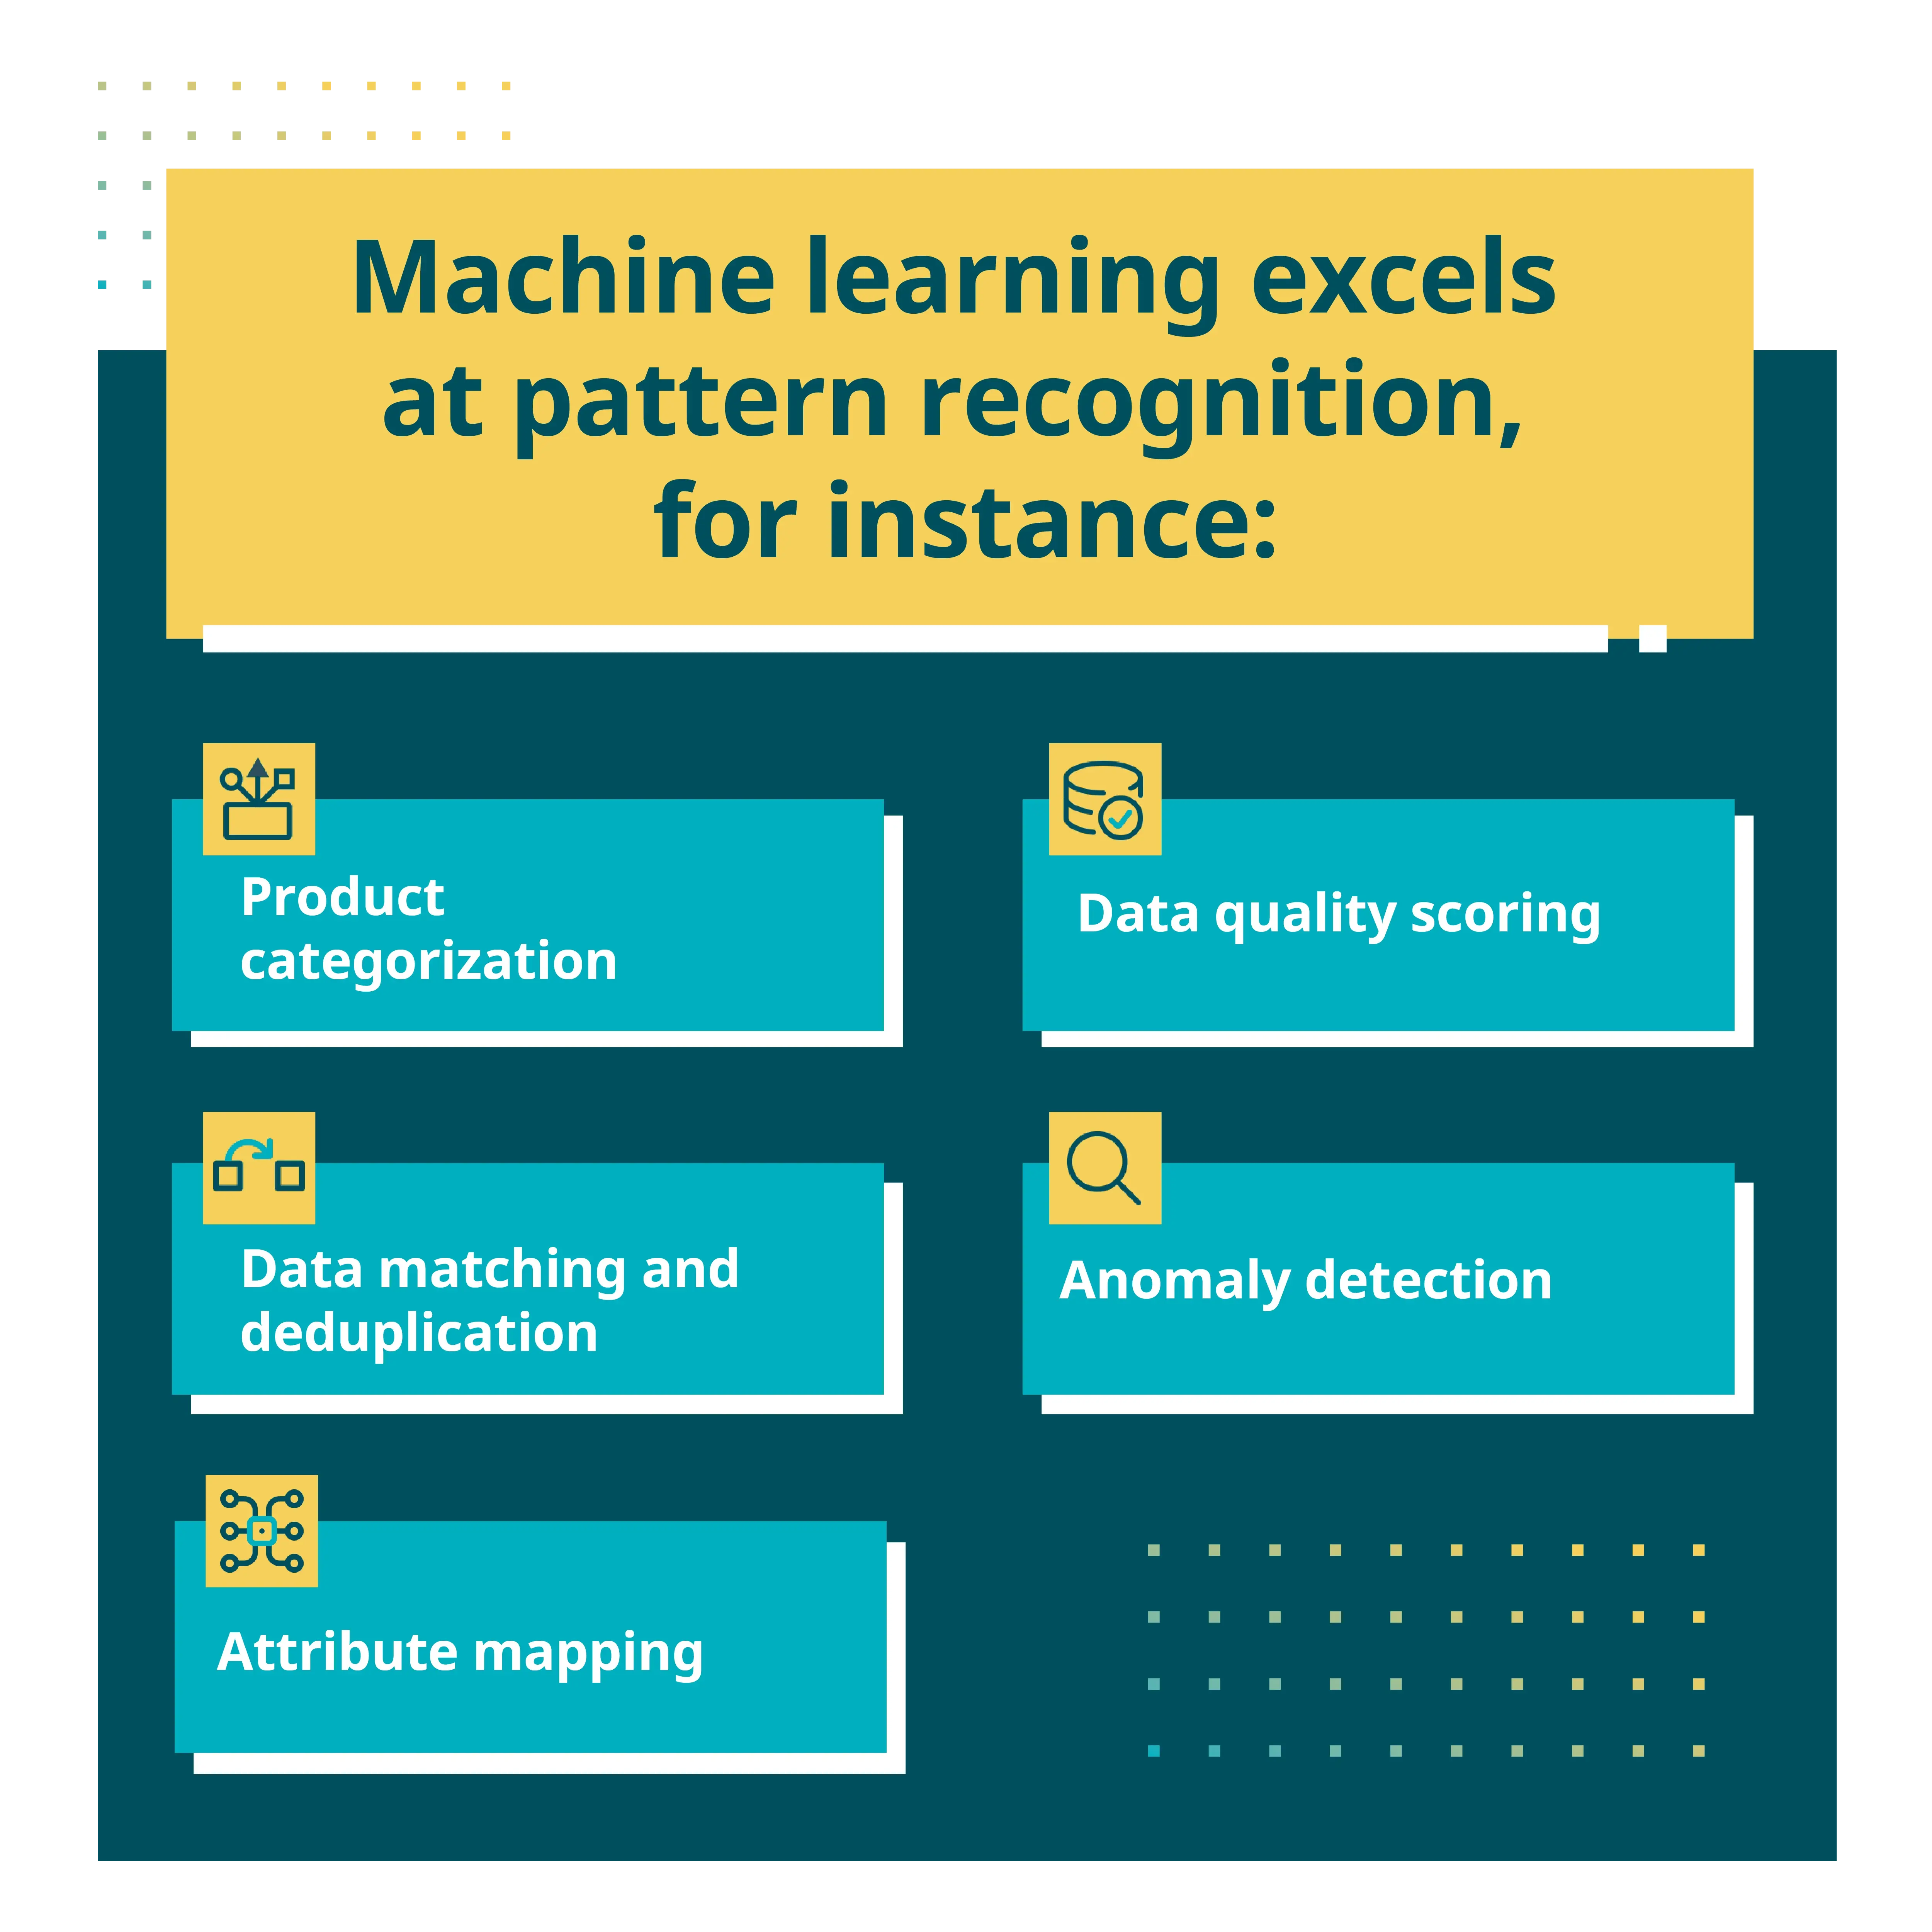
En esencia, el aprendizaje automático destaca en el reconocimiento de patrones, la categorización y la predicción, precisamente lo que se necesita a la hora de gestionar grandes volúmenes de datos complejos. Tomemos estos ejemplos, por ejemplo:
-
Categorización de productos
Asignar automáticamente los nuevos productos a las categorías correctas de tu taxonomía. -
Cotejo y deduplicación de datos
Identificación de los casos en los que distintos registros representan la misma entidad del mundo real. -
Asignación de atributos
Vinculación de los atributos específicos de cada proveedor a su modelo de datos estandarizado. -
Evaluación de la calidad de los datos
Predicción de los niveles de exhaustividad y precisión sin necesidad de revisión manual. -
Detección de anomalías
Señalización de patrones de datos inusuales que podrían indicar errores u oportunidades.
La mejora en la eficiencia puede ser notable. Tareas que antes llevaban días se pueden realizar en cuestión de minutos. Y no se trata solo de la rapidez:
El aprendizaje automático aporta coherencia
La clasificación humana varía naturalmente de una persona a otra e incluso en la misma persona en momentos distintos. El aprendizaje automático aplica la misma lógica de forma coherente (estadísticamente). De este modo, se limita la variabilidad que provoca problemas con los datos en fases posteriores del proceso.
El aprendizaje automático se adapta a medida que evoluciona tu negocio
Con los sistemas tradicionales basados en reglas, es necesario reprogramar explícitamente el sistema cuando cambian las condiciones de tu negocio. Los modelos de aprendizaje automático, por el contrario, pueden detectar patrones cambiantes en tus datos y ajustarse en consecuencia. Esta adaptabilidad significa que tus procesos de gestión de datos se mantienen al día con una intervención mínima.
Pero estas ventajas vienen acompañadas de una advertencia importante: las predicciones son tan buenas como la precisión del modelo. Y ahí es donde muchos equipos de gestión de datos se topan con un obstáculo en su camino hacia la automatización.
Si no puedes confiar en tu aprendizaje automático, todo se viene abajo
Las predicciones de aprendizaje automático conllevan una incertidumbre inherente. Aunque los modelos de aprendizaje automático son buenos para reconocer patrones, no ofrecen la certeza de una demostración matemática. Esto plantea un problema de confianza que puede limitar significativamente el potencial de la automatización.
El dilema de la precisión
Todo modelo de aprendizaje automático (ML) presenta cierto grado de imprecisión, que suele manifestarse de dos formas:
- Falsos negativos, en los que no se reconocen coincidencias válidas
- Falsos positivos, en los que se establecen coincidencias incorrectas
En la gestión de datos, los falsos positivos suponen el mayor problema. Cuando un modelo clasifica incorrectamente un producto o empareja erróneamente a dos clientes diferentes, estos errores se propagan por los sistemas, lo que genera problemas de calidad de los datos que pueden afectar a las operaciones empresariales.
La automatización parcial no es suficiente
Muchas organizaciones responden a este reto con un enfoque híbrido: utilizan el aprendizaje automático para el procesamiento inicial y, a continuación, revisan manualmente los resultados. Aunque sigue siendo mejor que los procesos totalmente manuales, este enfoque:
- Crea cuellos de botella en la revisión durante los periodos de gran volumen
- Sigue requiriendo importantes recursos humanos
- Limita las ventajas de escalabilidad que se buscan con el aprendizaje automático
- Retrasa los procesos en los que el tiempo es un factor crítico
La brecha de verificación
El problema fundamental no es que el aprendizaje automático cometa errores, sino la falta de un mecanismo fiable para verificar en qué predicciones se puede confiar.
Sin saber qué predicciones son indudablemente correctas, te ves obligado a verificarlo todo o a aceptar un cierto nivel de error en tus datos maestros.
Esta brecha de verificación representa la barrera fundamental entre el procesamiento asistido y la verdadera automatización. Y para cerrarla, necesitas un enfoque radicalmente diferente que combine las capacidades de reconocimiento de patrones del aprendizaje automático con métodos que puedan proporcionar certeza matemática sobre la precisión de las predicciones.
Al fin y al cabo: no hace falta saber que tu modelo tiene una precisión global del 95 %. Lo que necesitas saber es en qué 95 % de las predicciones puedes confiar.
Se trata, sin duda, de un problema difícil de abordar, cuya naturaleza varía según los casos de uso. Pero en Stibo Systems nos esforzamos sin descanso por resolver este tipo de retos y, para abordar este en concreto, estamos empezando por la verificación de las recomendaciones de clasificación de la asistencia de IA —lo que en el ámbito de la investigación también se conoce como mapeo ontológico (de clasificación)—.
Cómo integrar mecanismos de verificación matemática en tu modelo de aprendizaje automático
Nuestra investigación con la Universidad Técnica de Dinamarca (DTU) —una de las universidades técnicas líderes en Europa, también nombrada la mejor universidad técnica de Dinamarca— ha dado lugar a un enfoque revolucionario.
Combina la velocidad del aprendizaje automático con la certeza de la verificación matemática.
Los retos de verificación que estamos resolviendo
Al utilizar la IA para establecer correspondencias entre sistemas de clasificación —por ejemplo, al hacer coincidir «herramientas manuales» en una taxonomía de productos con «herramientas portátiles» en otra—, los modelos de aprendizaje automático pueden realizar predicciones impresionantes.
Pero esas predicciones siempre conllevan una incertidumbre estadística que puede minar la confianza. Y la confianza, en este contexto, es algo binario: o bien puedes confiar en tus resultados, o bien no puedes (y tienes que volver a comprobarlos).
La cuestión clave es la coherencia. ¿Cómo se puede verificar que las relaciones de correspondencia tengan sentido lógico en todas las estructuras de clasificación?
La certeza matemática se une a la aplicación práctica
En nuestra solución, aplicamos métodos matemáticos formales para validar que las correspondencias recomendadas sean lógicamente coherentes. La demostración matemática confirma qué predicciones son correctas, no solo estadísticamente probables.
Para ello, utilizamos específicamente la lógica proposicional y las «cláusulas de Horn».
¿Qué son las cláusulas de Horn?
Pueden parecer complejas, pero no son más que enunciados lógicos que siguen un patrón «si… entonces». Por ejemplo: «si un producto es un martillo Y los martillos pertenecen a las herramientas manuales, ENTONCES el producto pertenece a las herramientas manuales». Al aplicar estas reglas lógicas a los sistemas de clasificación, podemos verificar matemáticamente si las asignaciones tienen sentido.
Pero quizá te preguntes: si los métodos formales nos proporcionan la certeza que necesitamos, ¿por qué utilizar el aprendizaje automático?
La respuesta radica en la eficiencia computacional. Aplicar únicamente métodos formales a grandes estructuras de clasificación resultaría demasiado costoso desde el punto de vista computacional para un uso práctico.
Al combinar ambos enfoques, obtenemos lo mejor de ambos mundos:
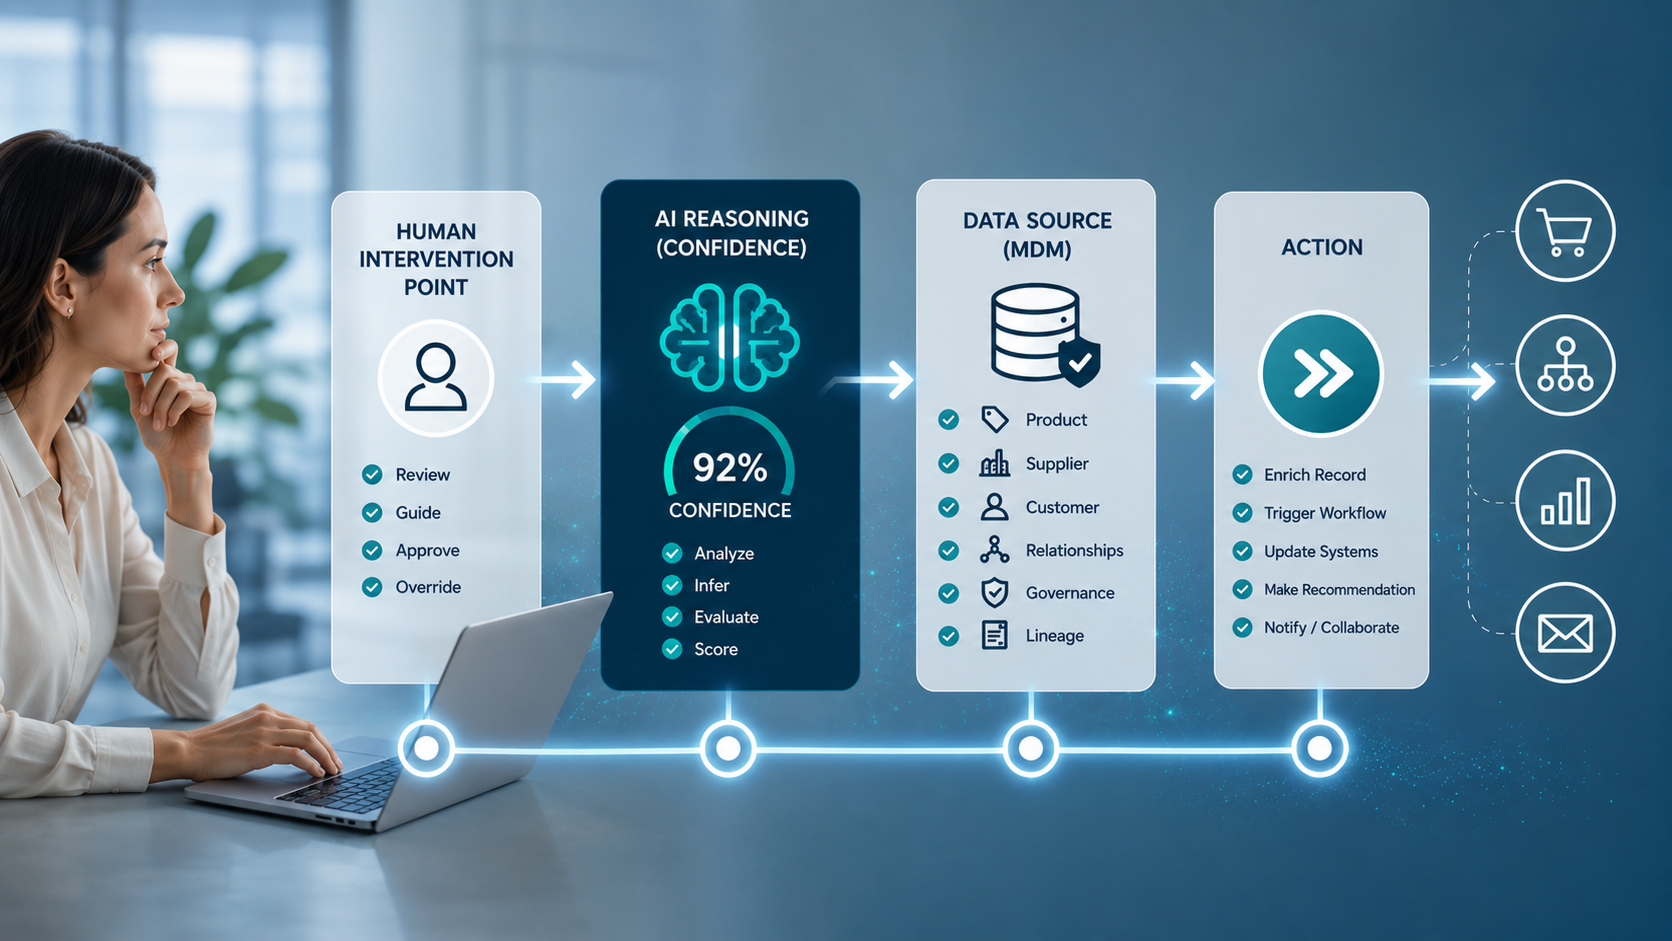
- Las predicciones rápidas del aprendizaje automático reducen las posibles correspondencias.
- La verificación matemática confirma qué predicciones son definitivamente correctas.
- Solo las predicciones inciertas requieren revisión humana.
El enfoque híbrido reduce drásticamente la carga de trabajo de verificación al tiempo que mantiene la precisión, lo que hace posible una verdadera automatización.
Profundiza en todo esto: este trabajo se ha publicado en «The Practice of Formal Methods», un ensayo en homenaje a Cliff Jones.
En Stibo Systems, estamos aplicando esto en la vida real
Los fundamentos matemáticos son sólidos como una roca: la lógica formal es correcta o incorrecta, sin término medio. Lo más emocionante es aplicar estos principios a los retos del MDM en el mundo real.
Nuestra implementación se centra actualmente en escenarios de gran volumen en los que la verificación genera importantes cuellos de botella.
Por ejemplo, para los minoristas que incorporan regularmente miles de artículos de proveedores, la capacidad de validar automáticamente las categorizaciones sugeridas por la IA aporta un enorme valor a lo largo de todo el proceso.
Pero trabajamos con empresas de muchos sectores, con posibles casos de uso en todas partes:
- Empresas de servicios financieros que concilian categorías de transacciones entre distintos sistemas
- Organizaciones sanitarias que armonizan las taxonomías de codificación médica
- Empresas manufactureras que estandarizan las clasificaciones de piezas de múltiples proveedores
- Organismos del sector público que armonizan las categorías de servicios entre departamentos
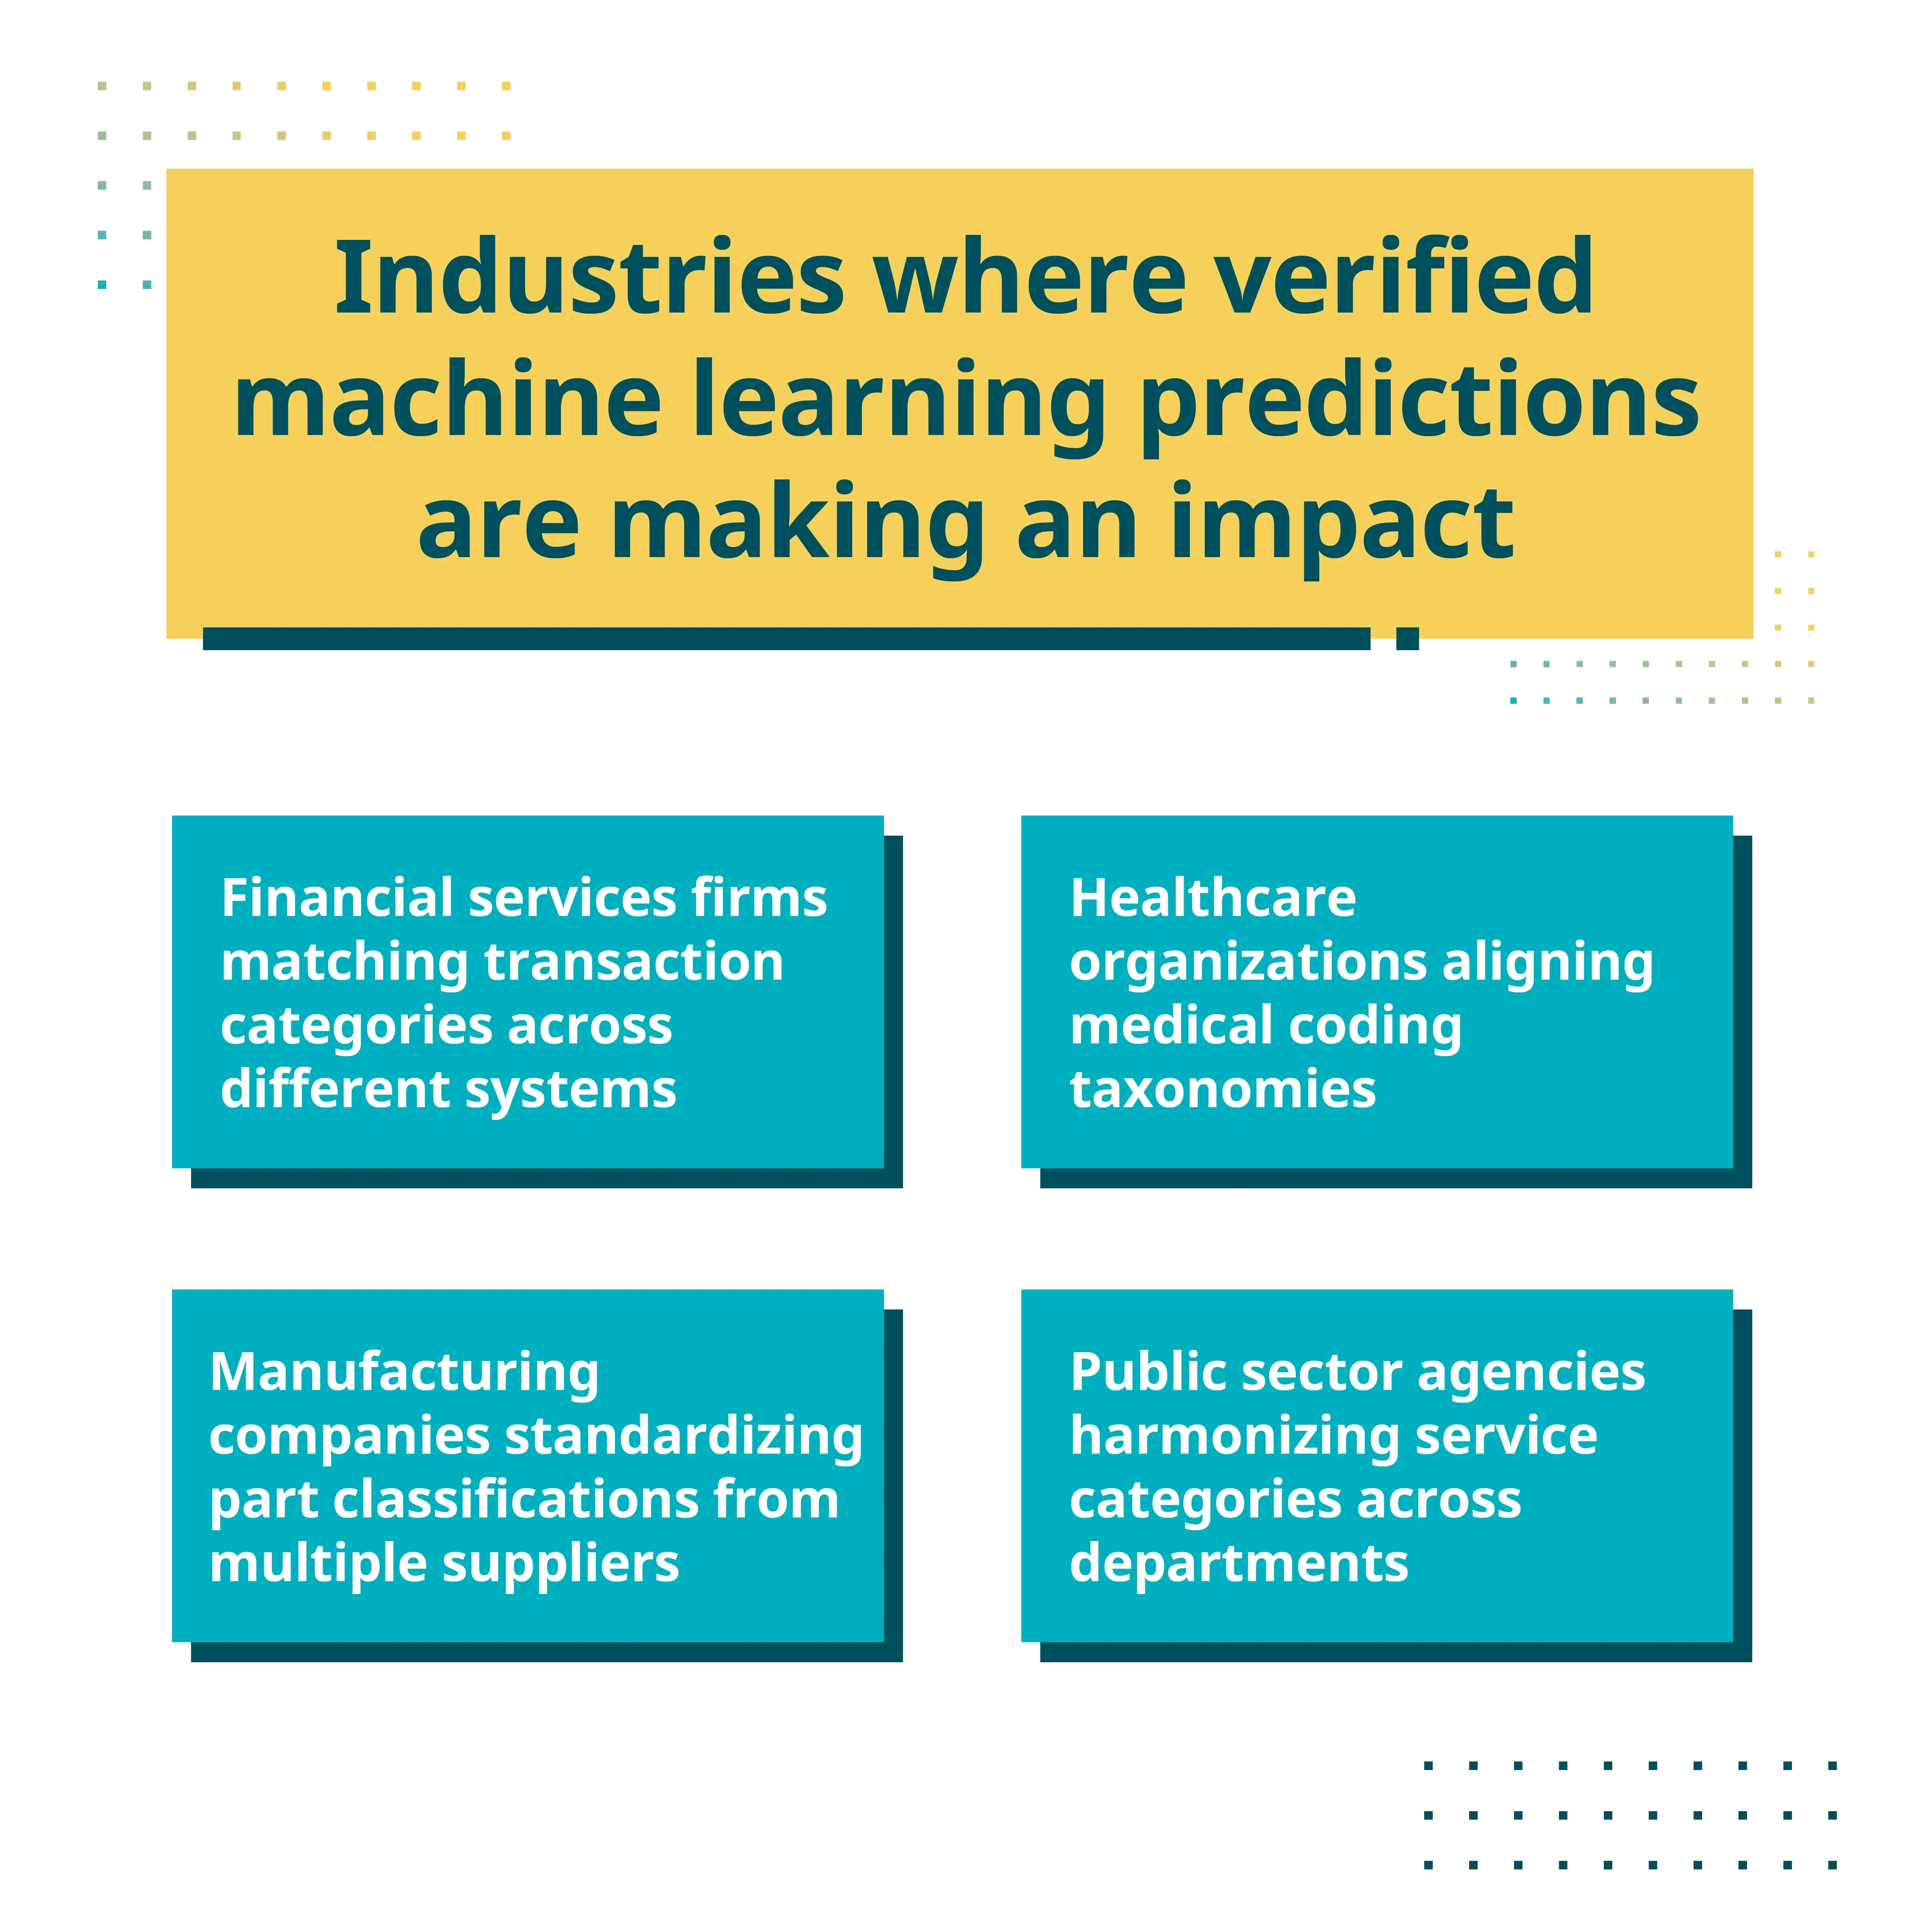
Cualquier situación que implique la armonización de taxonomías, la correspondencia de clasificaciones o la estandarización entre sistemas podría beneficiarse de predicciones verificadas.
Estado actual de nuestra implementación
Actualmente estamos probando prototipos en entornos reales.
Aunque aún nos encontramos en una fase temprana de la implementación, la verificación matemática funciona exactamente como se esperaba: identifica correctamente en qué predicciones se puede confiar. La siguiente fase consiste en perfeccionar la experiencia del usuario y ampliar las capacidades de verificación a más escenarios de gestión de datos.
Resumamos
La confianza sigue siendo el mayor obstáculo para la verdadera automatización en la gestión de datos. Nuestra combinación de aprendizaje automático con verificación matemática nos ofrece una vía práctica que no te obliga a elegir entre velocidad y precisión.
El papel humano siempre será importante en la gestión de datos, pero ahora podemos dirigir esa experiencia hacia donde aporta más valor, y no hacia tareas rutinarias que la IA verificada puede gestionar de forma fiable.
Cuando puedas confiar en tus predicciones de aprendizaje automático, por fin podrás automatizar con confianza.
Gestión de Datos Maestros Potenciada por IA
Desbloquea el poder de la IA en tus procesos de MDM para navegar las complejas dinámicas de la cadena de suministro con mayor agilidad y previsión.