In qualsiasi grande organizzazione, se ti occupi di gestione dei dati master (MDM), ti trovi costantemente alle prese con i flussi di dati dei fornitori, la conformità normativa, gli indicatori di sostenibilità, la condivisione sui marketplace... il tutto mentre devi contenere i costi e mantenere alta la soddisfazione.
Grazie al machine learning (ML), puoi automatizzare attività ripetitive e dispendiose in termini di tempo a velocità incredibili, ma affidarti alle previsioni dell’IA rappresenta una vera sfida.
Quando il tuo modello di ML suggerisce categorie errate per i prodotti o identifica in modo errato le relazioni, tali errori generano problemi a valle che possono vanificare i guadagni in termini di efficienza.
Dopotutto, se devi verificare manualmente ogni decisione dell’IA, stai davvero risparmiando risorse?
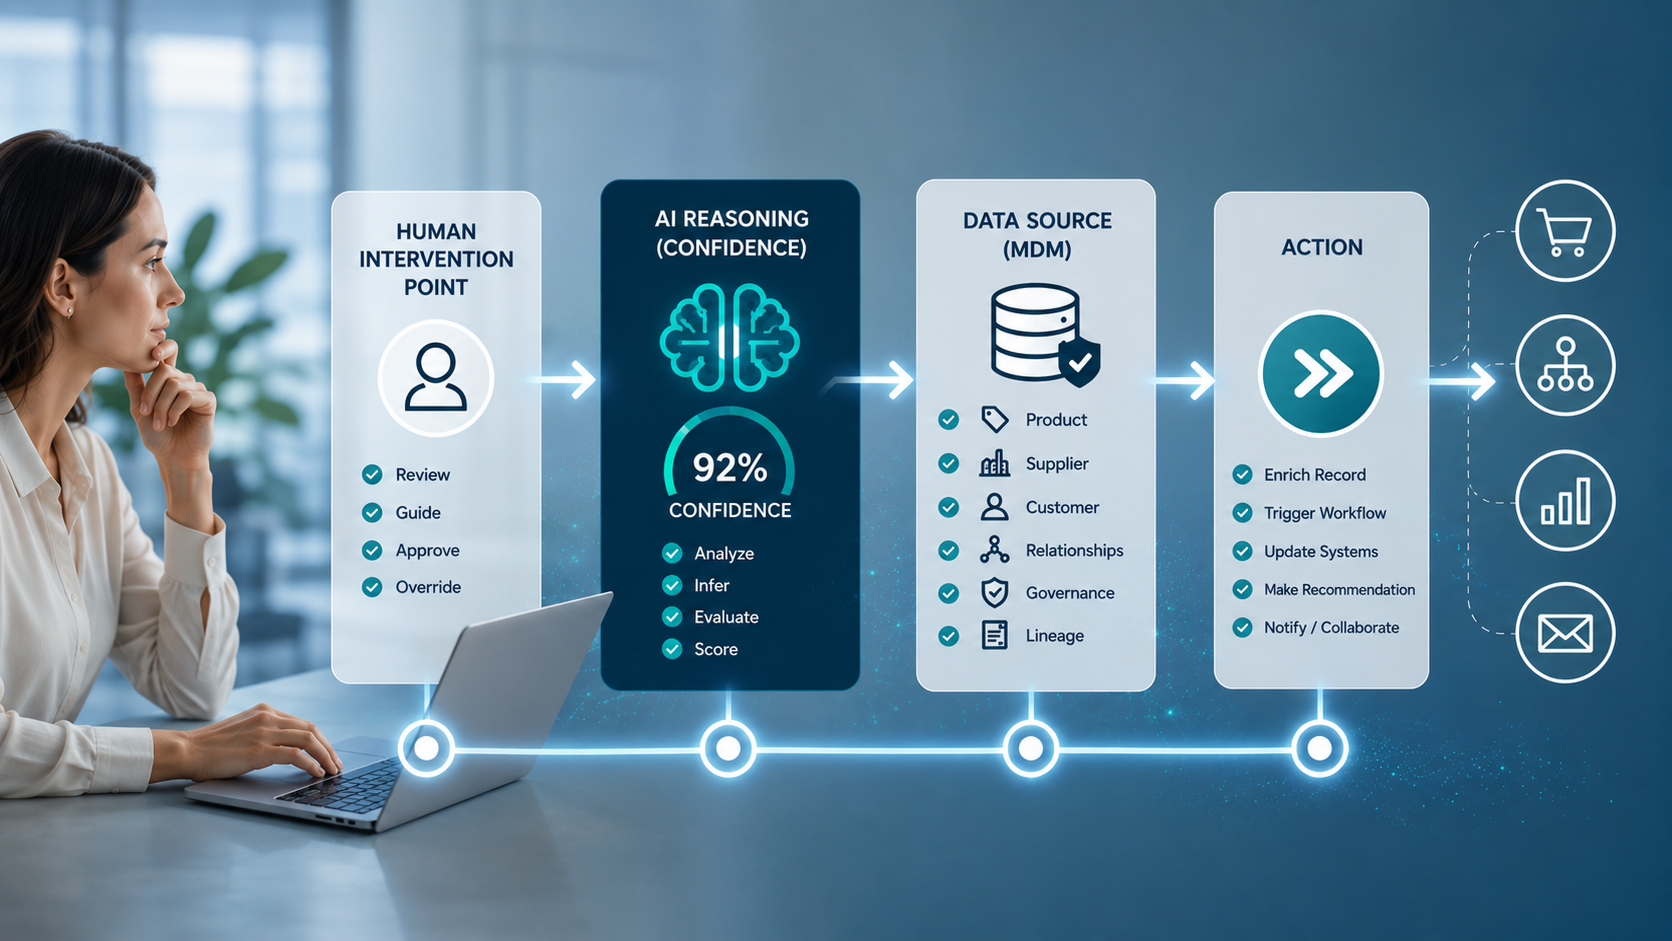
Noi di Stibo Systems stiamo combinando la velocità del ML con la verifica matematica, consentendovi di raggiungere una vera automazione con il livello di precisione di cui la vostra azienda ha bisogno.
E in questo post del blog vi spiegherò come ci siamo arrivati e come funziona. Vi fornirò sia il contesto che i punti chiave.
Perché abbiamo bisogno delle macchine per l’MDM?
Probabilmente vi sembra che il carico di lavoro legato alla gestione dei dati stia crescendo più rapidamente della vostra capacità di gestirlo. Non siete i soli. Oggi i responsabili della gestione dei dati si trovano ad affrontare un panorama complesso in cui precisione, velocità e volume competono per la priorità.
- Inserimento di vasti assortimenti di prodotti provenienti da fornitori con formati e qualità dei dati non uniformi
- Mantenere processi di governance che garantiscano l’affidabilità dei dati su tutti i sistemi
- Rimanere conformi a requisiti normativi in continua evoluzione
- Gestire una gamma sempre più ampia di dati relativi alla sostenibilità e ai criteri ESG
- Distribuire dati puliti e coerenti a vari canali e marketplace
Gli approcci tradizionali a queste sfide spesso si basano in larga misura su processi manuali, regole aziendali e verifiche umane.
Questo può funzionare su scala ridotta, ma quando i volumi di dati crescono si creano colli di bottiglia. Un product manager che un tempo riusciva a verificare 50 nuovi articoli al giorno si trova ora a gestire lotti di migliaia di elementi, rendendo impraticabile la revisione manuale.
E non si tratta solo di risparmiare tempo, ma di mantenere un vantaggio competitivo. Quando i vostri concorrenti riescono a inserire nuovi prodotti più rapidamente, ad aggiornare le informazioni più velocemente e a distribuire i dati in modo più efficace, ottengono vantaggi di mercato cruciali. I processi manuali semplicemente non possono essere scalati per soddisfare queste esigenze senza investimenti significativi in termini di risorse.
Ciò che rende queste sfide particolarmente adatte a un intervento tecnologico è la loro natura ripetitiva e basata su schemi. Spesso si tratta di riconoscere somiglianze, applicare regole coerenti e prendere decisioni basate su dati concreti.
Esattamente il tipo di lavoro in cui il ML eccelle.
Come il ML ha cambiato completamente le regole del gioco
Il ML si adatta perfettamente alle attività più laboriose della gestione dei dati.
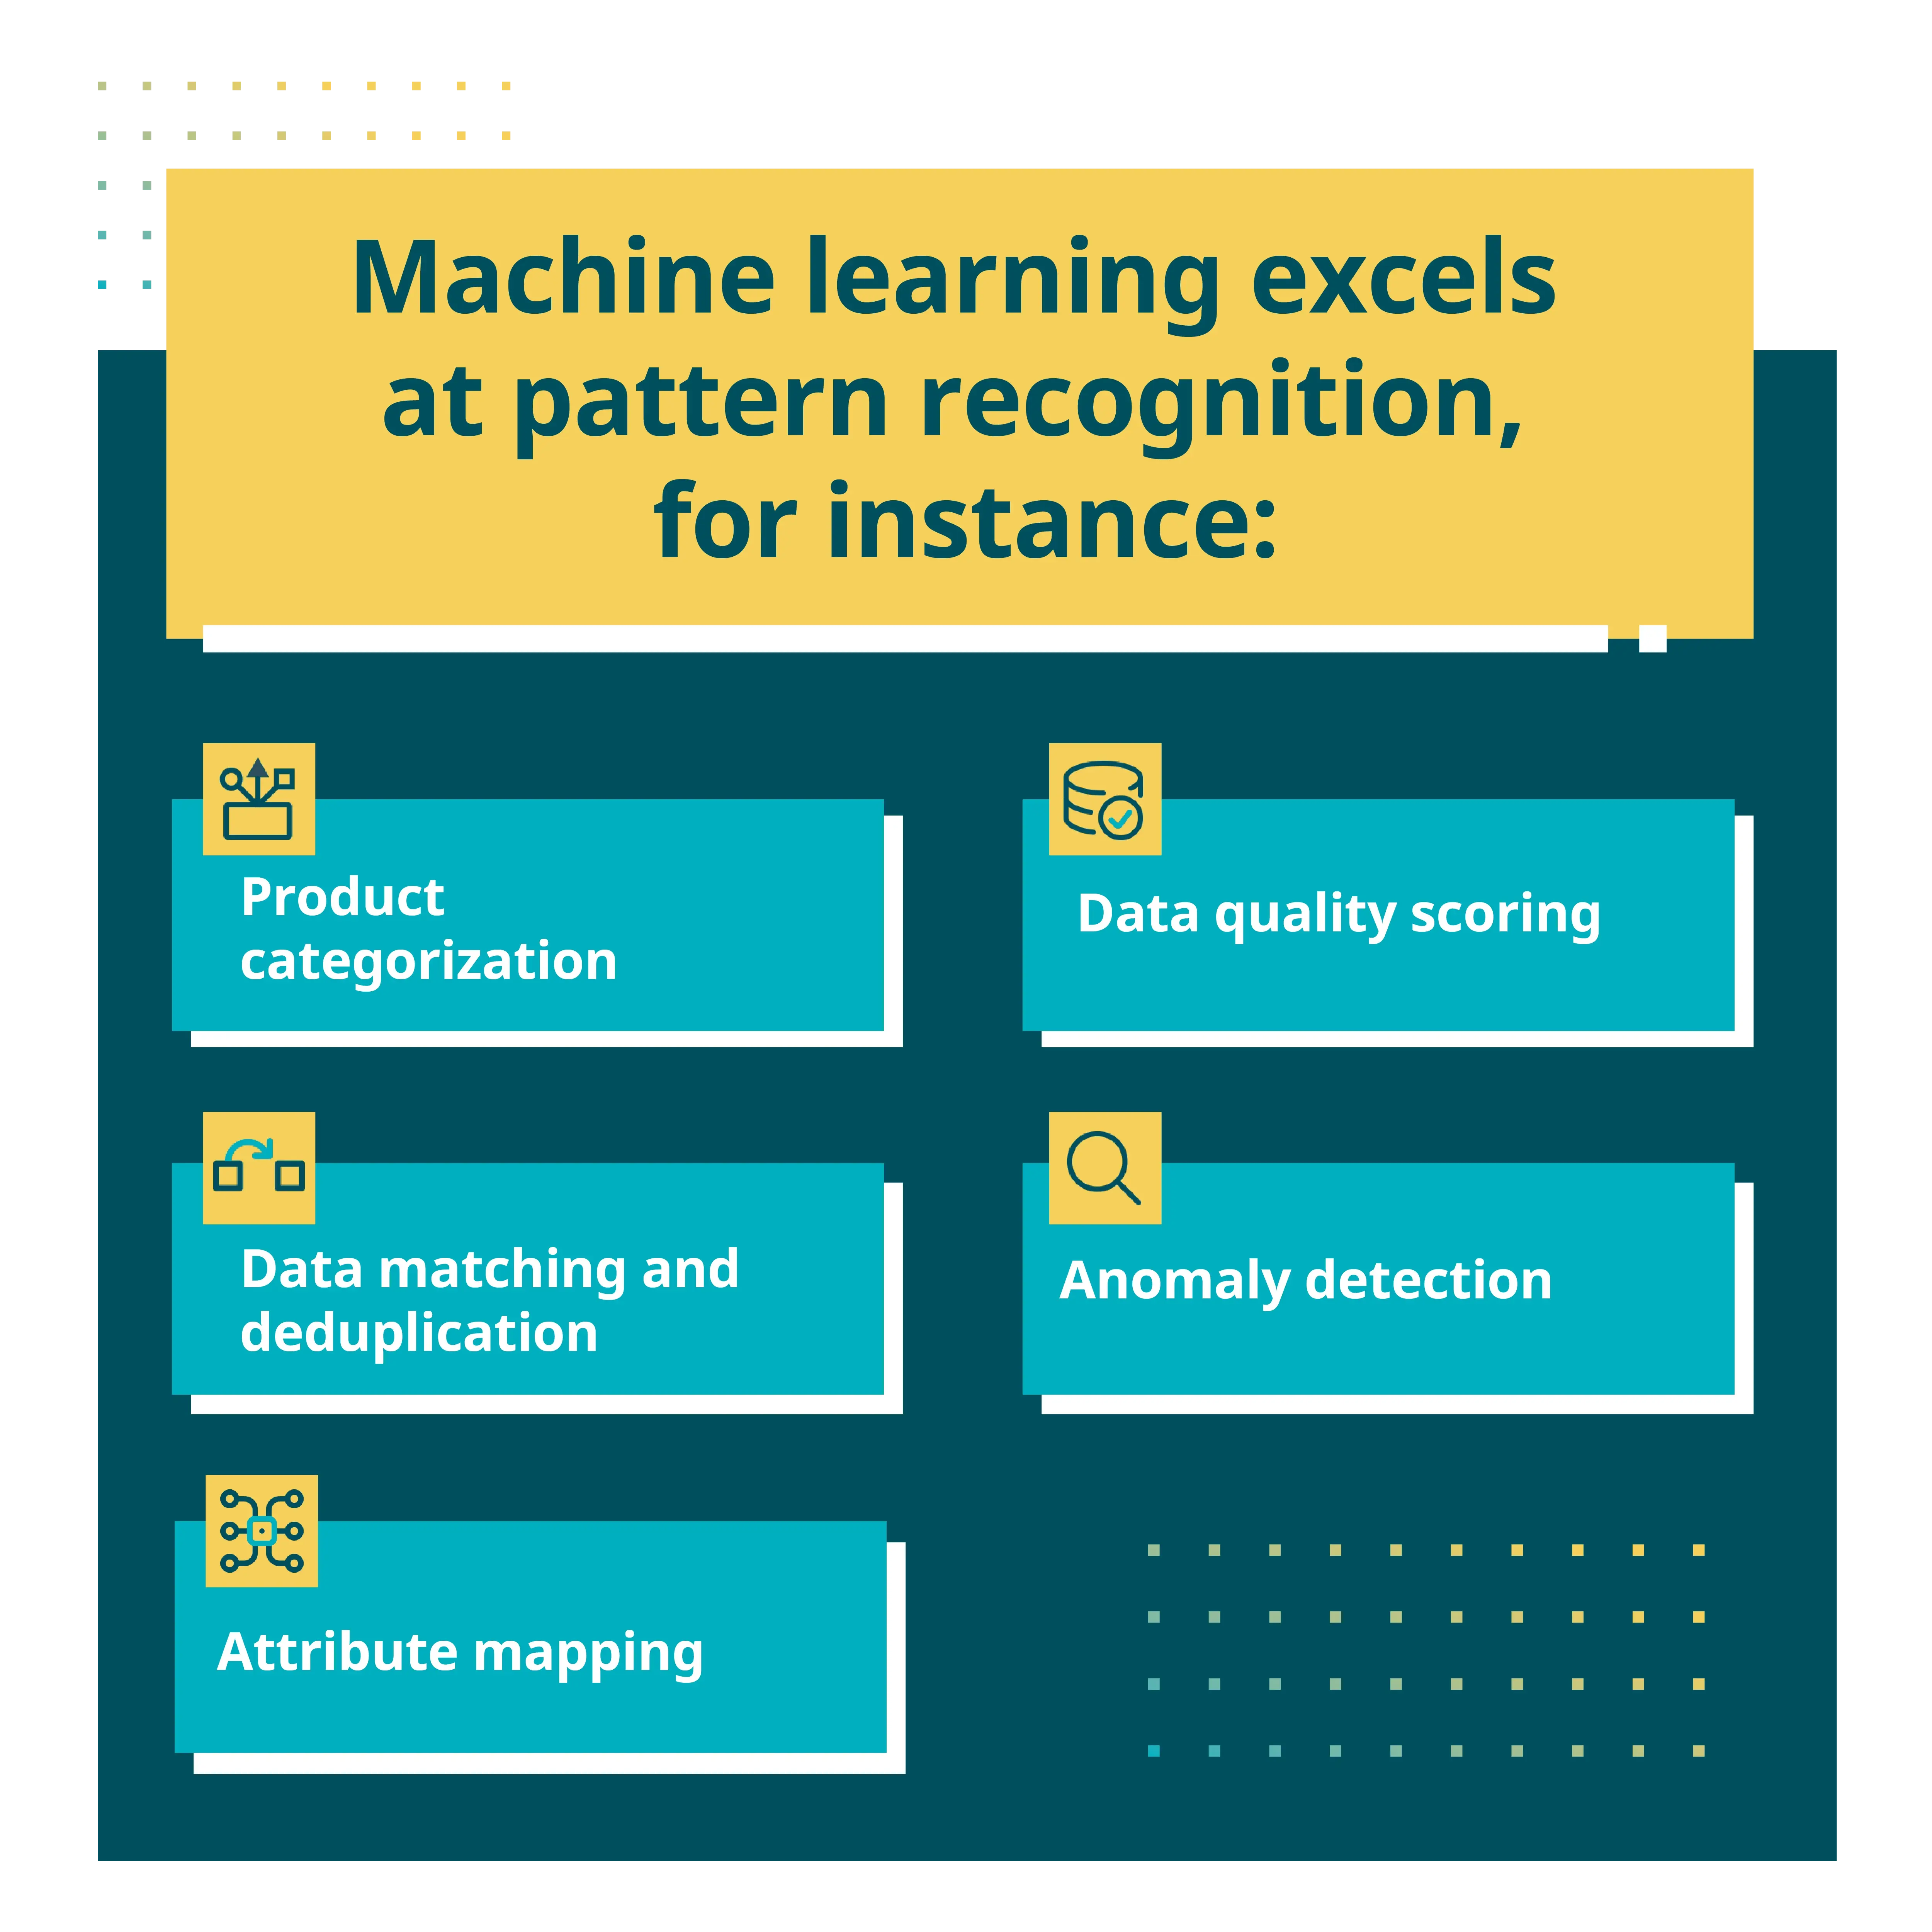
Fondamentalmente, il ML eccelle nel riconoscimento di schemi, nella categorizzazione e nella previsione – esattamente ciò di cui si ha bisogno quando si gestiscono grandi volumi di dati complessi. Prendiamo ad esempio questi casi:
-
Categorizzazione dei prodotti
Assegnazione automatica dei nuovi prodotti alle categorie corrette nella propria tassonomia. -
Corrispondenza e deduplicazione dei dati
Identificazione dei casi in cui record diversi rappresentano la stessa entità del mondo reale. -
Mappatura degli attributi
Collegamento degli attributi specifici del fornitore al proprio modello di dati standardizzato. -
Valutazione della qualità dei dati
Previsione dei livelli di completezza e accuratezza senza revisione manuale. -
Rilevamento delle anomalie
Segnalazione di modelli di dati insoliti che potrebbero indicare errori o opportunità.
I guadagni in termini di efficienza possono essere notevoli. Attività che un tempo richiedevano giorni possono ora essere completate in pochi minuti. E non si tratta solo di velocità:
il ML garantisce coerenza
La classificazione umana varia naturalmente da persona a persona e persino da parte della stessa persona in momenti diversi. Il ML applica la stessa logica in modo coerente (statisticamente). Si limita così la variabilità che causa problemi con i dati a valle.
Il ML si adatta all’evoluzione della vostra attività
Con i sistemi tradizionali basati su regole, è necessaria una riprogrammazione esplicita quando cambiano le condizioni aziendali. I modelli di ML, invece, sono in grado di individuare i cambiamenti nei modelli dei dati e di adattarsi di conseguenza. Questa adattabilità fa sì che i processi di gestione dei dati rimangano aggiornati con un intervento minimo.
Ma questi vantaggi comportano un importante avvertimento: l’affidabilità delle previsioni dipende dall’accuratezza del modello. Ed è proprio qui che molti team di gestione dei dati incontrano un ostacolo nel loro percorso verso l’automazione.
Se non ci si può fidare del proprio ML, tutto va a rotoli
Le previsioni del ML comportano un’incertezza intrinseca. Sebbene i modelli di ML siano efficaci nel riconoscere i modelli, non offrono la certezza di una dimostrazione matematica. Ciò crea una sfida di fiducia che può limitare significativamente il potenziale di automazione.
Il dilemma dell’accuratezza
Ogni modello di ML produce un certo livello di imprecisione, che in genere si manifesta in due forme:
- Falsi negativi, in cui non vengono riconosciute corrispondenze valide
- Falsi positivi, in cui vengono effettuate corrispondenze errate
Per la gestione dei dati, i falsi positivi rappresentano il problema maggiore. Quando un modello classifica erroneamente un prodotto o abbina in modo errato due clienti diversi, questi errori si propagano attraverso i sistemi, causando problemi di qualità dei dati che possono influire sulle operazioni aziendali.
L’automazione parziale non è sufficiente
Molte organizzazioni affrontano questa sfida con un approccio ibrido: utilizzano il ML per l’elaborazione iniziale, per poi rivedere manualmente i risultati. Sebbene sia comunque preferibile rispetto ai processi interamente manuali, questo approccio:
- Crea colli di bottiglia nella revisione durante i periodi di elevato volume
- Richiede comunque notevoli risorse umane
- Limita i vantaggi in termini di scalabilità che ci si aspetta dal ML
- Rallenta i processi in cui il tempo è un fattore critico
Il divario di verifica
Il problema principale non è che il ML commetta errori, ma la mancanza di un meccanismo affidabile per verificare quali previsioni siano attendibili.
Senza sapere quali previsioni siano certamente corrette, si è costretti a verificare tutto o ad accettare un certo livello di errore nei dati di riferimento.
Questo divario di verifica rappresenta la barriera critica tra l’elaborazione assistita e la vera automazione. E per colmare il divario, è necessario un approccio fondamentalmente diverso che combini le capacità di riconoscimento dei modelli del ML con metodi in grado di fornire certezza matematica sull’accuratezza delle previsioni.
Dopotutto: non è necessario sapere che il proprio modello ha un’accuratezza complessiva del 95%. È necessario sapere a quale 95% delle previsioni ci si può fidare.
Si tratta infatti di un problema difficile da affrontare, la cui natura varia a seconda dei casi d’uso. Ma noi di Stibo Systems siamo instancabili nel risolvere tali sfide e, per affrontare questa in particolare, stiamo iniziando con la verifica delle raccomandazioni di classificazione fornite dall’assistenza AI – nota in ambito di ricerca anche come mappatura ontologica (di classificazione).
Come integrare meccanismi di verifica matematica nel proprio modello di ML
La nostra ricerca condotta in collaborazione con l’Università Tecnica della Danimarca (DTU) – una delle principali università tecniche d’Europa, nominata anche migliore università tecnica della Danimarca – ha portato a un approccio rivoluzionario.
Esso combina la velocità del ML con la certezza della verifica matematica.
Le sfide di verifica che stiamo risolvendo
Quando si utilizza l’IA per mappare tra sistemi di classificazione – ad esempio, abbinando “Utensili manuali” in una tassonomia di prodotto a “Utensili portatili” in un’altra – i modelli di ML possono fornire previsioni impressionanti.
Ma tali previsioni comportano sempre un’incertezza statistica che può minare la fiducia. E la fiducia, in questo contesto, è di natura binaria: o ci si può fidare dei risultati, oppure no (e bisogna ricontrollare).
La questione fondamentale è la coerenza. Come è possibile verificare che le relazioni di mappatura abbiano un senso logico nell’ambito di intere strutture di classificazione?
La certezza matematica incontra l’applicazione pratica
Nella nostra soluzione, applichiamo metodi matematici formali per verificare che le mappature consigliate siano logicamente coerenti. La dimostrazione matematica conferma quali previsioni siano corrette, non solo statisticamente probabili.
A tal fine, utilizziamo in particolare la logica proposizionale e le “clausole di Horn”.
Cosa sono le clausole di Horn?
Possono sembrare complesse, ma sono semplicemente affermazioni logiche che seguono uno schema “se-allora”. Ad esempio: “se un prodotto è un martello E i martelli appartengono agli utensili manuali, ALLORA il prodotto appartiene agli utensili manuali”. Applicando queste regole logiche a tutti i sistemi di classificazione, possiamo verificare matematicamente se le mappature hanno senso.
Ma potresti chiederti: se i metodi formali forniscono la certezza di cui abbiamo bisogno, perché utilizzare affatto il ML?
La risposta sta nell’efficienza computazionale. Applicare i soli metodi formali a grandi strutture di classificazione sarebbe troppo oneroso dal punto di vista computazionale per un uso pratico.
Combinando i due approcci, otteniamo il meglio di entrambi i mondi:
- le previsioni veloci del ML restringono il campo delle possibili mappature.
- La verifica matematica conferma quali previsioni sono definitivamente corrette.
- Solo le previsioni incerte richiedono una revisione umana.
L’approccio ibrido riduce drasticamente il carico di lavoro di verifica mantenendo l’accuratezza, rendendo possibile una vera automazione.
Approfondisci questi concetti: questo lavoro è stato pubblicato in “The Practice of Formal Methods”, un saggio in onore di Cliff Jones.
Noi di Stibo Systems lo stiamo applicando nella pratica
I fondamenti matematici sono solidi come una roccia: la logica formale è corretta o errata, senza vie di mezzo. La parte entusiasmante consiste nell’applicare questi principi alle sfide del mondo reale nell’ambito dell’MDM.
La nostra implementazione si concentra attualmente su scenari ad alto volume in cui la verifica crea notevoli colli di bottiglia.
Ad esempio, per i rivenditori che inseriscono regolarmente migliaia di articoli dei fornitori, la capacità di convalidare automaticamente le categorizzazioni suggerite dall’IA crea un valore enorme durante l’intero processo.
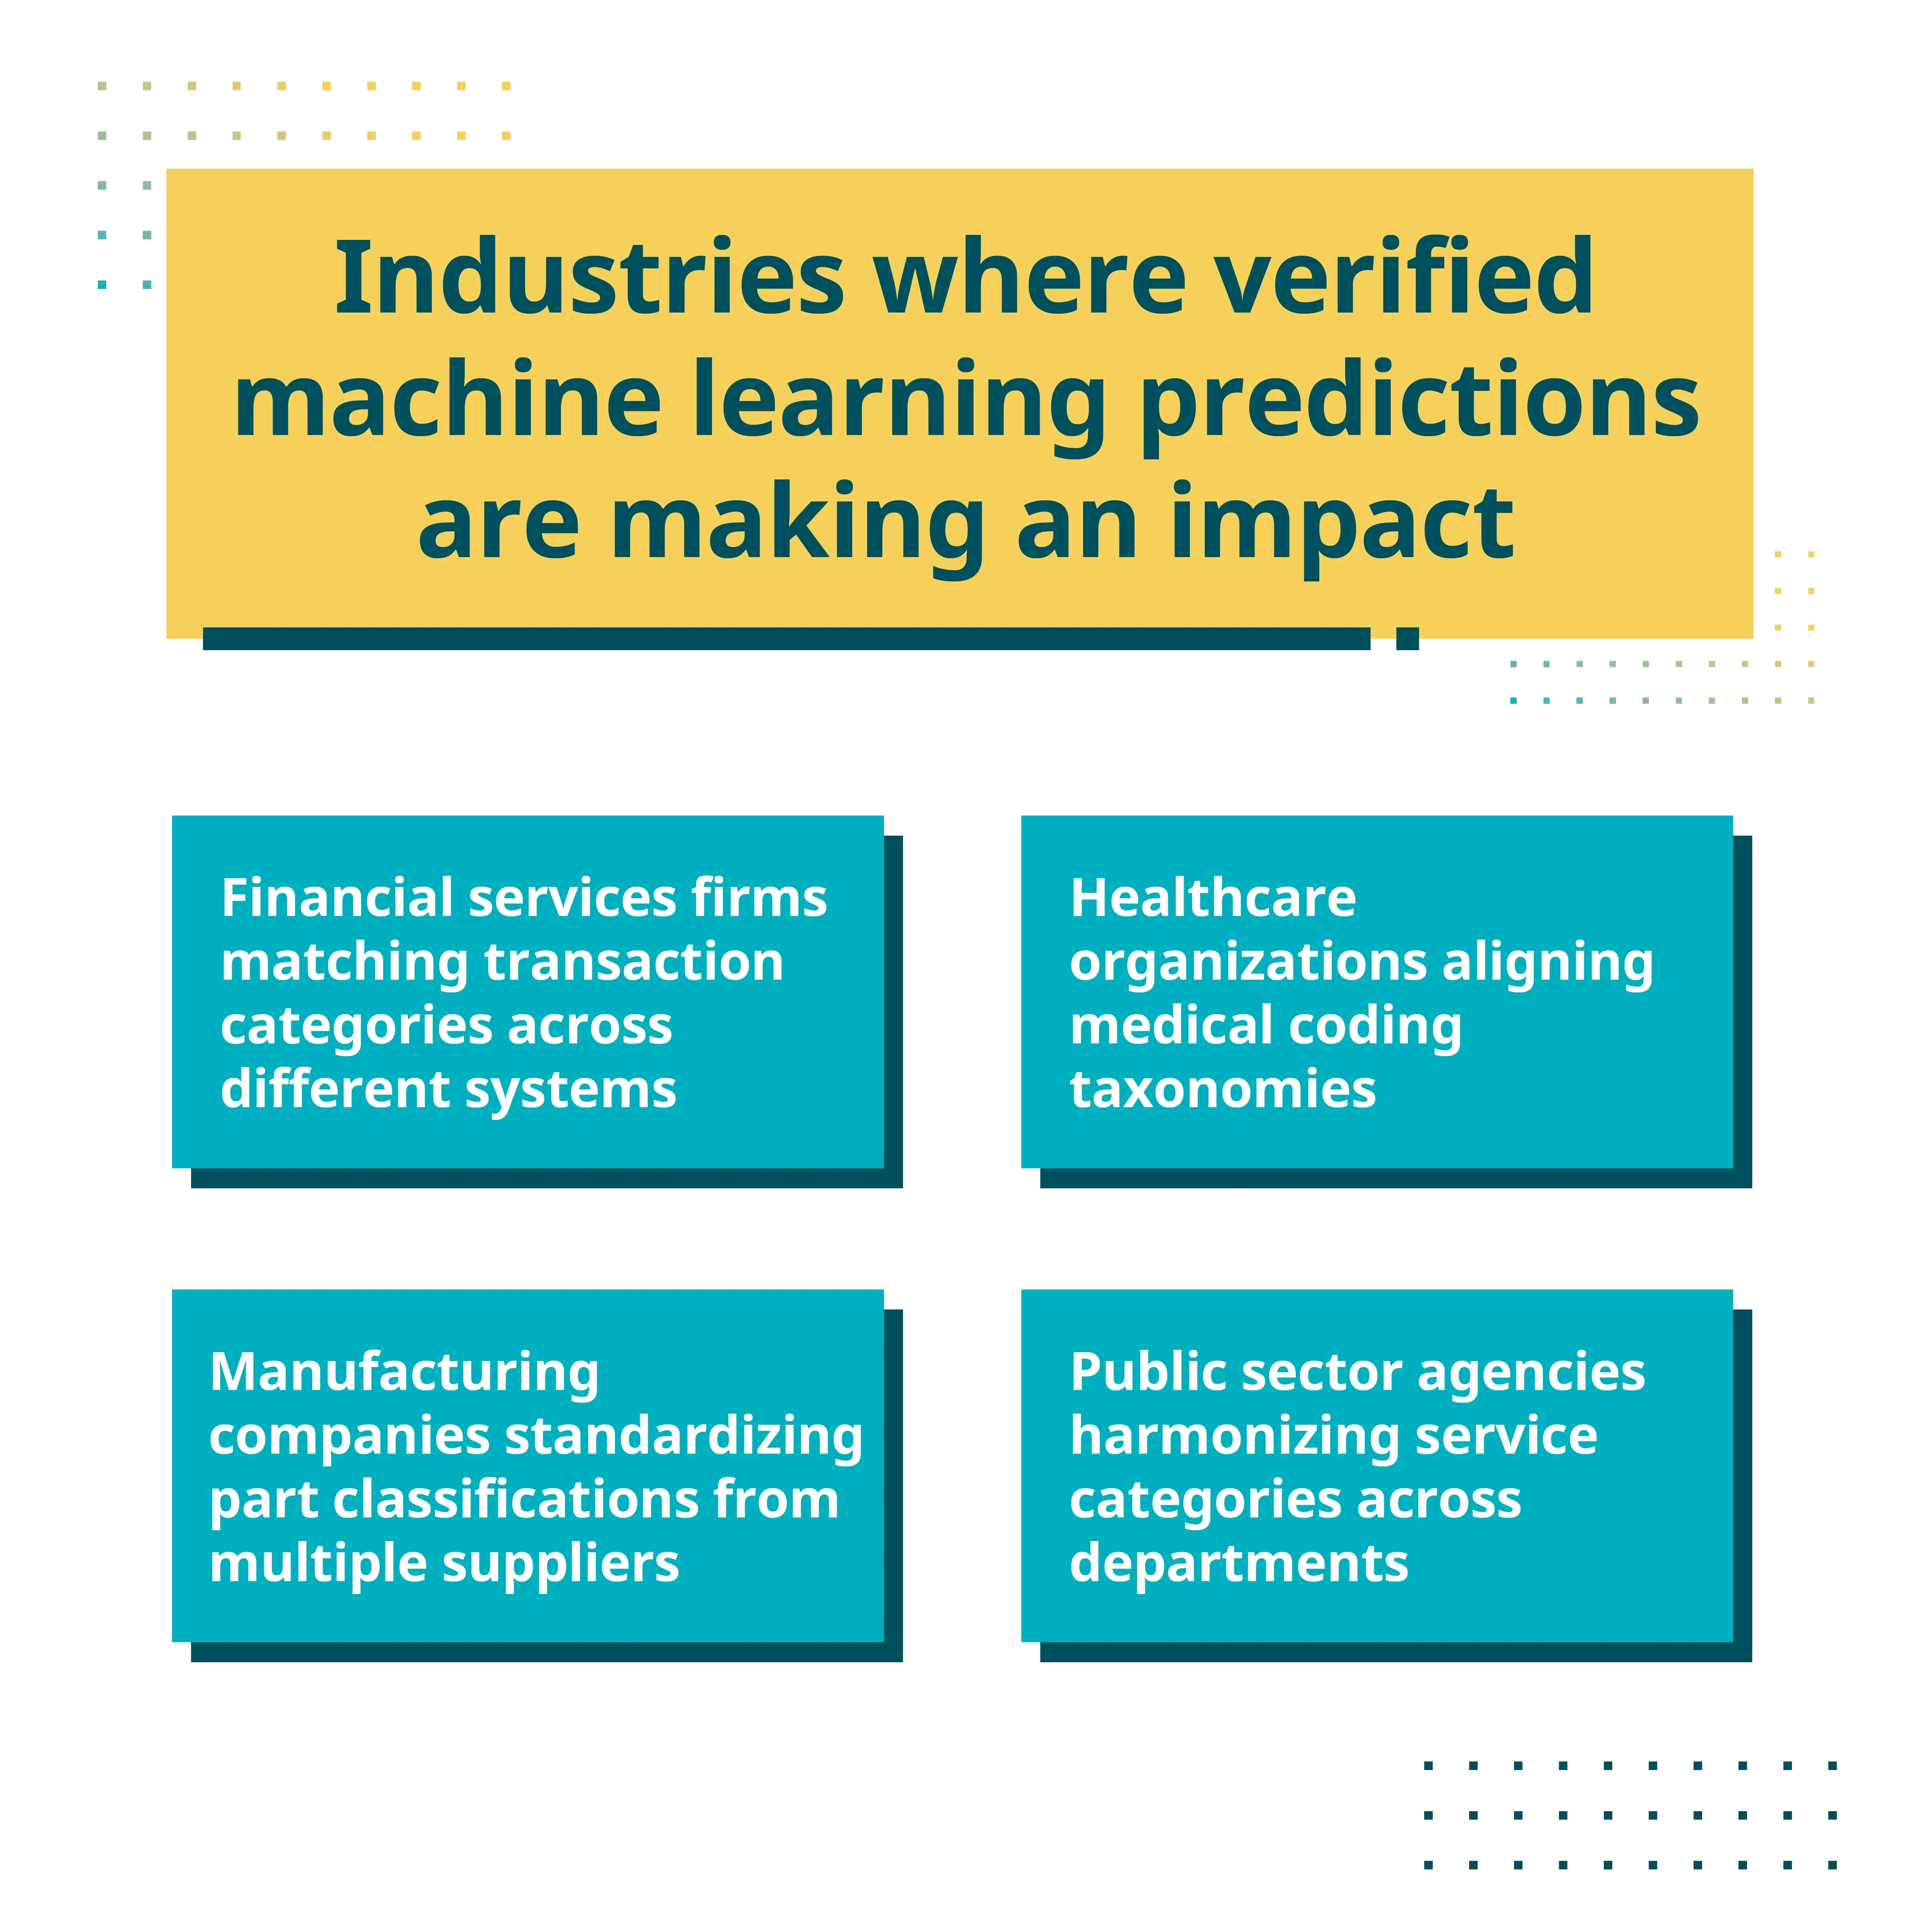
Ma collaboriamo con aziende in molti settori, con potenziali casi d’uso ovunque:
- Società di servizi finanziari che allineano le categorie delle transazioni tra sistemi diversi
- Organizzazioni sanitarie che allineano le tassonomie di codifica medica
- Aziende manifatturiere che standardizzano le classificazioni dei componenti provenienti da più fornitori
- Enti del settore pubblico che armonizzano le categorie di servizi tra i vari dipartimenti
Qualsiasi situazione che comporti l’allineamento delle tassonomie, la corrispondenza delle classificazioni o la standardizzazione tra sistemi potrebbe trarre vantaggio da previsioni verificate.
Stato attuale della nostra implementazione
Attualmente stiamo testando dei prototipi in contesti reali.
Sebbene l’implementazione sia ancora nelle fasi iniziali, la verifica matematica funziona esattamente come previsto: identifica correttamente quali previsioni sono affidabili. La fase successiva prevede il perfezionamento dell’esperienza utente e l’estensione delle capacità di verifica a ulteriori scenari di gestione dei dati.
Riassumiamo
La fiducia rimane il principale ostacolo alla vera automazione nella gestione dei dati. La nostra combinazione di ML e verifica matematica ci offre un percorso pratico che non costringe a scegliere tra velocità e accuratezza.
Il ruolo umano sarà sempre fondamentale nella gestione dei dati, ma ora possiamo indirizzare tale competenza dove apporta il massimo valore aggiunto – non verso attività di routine che l’IA verificata è in grado di gestire in modo affidabile.
Quando potrete fidarvi delle previsioni del ML, potrete finalmente automatizzare con sicurezza.
Gestione dei Dati Master Potenziata dall'IA
Sblocca il potere dell'IA nei tuoi processi MDM per navigare le dinamiche complesse della catena di approvvigionamento con maggiore agilità e lungimiranza.