Les initiatives d'IA échouent lorsque les données sur lesquelles raisonnent les agents sont incomplètes, incohérentes ou non gouvernées.
Une donnée maître fiable est le socle qui empêche l'IA de dérailler. Ce sont les fiches produit, client, fournisseur et site gouvernées et précises dont chaque agent IA a besoin pour prendre des décisions fiables.
La plupart des entreprises qui se lancent dans le déploiement de l'IA commettent la même erreur : elles préparent longuement le modèle – choix du fournisseur, intégration, réglage des prompts – mais négligent leurs données maîtresses comme source unique de vérité contextuelle.
Résultat : des agents IA qui agissent avec assurance sur la base de ce qu'on leur donne, à grande échelle.
Le temps qu'une décision erronée soit détectée, elle a généralement déjà causé des dégâts. Une commande perturbée, une déclaration de conformité compromise.
Préparer l'IA, c'est comme préparer une course.
Vous pouvez avoir le meilleur entraîneur, le meilleur équipement – même la stratégie parfaite pour le jour J – mais leur efficacité dépend de votre condition physique sous-jacente. En IA, la donnée maître fiable, c'est cette condition physique. Elle donne à votre organisation la force et l'endurance nécessaires pour performer quand cela compte vraiment.
La plupart des entreprises se concentrent sur le jour de la course : les modèles d'IA, les agents, les applications. Elles négligent le « travail de préparation physique » qui détermine si elles seront réellement performantes. Cet article fait partie d'une série consacrée à ce travail de préparation, pour vous préparer à la course de notre époque.
Pourquoi la plupart des initiatives d'IA échouent-elles avant même que le modèle ne tourne ?
La préparation à l'IA est traitée comme une décision technologique.
Les entreprises évaluent les modèles, comparent les fournisseurs et mesurent les performances par cas d'usage. La préparation des données entre rarement dans cette conversation. Elle relève d'une autre équipe, sur un autre calendrier, souvent traitée comme un projet de nettoyage une fois que tout est déjà en mouvement.
Les entreprises ne voient souvent les problèmes qu'après le lancement :
- Des fiches produit qui se contredisent d'un système à l'autre
- Des données client dupliquées sous des noms légèrement différents
- Des informations fournisseur non validées depuis plus d'un an
- Aucune source unique de vérité pour les entités que l'IA est censée analyser
Rien de tout cela n'apparaît lors d'une démonstration. Les projets pilotes tournent sur des données sélectionnées et épurées, donc le modèle donne de bons résultats en salle.
Les failles apparaissent lorsque l'agent IA se confronte à la réalité complète et chaotique des systèmes d'entreprise. Et à ce moment-là, les utilisateurs métier se sont déjà mis à faire confiance à ses résultats, et la confiance est bien plus difficile à reconstruire qu'à établir.
C'est ce travail de préparation que les entreprises négligent. Non pas parce qu'il n'a pas d'importance, mais parce que personne ne vérifie la condition physique de base avant le jour de la course.
Que se passe-t-il quand les agents IA utilisent de mauvaises données maîtresses ?
Une donnée maître de mauvaise qualité se manifeste différemment selon l'endroit où le modèle IA échoue. Mais il existe un schéma cohérent. Un agent IA agit sur les données qu'on lui fournit, et lorsque ces données sont incomplètes, incohérentes ou obsolètes, le résultat le reflète.
On distingue quatre schémas de défaillance.
1. Hallucination
L'agent IA comble les vides avec des hypothèses plausibles. Un attribut produit manquant ou un profil client incomplet est remplacé par une supposition vraisemblable, présentée avec la même assurance qu'un fait vérifié.
2. Décisions incohérentes
La même entité existe différemment selon les systèmes – un client avec trois adresses légèrement différentes, ou un produit avec deux spécifications différentes.
L'agent IA s'appuie sur des versions contradictoires de la même donnée, ce qui entraîne des réponses incohérentes à une même question selon les systèmes interrogés.
3. Violations de conformité
Sans gouvernance et contexte réglementaire fiables, l'IA peut recommander ou exécuter des actions qui enfreignent des exigences de conformité : une transaction approuvée pour un client qui aurait dû être signalé, ou un produit référencé sur un marché où il n'est pas autorisé.
4. Des fiches contradictoires déclenchant la mauvaise action
Deux systèmes ne sont pas d'accord sur, par exemple, le stock, le prix ou la disponibilité, et l'agent IA se range du côté de l'un des deux. La commande est expédiée sur la base d'un mauvais niveau de stock. Ou une remise s'applique à la mauvaise catégorie de client.
Voilà à quoi ressemble une préparation insuffisante lorsque l'IA passe de la génération de contenu à la prise de décision. Ce n'est pas une erreur spectaculaire isolée, mais une accumulation d'incohérences discrètes qui érodent la confiance dans chaque résultat suivant.
Pourquoi les données qui ont passé votre dernier audit échouent-elles avec vos agents IA ?
Le reporting et les agents IA n'imposent pas les mêmes exigences aux données. C'est pourquoi une donnée qui réussit tous les contrôles de reporting peut néanmoins échouer dès la première utilisation par un agent IA.
Plusieurs raisons expliquent cela :
Le reporting tolère une certaine approximation. Les agents IA, non.
Un tableau de bord arrondit un chiffre ou affiche un total légèrement daté, et un lecteur humain compense ce décalage. Un agent IA traite ce même chiffre comme une vérité absolue et agit directement dessus.
Le reporting fonctionne par lots. Les agents IA fonctionnent en temps réel.
La plupart des données de reporting sont actualisées la nuit ou chaque semaine, ce qui convient pour une revue trimestrielle. Un agent IA qui prend une décision maintenant a besoin de l'état actuel, pas de la photographie de la semaine dernière.
Les rapports tolèrent des vues fragmentées par domaine. Les agents IA raisonnent à travers eux.
Un tableau de bord de reporting peut analyser séparément les données produit, client et fournisseur. Un agent IA qui traite une demande unique, comme confirmer si une commande peut être expédiée, a souvent besoin que les trois domaines concordent.
Le reporting absorbe les erreurs à faible volume. Pas les agents IA.
Un analyste humain repère une anomalie évidente avant qu'elle n'atteigne une présentation au conseil d'administration. Un agent IA qui prend des milliers de décisions autonomes par jour n'a pas d'équivalent de ce contrôle, si bien que le même taux d'erreur produit un nombre bien plus élevé de résultats erronés.
C'est toute la différence entre s'entraîner pour un jogging occasionnel et se préparer pour le jour de la course. Rendre vos données suffisamment propres pour réussir un audit de reporting vous a mis en forme pour le jogging.
Cependant, les agents IA, c'est le jour de la course, tous les jours, et la plupart des entreprises se présentent avec le mauvais plan d'entraînement.
De quoi vos données maîtresses ont-elles besoin avant de déployer l'IA ?
Trois capacités fondamentales sont essentielles : la traçabilité, la cohérence et la responsabilité.
La traçabilité signifie que chaque fiche porte un historique traçable – d'où elle vient, quand elle a été modifiée pour la dernière fois, qui ou quoi l'a modifiée.
Sans traçabilité, ni l'entreprise ni la plateforme d'IA ne peuvent expliquer d'où vient une information, comment elle a évolué, ou si elle est fiable.
La cohérence est la plus difficile à atteindre. Un « client » dans le CRM doit être la même entité qu'un « client » dans le système de commande – même définition, même identifiant, sans quasi-correspondances que l'agent IA devrait deviner.
Cela s'applique à tous les domaines de données gérés par l'entreprise :
- Produit
- Client
- Fournisseur
- Site
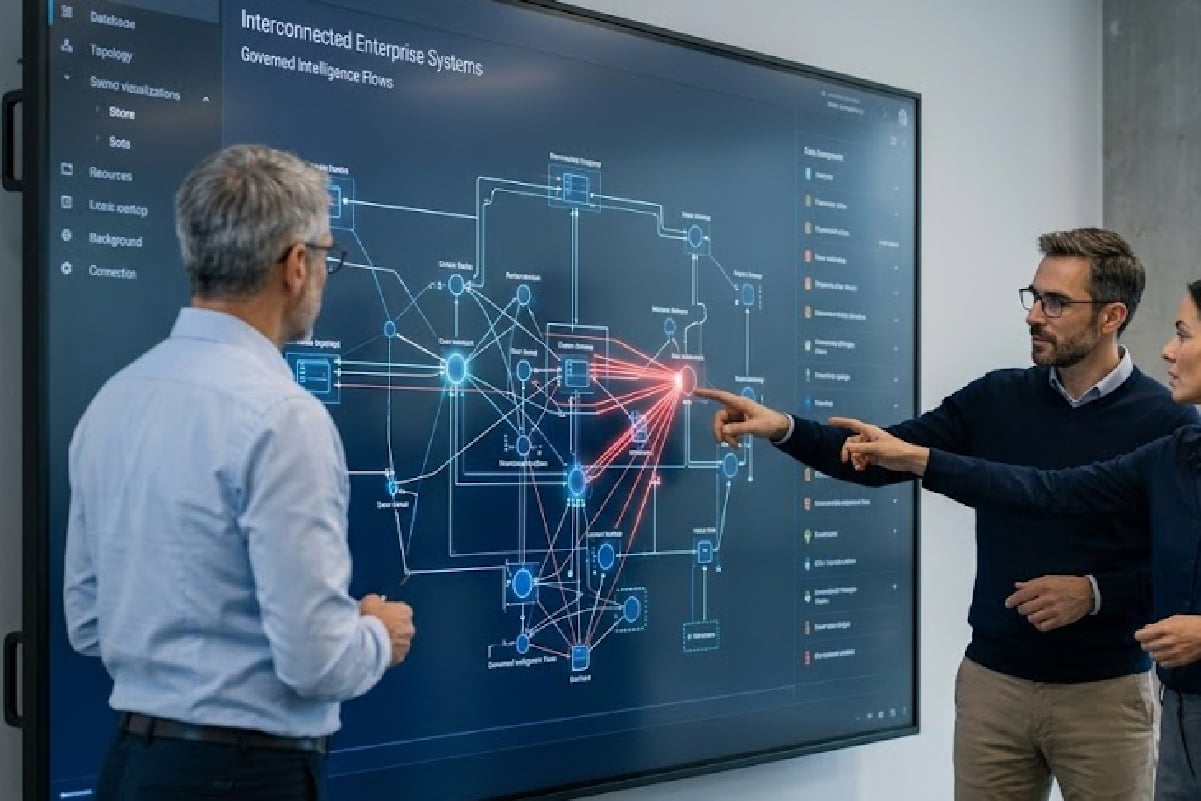
Une faiblesse dans un domaine se propage rapidement aux autres, car l'IA raisonne à travers des entités métier interconnectées.
La responsabilité signifie que chaque entité métier critique dispose d'un système de référence gouverné et d'une responsabilité claire quant à sa qualité.
Sans responsabilité claire, les données contradictoires restent non résolues, augmentant le risque que l'IA agisse sur des informations incomplètes ou incorrectes.
Si des données de qualité reporting représentaient le jogging occasionnel, voici à quoi ressemble un véritable plan d'entraînement une fois formalisé. Rien de glamour. Juste le travail de préparation précis et peu spectaculaire qui détermine si le jour de la course se déroulera bien.
Rien de tout cela n'est nouveau.
Les équipes data solides visent cet objectif depuis des années. Ce qui a changé, c'est la conséquence de le négliger. Un écart qui apparaissait autrefois comme un tableur mal tenu se traduit désormais par une décision erronée, prise automatiquement, à grande échelle.
Pour conclure
Rien de tout cela n'est un territoire inconnu pour les équipes data solides. Ce qui change, c'est l'enjeu quand on le néglige.
Les problèmes de cohérence se traduisaient autrefois par des tableurs mal tenus. Ils entraînent désormais des décisions erronées, prises automatiquement, à grande échelle.
Et il n'y a plus d'humain dans la boucle pour l'intercepter en premier.
Dans cette course que vous préparez, avoir une donnée maître fiable est la préparation qui détermine votre niveau de performance. Plus vous y investissez tôt, plus chaque initiative d'IA qui en découle en sort renforcée.
Foire aux questions
Qui est responsable de la donnée maître dans une entreprise pilotée par l'IA ?
Cela varie selon les organisations, mais le rôle de propriétaire de la donnée devient encore plus important dans un contexte d'IA que pour le reporting. Les propriétaires courants incluent :
- Un Chief Data Officer supervisant la stratégie data
- Des responsables spécifiques à chaque domaine (par exemple, un propriétaire des données produit, un propriétaire des données client)
- Des équipes IT ou d'ingénierie des données responsables des systèmes sous-jacents
Ce qui change avec l'IA, c'est le coût de l'ambiguïté. Lorsque personne ne détient un domaine de données, personne n'est responsable de l'information que l'IA utilise pour décider – ni des conséquences qui en découlent.
Quel est le rôle de la gestion des données maîtresses dans la fiabilité de l'IA en entreprise ?
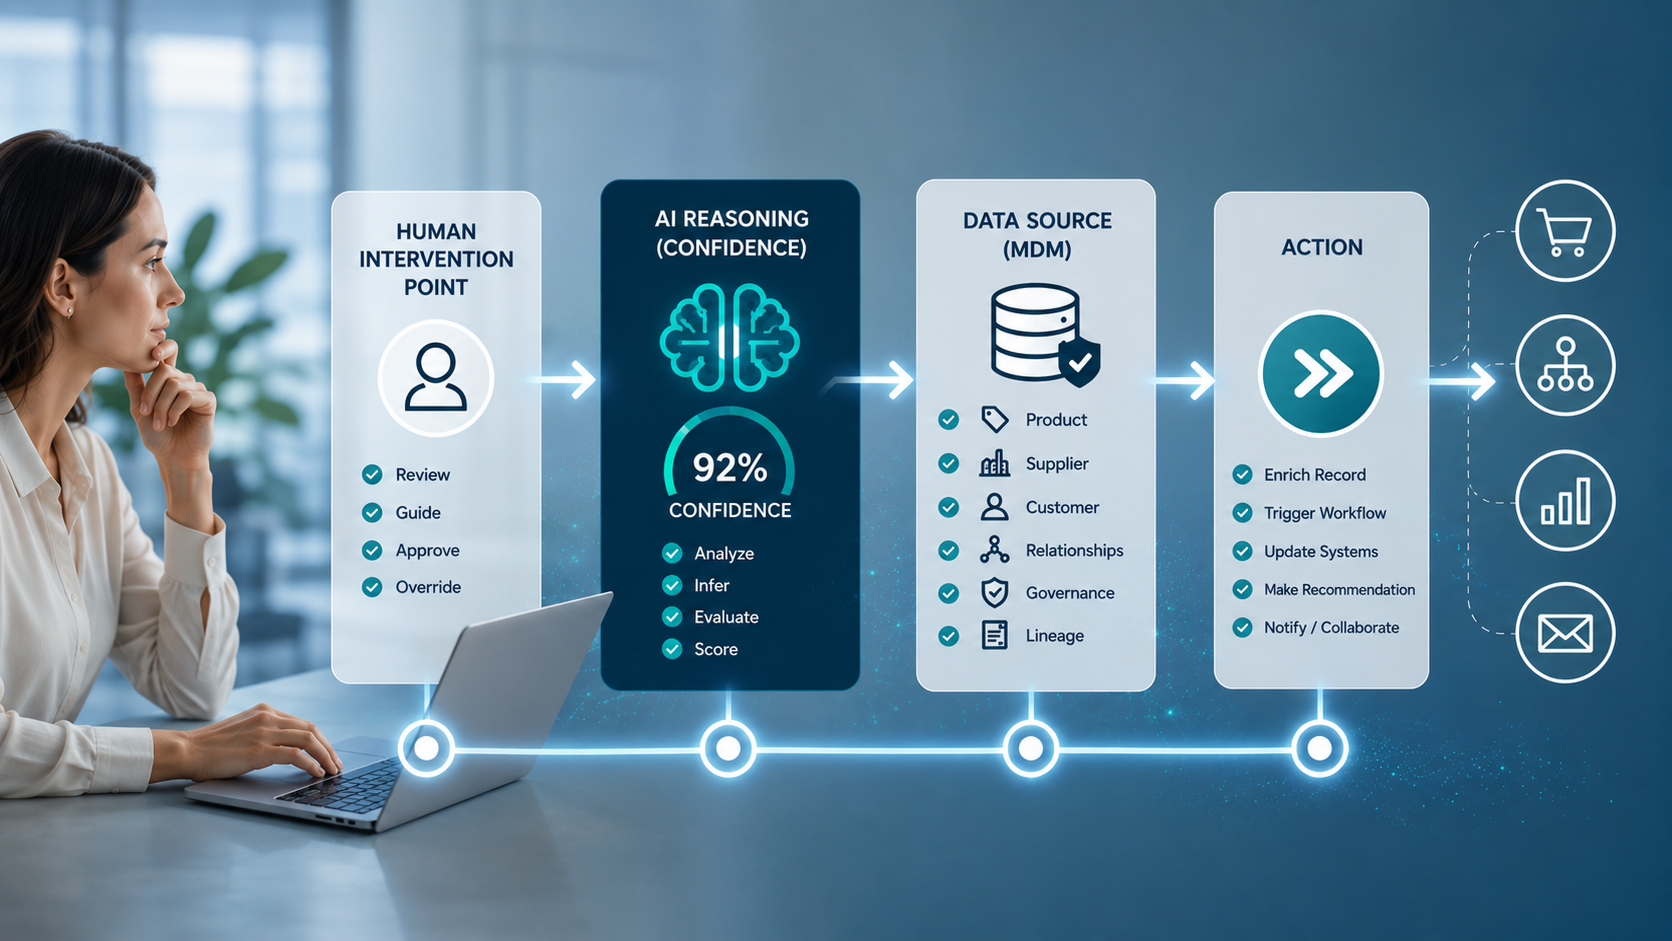
La gestion des données maîtresses (MDM) permet de garantir que les entités métier essentielles dont dépend l'IA – produits, clients, fournisseurs et sites – sont gouvernées, cohérentes et fiables.
Sans fondation MDM, les agents IA fonctionnent sur des données métier incomplètes, incohérentes ou mal gouvernées, produisant des recommandations et des décisions peu fiables. Le MDM n'est pas un simple confort pour les déploiements d'IA. C'est une couche fondamentale pour déployer une IA fiable à l'échelle de l'entreprise.
Comment savoir si les données de votre entreprise sont prêtes pour l'IA ?
Posez-vous quelques questions simples :
- Pouvez-vous retracer d'où provient chaque fiche métier essentielle, qui en est propriétaire et quand elle a été mise à jour pour la dernière fois ?
- Le même client, produit, fournisseur ou site a-t-il une identité cohérente à travers tous les systèmes ?
- L'IA peut-elle accéder à un contexte métier fiable et connecté à travers les domaines – et pas seulement à des fiches isolées ?
- Les problèmes de qualité des données sont-ils évités dès leur entrée dans vos systèmes, plutôt que corrigés plus tard ?
- Pouvez-vous expliquer pourquoi un agent IA a pris une décision particulière en la retraçant jusqu'à la donnée métier sous-jacente ?
Si la réponse à l'une de ces questions est non (ou même « je ne suis pas sûr »), votre socle de données n'est probablement pas prêt à soutenir une IA fiable à grande échelle.
Que signifie avoir une source unique de vérité pour l'IA ?
Une source unique de vérité signifie disposer d'une vue gouvernée et faisant autorité pour chaque entité métier essentielle – un produit, un client, un fournisseur ou un site – à laquelle chaque système et application d'IA peut se fier.
Sans elle, différentes applications ou agents IA peuvent agir sur des versions différentes de la même entité métier, entraînant des décisions incohérentes et des résultats imprévisibles. Pour le reporting, ces incohérences restent souvent gérables. Pour l'IA autonome opérant à grande échelle, elles deviennent un enjeu de fiabilité.
De quelles données un agent IA a-t-il besoin pour prendre des décisions autonomes fiables ?
Quatre capacités fondamentales sont requises :
- Des fiches fiables, sans versions contradictoires de la même entité métier.
- Des données métier actuelles reflétant l'état le plus récent de l'entreprise.
- Un contexte métier connecté, afin que les produits, clients, fournisseurs, sites et autres domaines essentiels fonctionnent ensemble comme une vue unique.
- Une traçabilité et une gouvernance vérifiables, afin que chaque fiche puisse être validée, et que chaque décision pilotée par l'IA puisse être expliquée et auditée.