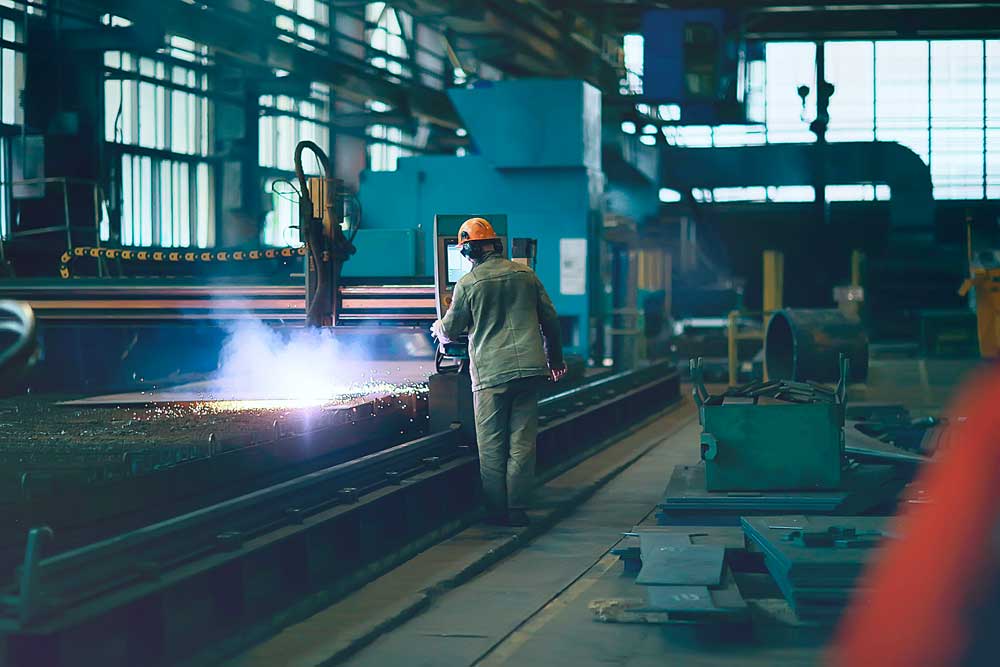

J'en ai fait moi-même l'expérience en tant que propriétaire et dirigeant d'entreprises de fabrication métallique. Une alerte arrive de l'équipe commerciale : notre planificateur de production anticipe une date d'expédition bien au-delà du délai promis. Ou quelqu'un signale une rupture de stock sur un article critique.
C'est déroutant – j'ai littéralement croisé le matériel en question. J'avais clairement rappelé l'importance de respecter les délais. Comment les achats ou les opérations ont-ils pu laisser passer ça ?
J'enquête, et je découvre que la marchandise est bloquée sur le quai, dans l'attente d'être « réceptionnée »
Pourquoi ?!
L'arme du crime, c'est une fiche technique PDF de 38 pages envoyée par un fournisseur, dont la moitié ressemble à un fax expédié en 2011.
Le magasinier lève les yeux au ciel et l'ajoute à la pile de la semaine prochaine, pour saisie manuelle. Le temps que ces données soient intégrées, l'équipe de production réclame cette pièce depuis trois semaines.
La fenêtre est ratée.
Bienvenue dans le grand goulot d'étranglement de l'onboarding fournisseur
Vous retrouverez des scénarios comme celui-ci dans la plupart des entreprises. Le processus d'onboarding fournisseur ne dysfonctionne pas, mais il est lent, coûteux et grignote discrètement la marge de chaque produit qui en dépend en aval.
Et une seule pièce bloquée déclenche un effet domino ressenti par tous les services jusqu'à votre client.
L'IA agentique ne résoudra pas tout – mais elle élimine les principales taxes que vous payez chaque jour
L'IA agentique appliquée à l'onboarding sera présentée comme une planche de salut. Mais soyons transparents : elle n'est pas une baguette magique à elle seule.
Elle s'attaque en revanche directement à ce que j'appelle les taxes silencieuses de l'onboarding fournisseur.
Les taxes silencieuses de l'onboarding fournisseur, ce sont les coûts opérationnels qui n'apparaissent jamais dans un compte de résultat, mais qui rongent la marge chaque jour. C'est littéralement ce que vous brûlez quand il faut éteindre des incendies au quotidien dans un environnement de production. Les retards, les rustines et les contournements qui se produisent, mais que personne ne corrige jamais durablement.
Voici quatre taxes majeures de l'onboarding fournisseur, et comment les éliminer grâce à l'IA agentique.
Taxe n° 1 : le chaos des formats que votre portail n'a jamais été conçu pour gérer
Chaque entreprise dispose d'un portail fournisseur avec un modèle prédéfini. Et voici généralement comment cela se passe :
- Les fournisseurs envoient leurs données dans le format qui leur était le plus simple (Excel, PDF, e-mail, photos d'étiquettes produit, un tableau de 200 lignes enfoui dans une présentation PowerPoint)
- Le portail le rejette
- Le fournisseur soumet à nouveau
- Le portail le rejette encore
- Finalement, quelqu'un traduit tout cela manuellement
Un agent compétent lit ce que le fournisseur a envoyé. il extrait et analyse les informations des PDF et des tableurs, puis dirige les attributs vers les champs appropriés, de manière autonome.
Vos fournisseurs cessent d'être rejetés, et votre équipe est déchargée de son rôle d'interprète.
Quand vous configurez l'agent, gardez cette question à l'esprit : à quoi votre agent compare-t-il les données ? Sans champs normalisés évalués par rapport à une fiche de référence, vous n'avez fait que déplacer le problème un cran plus loin.
Taxe n° 2 : des cycles de resoumission qui transforment des champs manquants en semaines de retard
Un fournisseur envoie une soumission. Il manque quelque chose, ou son fichier ne respecte pas la convention de nommage des SKU. Même rejet.
Après trois tentatives, le fournisseur finit par s'en désintéresser, et votre équipe se retrouve au téléphone à essayer d'obtenir la donnée manuellement.
Dans la plupart des environnements opérationnels, cela représente trois à cinq jours ouvrés. Dans un cycle d'onboarding de nouveaux produits à fort volume, cela se compte en semaines.
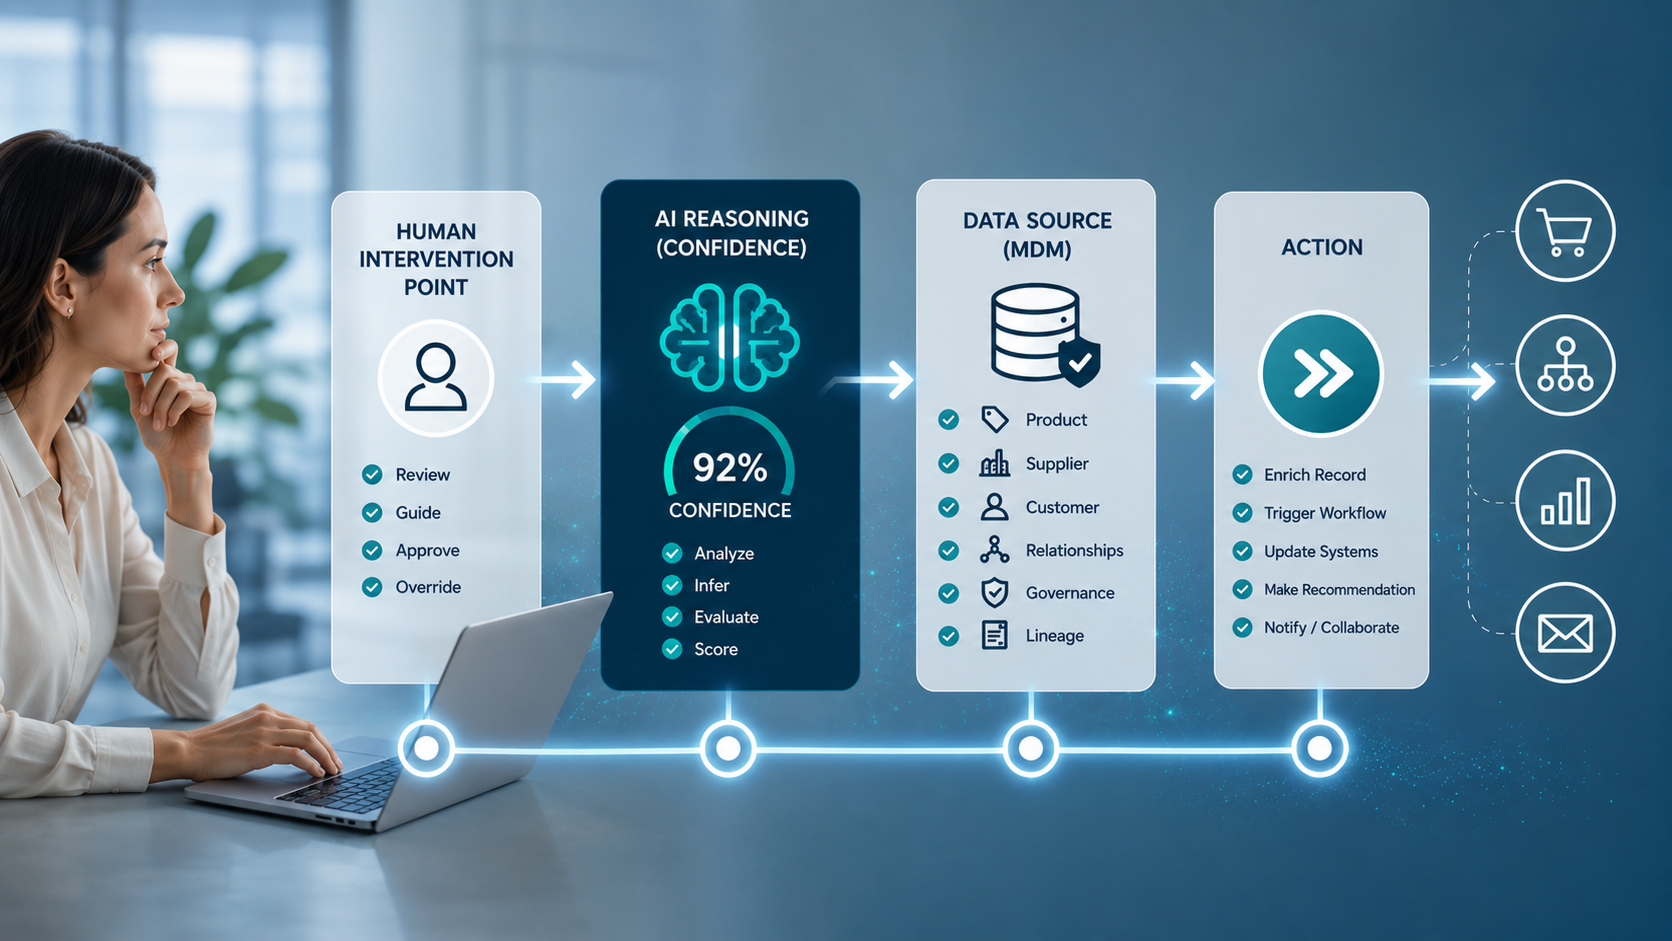
Un agent bien calibré signale tous les problèmes dès la première passe, au lieu d'un problème par cycle. Un score de confiance est attribué à chaque extraction, révélant exactement quels champs nécessitent une vérification humaine.
Ce sont trois ou quatre cycles compressés en une seule revue ciblée.
Quand vous voulez confier cela à des agents IA, il est important de vous demander : l'agent dispose-t-il de tolérances clairement définies ? Sait-il quand signaler pour révision, rejeter, ou laisser passer ?
Sans cela, vous n'avez fait qu'accélérer une boucle défaillante.
Taxe n° 3 : des données structurées piégées dans des documents que votre système ne peut pas lire
J'aime appeler celle-ci le « purgatoire des PDF et des scans ».
- Certificats de contrôle matière (MTR)
- Certificats d'analyse (CoA)
- Fiches de données de sécurité (FDS)
- Étiquettes SGH
- Certifications tierces
Chacun de ces documents arrive sous forme de PDF, de scan ou de photo. Et souvent de mauvaise qualité.
La plupart des flux d'onboarding les traitent comme de simples pièces jointes. Ils sont archivés, et les données structurées qu'ils contiennent n'atteignent jamais la fiche maître. C'est opérationnellement acceptable, jusqu'à un audit, un rappel de produit ou un rapport de durabilité.
Un agent réellement capable de lire un document en extrait les données structurées dès la réception et les route vers les bons emplacements.
Le PDF est toujours archivé, mais les valeurs qui comptent sont capturées, indexables et disponibles en aval dès le jour de réception du document. Pas la semaine où quelqu'un trouve enfin le temps de creuser.
Quand 80 % de complétude ne suffit pas
Même quand les documents sont traités, les nouvelles fiches fournisseur sont rarement complètes à 100 %.
Les 20 % manquants sont presque toujours ce dont les systèmes en aval ont besoin. Les dimensions dont l'entrepôt a besoin, la classe de danger que l'expédition doit connaître avant de charger un transporteur, ou le pays d'origine qui, sans lui, bloque chaque transaction de conformité douanière.
Plutôt que d'inventer la donnée manquante, un agent compétent consulte davantage de sources à la fois et signale précisément quel champ manque et quel système en aval en a besoin.
C'est une conversation bien plus constructive avec votre fournisseur qu'un simple rejet.
Taxe n° 4 : des SKU bloquées qui déstabilisent tout votre planning de production
Chaque jour où une nouvelle référence, un composant ou une matière première n'est pas pleinement intégré, c'est un jour de plus où il n'est ni en rayon, ni au catalogue, ni disponible pour un devis, ni diffusé à un partenaire de distribution.
- Dans l'automobile, un lancement retardé coûte environ un million de dollars par jour
- Dans l'électronique, un retard de 9 à 12 mois peut coûter la moitié du chiffre d'affaires attendu
- Dans les biens de grande consommation (CPG), cela se traduit par des fenêtres saisonnières manquées
L'essentiel de ce frein ne se situe pas dans la décision de production elle-même, mais dans le transfert des données après cette décision.
L'onboarding agentique réduit considérablement ce délai. Il maintient vos plannings intacts et supprime le besoin de réoptimiser en permanence pour des retards qui n'auraient jamais dû se produire.
Réglez ce point, et le reste de la chaîne d'approvisionnement tourne plus vite, sans que personne n'ait à changer de poste.
Deux conditions pour que l'onboarding agentique fonctionne en production, et pas seulement en démo
Vous avez besoin de gouvernance
Les agents qui lisent les documents fournisseurs et écrivent dans votre fiche maître ont besoin de règles, de validation, de pilotage et d'une piste d'audit.
Sans cela, vous avez simplement ajouté une couche de prise en charge rapide au-dessus d'un système incapable de vous dire d'où vient une valeur. C'est un problème différent d'un onboarding lent – et sans doute pire encore.
Vous avez besoin d'une intégration avec les systèmes en aval
L'objectif de nettoyer les données fournisseurs est de faire en sorte que les systèmes de l'autre côté, PIM, ERP, syndication, commerce, reporting réglementaire – voient une seule vérité gouvernée.
Ne cherchez pas un agent qui ingère des données de façon isolée.
Avec Stibo Systems, votre agent se connecte à une plateforme qui sait quoi faire de la donnée
Stibo Systems a été nommé Leader dans le Magic Quadrant™ 2026 de Gartner® pour les solutions de gestion des données maîtresses. Selon nous, cette reconnaissance récompense un socle de données prêt pour l'IA, conçu pour soutenir des workflows agentiques.
Upload Anything est l'agent de Stibo Systems conçu pour une prise en charge agnostique au format – PDF, scans, tableurs, e-mails et images produit.
Chaque valeur extraite reçoit un score de confiance, et les éléments à faible confiance sont signalés pour une révision humaine. Rien n'est écrit dans la fiche maître sans passer par la gouvernance déjà en place sur la plateforme.
C'est la plateforme d'intelligence de confiance qui rend cette gouvernance possible :
- Un moteur de règles et une validation au point de saisie
- Un pilotage complet et une piste d'audit
- Des connexions en direct avec le PIM, l'ERP, la syndication, le commerce et le reporting réglementaire
Si vous évaluez une solution d'onboarding agentique, commencez par la question de la plateforme. N'importe quel agent peut lire un document. Mais toutes les plateformes ne peuvent pas vous dire d'où vient une valeur, qui l'a validée, et vers quel système en aval elle se dirige.
Gartner ne cautionne aucune entreprise, aucun fournisseur, produit ou service décrit dans ses publications, et ne conseille pas aux utilisateurs de technologies de sélectionner uniquement les fournisseurs les mieux notés ou bénéficiant d'une autre distinction. Les publications de Gartner reflètent les opinions de l'organisation de recherche de Gartner et ne doivent pas être interprétées comme des déclarations de fait. Gartner décline toute garantie, expresse ou implicite, concernant cette publication, y compris toute garantie de qualité marchande ou d'adéquation à un usage particulier.
GARTNER est une marque déposée de Gartner, Inc. et/ou de ses filiales. Magic Quadrant est une marque déposée de Gartner, Inc. et/ou de ses filiales et est utilisée ici avec autorisation. Tous droits réservés.
Gartner, Magic Quadrant for Master Data Management Solutions, par Stephen Kennedy et al., 6 avril 2026.