La mise en service des produits devrait être simple. Les fournisseurs fournissent leurs informations, les équipes les vérifient par rapport à leurs exigences, puis les nouveaux produits sont intégrés dans les systèmes et les processus qui permettent leur mise sur le marché.
Dans la pratique, le processus est rarement aussi simple.
Chaque fournisseur a sa propre façon de travailler. L’un envoie un tableur avec des en-têtes de colonnes personnalisés, tandis qu’un autre partage ses spécifications techniques dans un fichier PDF. Les informations peuvent être organisées différemment, utiliser une terminologie différente ou comporter des attributs qui ne correspondent pas parfaitement au modèle de données produit de l’entreprise destinataire.
S’il est vrai qu’un système de gestion des informations produit peut fournir la structure nécessaire pour gérer ces informations une fois qu’elles sont reçues, les équipes doivent tout de même s’assurer au préalable que les données des fournisseurs sont intégrées dans la bonne structure. Cela implique souvent d’identifier manuellement les catégories, de mettre en correspondance les attributs, de valider les valeurs, de corriger les erreurs et de recontacter les fournisseurs pour obtenir des précisions.
Cela fait de la collecte l’un des goulots d’étranglement les plus tenaces dans l’intégration des produits, même pour les organisations disposant de processus de gestion des données bien rodés.
Pourquoi l’intégration des produits reste-t-elle si difficile ?
Les détaillants, fabricants, distributeurs et grossistes ont besoin de davantage d’informations sur les produits provenant d’un nombre croissant de fournisseurs. Parallèlement, les clients s’attendent à disposer de spécifications détaillées, de descriptions précises, d’images, de vidéos et d’autres contenus partout où ils rencontrent un produit.
La demande d’informations ne cesse d’augmenter, mais le processus d’intégration des fournisseurs commence souvent par des fichiers qui n’ont pas été créés pour le modèle de données de l’entreprise destinataire.
Un fournisseur peut être amené à :
- Reformater les informations produit existantes
- Se familiariser avec un nouveau portail ou un nouveau modèle
- Faire correspondre des noms d’attributs inconnus
- Identifier les catégories de produits appropriées
- Compléter les informations manquantes conformément aux exigences du destinataire
- Corriger les erreurs au fil d’échanges d’e-mails répétés
L’équipe chargée de la réception est confrontée à l’autre facette du même problème. Les gestionnaires de données et les spécialistes de l’intégration doivent interpréter chaque soumission, déterminer à quelle catégorie appartiennent les produits, faire correspondre la terminologie des fournisseurs aux attributs internes et identifier les informations manquantes ou invalides.
Ce travail manuel rend difficile l’augmentation du nombre de fournisseurs, de catégories et de produits intégrés — sans pour autant réduire l’effort nécessaire pour les prendre en charge.
Les modèles déplacent la charge de travail au lieu de la supprimer
Les processus d’intégration traditionnels font souvent peser la charge de la transformation sur le fournisseur.
Le fournisseur reçoit un modèle, transforme les informations existantes pour les adapter à celui-ci, puis soumet le résultat. Si le format, les catégories ou les valeurs sont incorrects, le fichier est renvoyé pour être retravaillé. Cela crée des frictions pour le fournisseur et alourdit la charge de travail de l’organisation chargée de collecter les données.
Les modèles permettent d’assurer la cohérence dès lors que les fournisseurs les suivent correctement. Mais ils n’éliminent pas le travail nécessaire pour transposer les informations existantes dans une structure qui leur est inconnue. Ils déterminent simplement qui doit s’en charger.
Pourquoi la collecte des données constitue le véritable goulot d’étranglement de l’intégration
Les informations fournies par les fournisseurs doivent être interprétées avant de pouvoir être gérées. Les équipes doivent comprendre la structure des fichiers, identifier les produits et les catégories concernés, faire correspondre la terminologie du fournisseur aux attributs internes et déterminer si les informations répondent aux exigences établies.
Lorsque ces étapes reposent largement sur un travail manuel, chaque nouveau fournisseur ou chaque nouvelle source de données implique un nouvel exercice de mise en correspondance et de validation. Le processus peut être gérable pour un seul fichier, mais il devient difficile à mettre à l’échelle face à la multiplication des gammes de produits, des catégories et des réseaux de fournisseurs.
Le rôle de l’IA dans l’intégration des produits
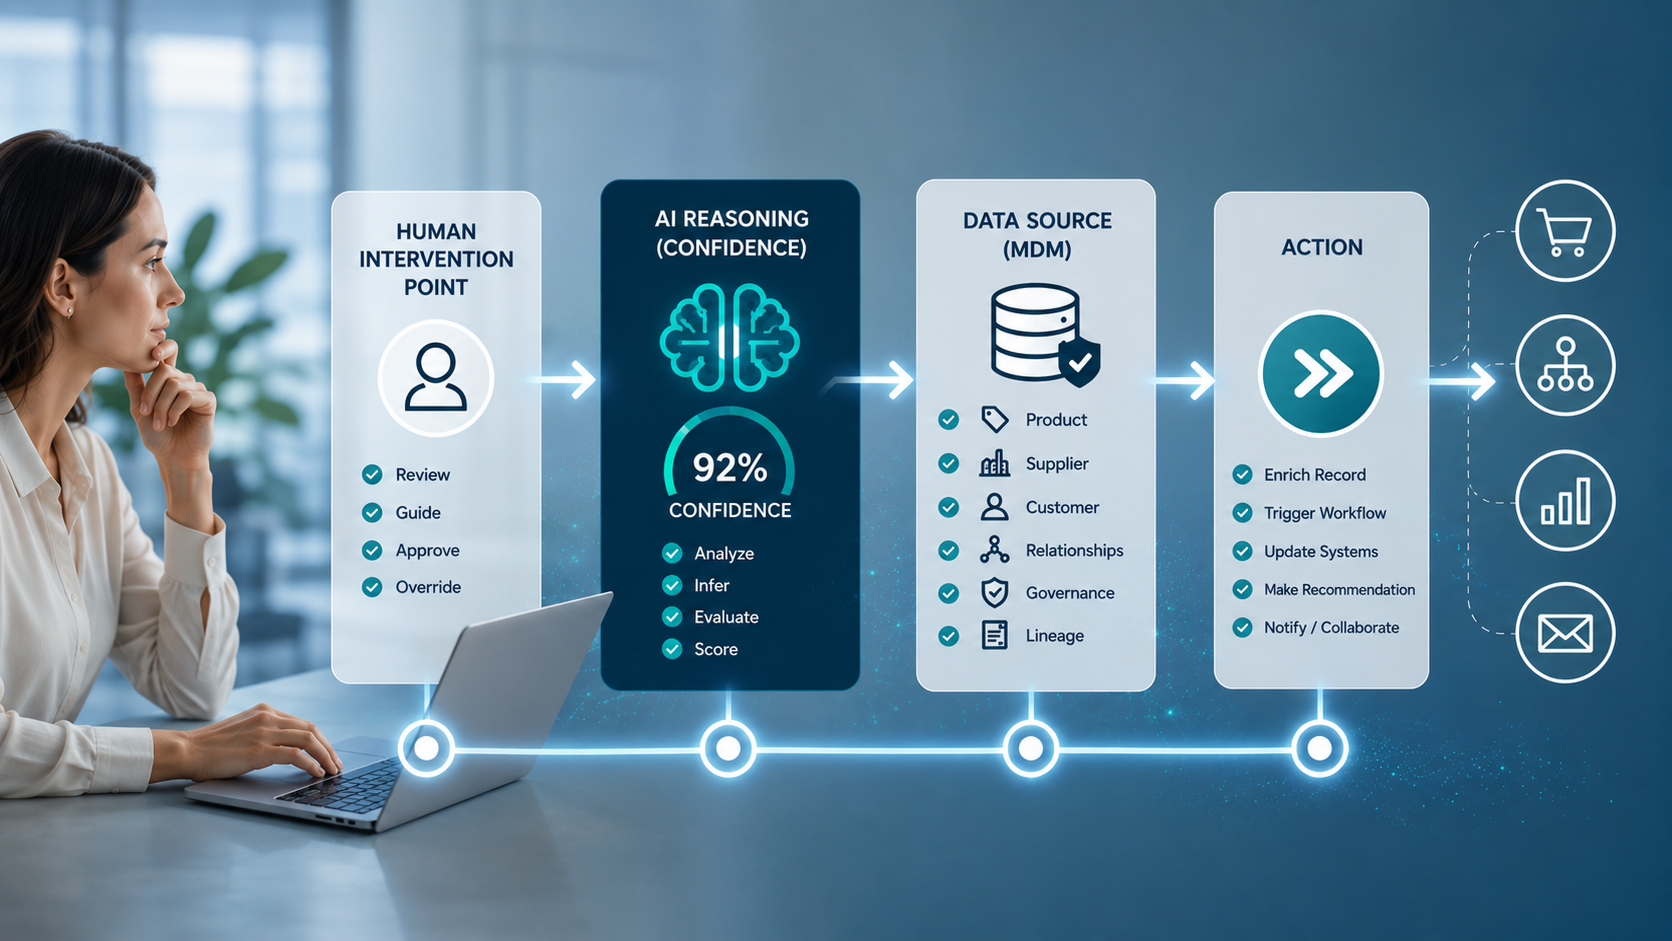
L’IA agentique peut prendre en charge les tâches d’interprétation répétitives sans supprimer les contrôles établis du processus d’intégration.
Un agent IA peut examiner le format, la structure et le contenu d’un fichier fournisseur entrant, comparer ces informations au schéma de l’organisation destinataire et aider à déterminer comment les données doivent être classées et mappées. La validation permet ensuite de mettre en évidence les informations manquantes ou erronées avant que les produits ne passent aux processus en aval.
L’objectif ici n’est pas une intégration autonome sans supervision, mais une répartition plus efficace du travail. Dans ce scénario, l’IA se charge de l’interprétation et du mappage répétitifs tandis que les humains conservent une visibilité sur les décisions, les problèmes et les exceptions qui nécessitent une attention particulière.
Quelle valeur peut apporter l’intégration assistée par l’IA ?
Utilisée efficacement, l’intégration assistée par l’IA peut permettre de transférer plus rapidement les informations des fournisseurs de leur format d’origine vers un workflow régulé, en réduisant les interprétations manuelles et les échanges entre les fournisseurs et les équipes chargées de l’intégration.
Les avantages potentiels s’étendent à l’ensemble du processus d’intégration :
Moins d’allers-retours avec les fournisseurs
Les fournisseurs peuvent partir de fichiers qui leur sont familiers plutôt que de devoir reformater sans cesse les informations pour les adapter à un nouveau modèle.
Moins de mappage manuel
L’agent aide à interpréter les attributs des fournisseurs et à les relier au modèle de données de l’organisation destinataire.
Identification plus précoce des problèmes
La validation permet de mettre en évidence les informations manquantes ou erronées avant que les produits ne progressent dans la chaîne logistique.
Moins de demandes d’assistance
Un processus mieux guidé permet de réduire l’effort manuel requis de la part des équipes chargées de l’intégration des fournisseurs et de l’assistance.
Croissance plus évolutive de l’assortiment
Les entreprises peuvent intégrer davantage de fournisseurs, de produits, de catégories et de contenus sans que le travail manuel n'augmente au même rythme.
Ces résultats contribuent à un objectif plus large : aider les entreprises à élargir leur gamme et à commercialiser leurs produits plus rapidement sans sacrifier la qualité ni le contrôle des données.
Comment les équipes peuvent-elles se préparer à l’intégration assistée par des agents ?
Les entreprises n’ont pas besoin d’attendre le lancement d’un projet de mise en œuvre pour commencer à examiner si cette approche pourrait créer de la valeur.
Commencez par cartographier le processus d’intégration actuel et identifiez les points de blocage :
- Combien de temps faut-il pour qu’un nouveau produit ou article soit mis en ligne ?
- À quel stade le processus ralentit-il ?
- Combien de temps est consacré à la transformation ou à la correction des fichiers fournisseurs ?
- À quelle fréquence les équipes doivent-elles relancer les fournisseurs pour obtenir des informations manquantes ?
- Quels formats, catégories ou attributs génèrent le plus de travail d'assistance ?
- Qu'est-ce qui empêche l'entreprise d'intégrer davantage de fournisseurs ou de produits ?
Les équipes doivent également s’entretenir avec les personnes chargées de gérer les relations avec les fournisseurs. Celles-ci constatent souvent des frictions qui n’apparaissent pas sur un diagramme de workflow, telles que des fournisseurs confrontés à des modèles peu familiers, des fichiers corrompus, des exigences peu claires ou des outils qu’ils utilisent rarement.
Cartographier ces points sensibles permet d’établir une base de référence concrète. Cela aide l’entreprise à identifier les domaines dans lesquels un agent pourrait réduire les tâches répétitives et ceux où l’expertise humaine, la vérification ou la collaboration avec les fournisseurs resteront indispensables.
Cette évaluation permet de déterminer l’origine du problème. Il peut s’agir des formats de fichiers utilisés par les fournisseurs, d’exigences peu claires, d’un travail de mise en correspondance répétitif, d’informations manquantes ou des outils que les fournisseurs sont censés maîtriser. L’identification de ces frictions fournit une base de référence concrète pour décider où l’IA peut réduire les tâches répétitives et où l’expertise humaine reste indispensable.
Découvrez l’agent « Upload Anything »
Notre agent « Upload Anything » est un agent IA commercialisé, conçu pour aider les organisations à intégrer plus rapidement de nouvelles sources de données produit.
Au lieu d’exiger des fournisseurs qu’ils restructurent les informations produit avant de les soumettre, l’agent mappe automatiquement les fichiers entrants selon le schéma et les exigences de l’organisation destinataire. Upload Anything permet de :
- Adapter les attributs des fournisseurs au modèle de données de l’entreprise destinataire
- De vérifier si les informations produit répondent aux exigences définies
- D'identifier les problèmes nécessitant une attention particulière avant la soumission
- Transférer les données produit préparées vers le workflow d’intégration établi
L’agent s’adapte aux besoins des fournisseurs tout en aidant l’organisation destinataire à intégrer leurs informations dans la structure requise par l’entreprise.
Comment fonctionne Upload Anything ?
Dans le cadre de notre solution d’intégration des données produit, les fournisseurs soumettent leurs informations produit à l’aide de feuilles de calcul courantes ou de documents PDF. L’agent analyse le fichier, propose des catégories et des correspondances d’attributs, et aide à identifier les problèmes liés aux données. Les utilisateurs peuvent ensuite examiner les résultats, traiter les exceptions et poursuivre les processus de validation et de soumission établis.
Le processus de saisie assistée prend fin là où commence le workflow d’intégration standard et réglementé. Cela permet de réduire les tâches de préparation répétitives sans dissocier les données entrantes des contrôles qualité existants.
Impliquer les personnes lorsque le jugement est nécessaire
Accélérer l’intégration ne doit pas signifier renoncer au contrôle.
L’agent peut suggérer des catégories et des mappages d’attributs, mais les utilisateurs humains peuvent toujours examiner les résultats et résoudre les problèmes avant que les données ne soient transmises.
C’est particulièrement important pour les informations sur les produits. Une catégorie ou un mappage d’attributs incorrect peut affecter la recherche, la navigation, la conformité, la syndication et l’expérience client. L’automatisation du travail d’interprétation initial permet de réduire l’effort manuel, tandis que la révision et la validation contribuent à garantir que les données finales restent conformes aux exigences métier.
L’objectif final va au-delà d’une simple intégration autonome sans supervision. La véritable vision réside dans une répartition plus efficace du travail, dans laquelle l’IA se charge des tâches répétitives d’interprétation et de mappage, tandis que les humains conservent une visibilité sur les décisions et les exceptions qui nécessitent une attention particulière.
Des fichiers fournisseurs aux informations produit prêtes à être commercialisées
L’IA agentique s’avère particulièrement utile lorsqu’elle s’attaque à des tâches que les équipes savent déjà lentes, répétitives et difficiles à mettre à l’échelle.
L’intégration des produits en est un excellent exemple. Les informations fournisseurs peuvent déjà être utiles et bien gérées, mais elles doivent encore être interprétées, classées, mises en correspondance et alignées sur les exigences de l’organisation destinataire avant de pouvoir alimenter les fiches produits, le contenu, la diffusion et d’autres processus en aval.
Upload Anything permet de prendre en charge ce travail initial d’interprétation et de mise en correspondance tout en conservant les processus de révision, de validation et d’intégration établis.
Les fournisseurs peuvent commencer avec les informations et les formats qu’ils utilisent déjà. L’agent aide à aligner ces informations sur le modèle de données et les exigences de l’entreprise destinataire, tandis que les collaborateurs restent impliqués dans la résolution des problèmes et l’avancement du processus.
Le résultat va bien au-delà d’un simple téléchargement de fichiers plus rapide. Il s’agit d’une méthode plus évolutive pour mettre en ligne de nouvelles sources de catalogues, créer des informations produit prêtes à être commercialisées et accélérer la mise en rayon.
Foire aux questions
Qu'est-ce que l'Upload Anything Agent ?
Upload Anything est un agent IA productisé qui aide à intégrer plus rapidement de nouvelles sources de données produit. Il interprète les fichiers fournisseurs entrants et mappe les attributs des fournisseurs au modèle de données cible, aidant ainsi à intégrer plus rapidement les nouvelles sources de catalogues pour accélérer la mise en rayon.
Quels formats de fichiers le Upload Anything Agent prend-il en charge ?
La version initiale se concentre sur les tableurs courants et les documents PDF, y compris les fichiers fournisseurs et les spécifications techniques. Le support pour des formats supplémentaires est prévu dans la feuille de route.
L'Upload Anything Agent remplace-t-il l'examen humain ?
Non. L'agent suggère des catégories et des mappages d'attributs, tandis que les utilisateurs peuvent examiner les résultats, résoudre les problèmes et valider les données avant la soumission. Cela réduit le travail répétitif d'interprétation et de cartographie tout en maintenant les personnes impliquées là où le jugement est nécessaire.
Comment l'Upload Anything Agent fonctionne-t-il avec les processus d'intégration existants ?
L'agent aide à interpréter, catégoriser et cartographier les informations des fournisseurs entrants avant qu'elles ne passent aux processus de validation et de soumission standard. L'agent travaille au sein de notre solution d'intégration des données produit, avec des flux de travail d'intégration établis qui se poursuivent après que l'agent a préparé les données.
Quels sont les avantages de l'intégration de produits assistée par l'IA ?
L'intégration assistée par l'IA peut réduire la cartographie manuelle des attributs, les allers-retours avec les fournisseurs, les demandes de support et le temps nécessaire pour identifier les problèmes de données. Cela peut également aider les organisations à intégrer plus de fournisseurs, de produits et de catégories sans augmenter l'effort manuel dans la même proportion.
Comment les détaillants peuvent-ils réduire le temps de mise sur le marché grâce à une meilleure intégration des données produit ?
Les détaillants peuvent réduire le temps de mise sur le marché en facilitant la collecte, la cartographie et la validation des données produits des fournisseurs avant leur publication et leur intégration dans les flux de travail en aval. Accepter les informations dans des formats familiers aux fournisseurs, identifier les catégories et les mappages d'attributs plus tôt, et mettre en évidence les valeurs manquantes ou incorrectes avant la soumission peut réduire le travail manuel, les corrections répétées et les allers-retours avec les fournisseurs. Cela crée un chemin plus évolutif depuis les informations des fournisseurs entrants jusqu'aux données produit fiables et régulées, prêtes pour le commerce.