De nombreuses entreprises du secteur bancaire, des services financiers et de l'assurance (BFSI) estiment que leurs données clients sont conformes. Mais lorsqu'un organisme de réglementation leur demande d'en apporter la preuve, leur confiance commence à vaciller.
Une preuve, ce n’est pas simplement une politique rangée dans un dossier de gouvernance. Les autorités de régulation veulent quelque chose de plus concret que cela.
Pour un client et une décision donnés, les entreprises doivent démontrer :
- quel enregistrement a été jugé fiable, et pourquoi il a été utilisé pour une décision donnée
- D’où provenaient les données, et à qui elles appartenaient
- quelles données et quels contrôles ont étayé la décision, et qui a approuvé les éventuelles exceptions
La plupart des équipes chargées de la conformité sont capables de décrire leurs processus en détail. Mais rares sont celles qui peuvent produire rapidement ces éléments justificatifs pour un client donné, une décision précise et un moment précis.
Disposer d’une politique ne revient pas à être capable de démontrer qu’elle a été appliquée de manière cohérente, et c’est précisément cette différence qui pose problème à de nombreuses entreprises du secteur BFSI. Les règles sont en place, mais elles ne disposent pas d’un moyen rapide et défendable de prouver qu’elles les respectent.
Voici un moyen simple de vérifier si votre entreprise est capable de fournir ces preuves rapidement et de manière cohérente.
Vos données clients peuvent-elles résister à un examen minutieux des autorités de régulation ?
Si une autorité de régulation vous demandait des preuves concernant un client et une décision, votre équipe serait-elle en mesure de répondre en quelques minutes, ou passeriez-vous des semaines à rechercher ce client dans des systèmes qui n’ont jamais été conçus pour communiquer entre eux, à faire correspondre des noms et des adresses qui ne concordent pas avant même de pouvoir commencer ?
Pour répondre rapidement, deux éléments sont essentiels :
- Une version fiable de ce client, au lieu de plusieurs versions contradictoires
- Une piste traçable indiquant d’où proviennent les données et qui les a validées
De nombreuses entreprises ont encore du mal à fournir ces deux éléments rapidement et de manière cohérente, en particulier lorsque les données justificatives sont dispersées dans plusieurs systèmes.
Que demandent actuellement les autorités de régulation ?
Les différents cadres réglementaires imposent des obligations variées aux entreprises du secteur BFSI, mais plusieurs d'entre eux accordent une importance croissante à la gouvernance, à la responsabilité et aux preuves tangibles.
- Le « Consumer Duty » et la FCA, qui exigent des entreprises qu’elles évaluent, comprennent et justifient les résultats obtenus par les clients particuliers
- Le RGPD, qui impose aux entreprises de savoir quelles données à caractère personnel elles détiennent, pourquoi elles sont traitées, combien de temps elles doivent être conservées et comment les droits individuels sont garantis
- La directive DORA, qui impose aux entreprises financières de renforcer la gestion des risques liés aux TIC, la résilience opérationnelle et la surveillance des fournisseurs de technologies critiques
- La loi européenne sur l’IA, qui instaure des obligations en matière de gouvernance, de transparence et de gestion des risques pour certains systèmes d’IA utilisés dans les services financiers.
Tout cela n’est pas nouveau. Ce qui a changé, c’est le niveau de détail que les régulateurs attendent sur simple demande.
Lorsqu’un régulateur pointe du doigt un client et demande les raisons qui ont motivé une décision, vous devez être en mesure de relier le résultat aux données, aux contrôles et aux validations qui l’ont étayé.
Comment les systèmes isolés créent-ils des angles morts en matière de conformité pour les entreprises du secteur BFSI ?
Chaque système d’une entreprise du secteur BFSI collecte des données clients à des fins commerciales différentes.
Par exemple, une plateforme bancaire centrale peut enregistrer un compte, un CRM une relation client, un système de gestion des contrats une police d'assurance, et une plateforme de gestion des sinistres un événement ou un sinistre. Chacun de ces systèmes met à jour sa propre version selon son propre calendrier, en utilisant les informations saisies à ce moment-là par un client ou un collègue.
Au fil des mois et des années, ces enregistrements finissent par diverger. Rien ne les oblige à correspondre les uns aux autres, et rien n’indique à qui se fier.
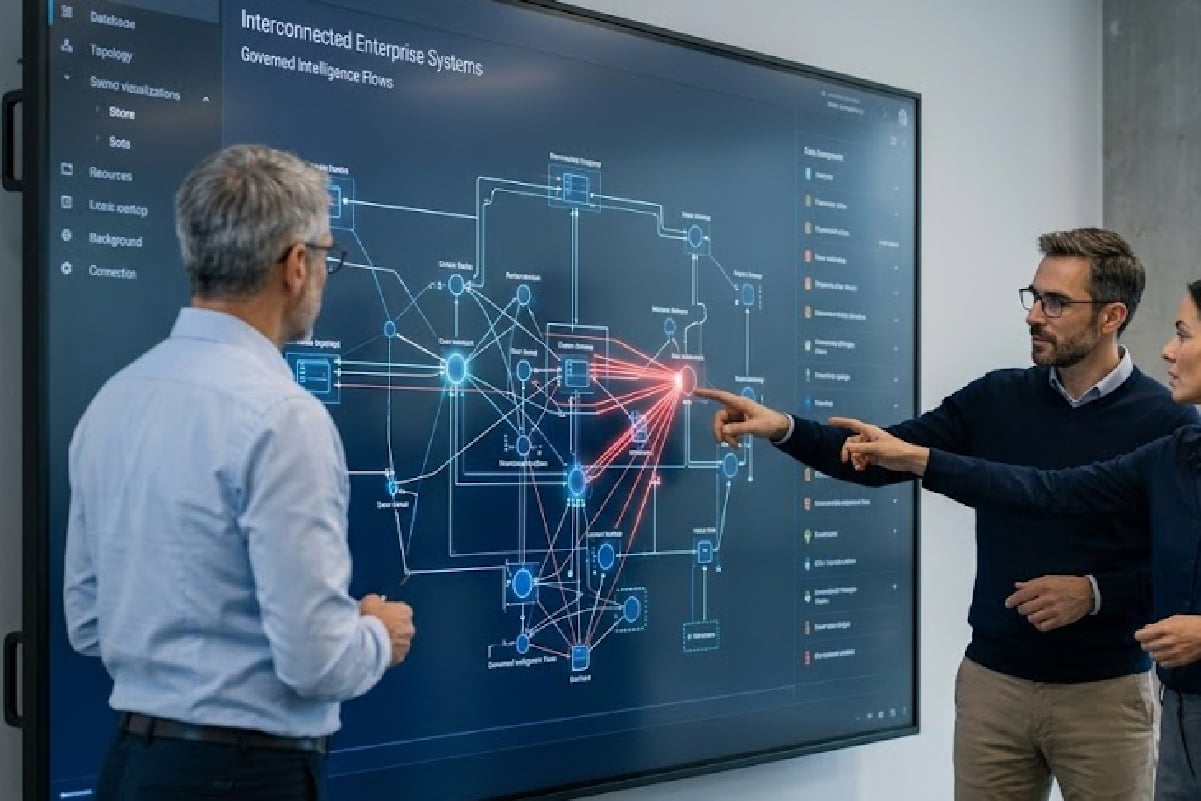
Il peut en résulter plusieurs versions d’une même personne ou organisation, avec des adresses, des identifiants, des rôles et des relations différents, réparties entre des systèmes qui n’ont jamais été conçus pour les harmoniser.
Quels problèmes peuvent survenir lors d’une mise à jour des données KYC, par exemple ?
- Le système bancaire central indique une adresse datant d’il y a trois ans
- Le CRM en possède une plus récente
- La plateforme d'intégration désigne une entité juridique différente pour le même bénéficiaire effectif, car un formulaire a été rempli par une autre personne à un autre moment de la relation
Chaque enregistrement était peut-être valide dans son contexte d’origine, mais pris ensemble, ils présentent une image contradictoire et incomplète. Avant de pouvoir entamer l’examen, l’équipe doit déterminer si les enregistrements concernent bien la même personne, quelle source est à jour et quelles informations sont fiables.
C’est à ce moment-là que vous ne pouvez plus répondre à un organisme de contrôle en quelques minutes.
Pourquoi l’IA fait-elle des données clients insuffisantes un risque de conformité encore plus important ?
Un modèle d’IA considère comme un fait absolu tout dossier client qu’il reçoit. Il prend une décision en quelques millisecondes, que cette décision soit :
- Une ligne de crédit
- Une autorisation d’ouverture de compte
- Un contrôle d’adéquation
- Un signalement de fraude
- Une décision relative à une demande d'indemnisation
- Un renvoi vers le service de souscription
- Une évaluation de la vulnérabilité du client
À moins que les enregistrements contradictoires ou obsolètes ne soient identifiés et traités en amont, ils risquent d’être traités avec la même confiance apparente que des données fiables. Un enregistrement non fiable peut donc influencer les décisions rapidement et à grande échelle.
De plus en plus, les entreprises doivent être en mesure d’expliquer non seulement comment un modèle a fonctionné, mais aussi quelles données ont étayé ses résultats, d’où provenaient ces données et quels contrôles ont été appliqués.
- Les erreurs manuelles peuvent rester isolées ou être détectées au cas par cas
- Les processus automatisés peuvent reproduire le même problème lié aux données sur un échantillon beaucoup plus large
Le test que j’ai mentionné plus haut s’applique ici aussi. Mais dans ce cas, le problème se propage à la vitesse de la machine. Une entreprise qui ne pouvait pas rendre des comptes pour un seul client en quelques minutes dispose désormais d’un modèle qui répète cette même décision non validée pour des milliers de clients avant que quiconque ne s’en aperçoive.
Pourquoi est-il encore difficile de prouver l’efficacité de politiques de conformité rigoureuses ?
De nombreuses entreprises du secteur BFSI disposent déjà de politiques détaillées, de cadres de gouvernance des données et de contrôles documentés.
Le problème se pose lorsqu'il s'agit de prouver que la politique a bien été respectée :
- Pour un client
- Un jour donné
- Pour une décision
Le véritable test consiste à vérifier si les données, les contrôles et les validations qui sous-tendent une décision ont été enregistrés et sont accessibles au moment où quelqu’un en fait la demande. La plupart des entreprises vérifient si les politiques et les contrôles existent, mais sont parfois moins bien préparées à tester la rapidité avec laquelle les pièces justificatives peuvent être rassemblées pour un client réel ou une décision concrète.
Et c’est là que réside le véritable défi.
Une récente étude de McKinsey sur la préparation des données pour l’IA parvient à une conclusion similaire d’un point de vue technique : l’IA n’abaisse pas la barre en matière de qualité des données, mais elle augmente le coût et la rapidité avec lesquels une erreur peut se produire. Cette même étude a révélé que seules 7 % des entreprises ont pleinement déployé l’IA à l’échelle de leur organisation. Principalement parce que les données sous-jacentes n’étaient pas prêtes à la prendre en charge.
Comment les entreprises du secteur BFSI peuvent faciliter la production de preuves de conformité
Pour résoudre ce problème, il faut commencer par considérer les données fiables des clients et des tiers comme une infrastructure partagée.
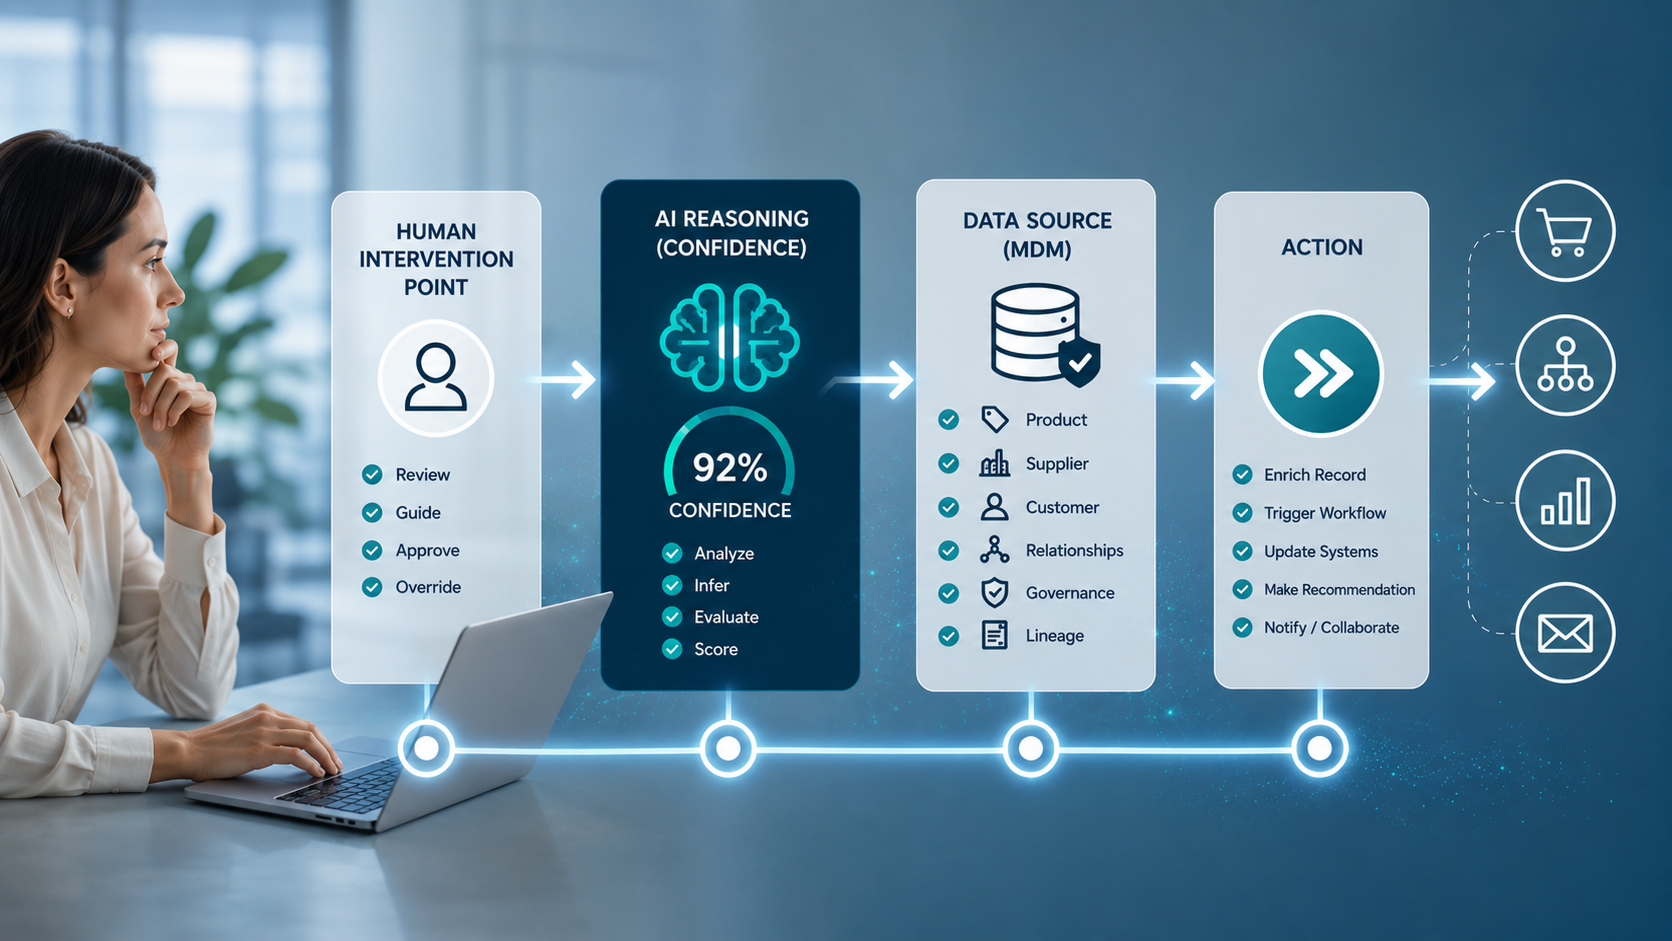
Customer Experience Data Cloud, la solution de gestion des données clients reposant sur STEP, la plateforme d’intelligence de confiance de Stibo Systems, offre aux entreprises du secteur BFSI une base de données de référence gouvernée qui leur permet de relier les identités, d’appliquer des règles transparentes et de conserver la trace de la manière dont les enregistrements fiables ont été créés. La solution :
- applique des règles transparentes de mise en correspondance et de survie, aidant ainsi les entreprises à comprendre pourquoi les enregistrements ont été liés et quelles valeurs ont été sélectionnées
- Assure la traçabilité, en indiquant d’où provient chaque élément de données client et quand il a été modifié pour la dernière fois
- Gère les relations et les hiérarchies entre les clients, les comptes, les polices, les organisations, les courtiers et les parties liées
- Prend en charge les workflows de gestion et de traitement des exceptions afin que les décisions importantes en matière d’identité puissent être examinées plutôt que de rester cachées au sein de la logique du système
Des entreprises telles que Royal London gèrent déjà leurs données clients de cette manière. Celles qui satisfont aux exigences des autorités de régulation sont en mesure de répondre instantanément, à chaque fois qu’une question leur est posée, quel que soit le volume de documentation contenu dans un dossier.
Foire aux questions
Quelle est la différence entre un CRM, un lac de données et une couche d'identité gouvernée à des fins de conformité ?
Un CRM enregistre les interactions avec un client. Un lac de données stocke et analyse des données brutes. Aucun des deux n'est conçu pour décider quelle version d'un enregistrement client est correcte, ni pour rendre cette décision explicable, ce que fait une couche d'identité gouvernée.
Quand la loi européenne sur l'IA s'applique-t-elle aux entreprises BFSI utilisant l'IA dans les décisions clients ?
Le règlement européen sur l'IA entrera pleinement en vigueur en août 2026, avec des obligations spécifiques pour les systèmes d'IA à haut risque, ce qui couvre de nombreuses décisions de crédit, d'intégration, de réclamations et de souscription pilotées par l'IA dans le secteur BFSI.
Une couche d'identité gouvernée remplace-t-elle le besoin d'un programme de gouvernance des données ?
Non. Cela donne à un programme de gouvernance quelque chose à faire respecter. La politique établit les règles ; la couche d'identité est ce qui permet de vérifier ces règles par rapport à un véritable dossier client.
Une entreprise peut-elle être conforme sur le papier mais échouer à un audit d'IA ?
Oui, et cela devient l'un des écarts les plus courants que les régulateurs découvrent. Une politique documentée montre l'intention. Un audit de l'IA teste si les données derrière une décision réelle correspondent à cette intention, ce qui est une question complètement différente.
Que se passe-t-il avec les données clients héritées créées avant l'application des règles actuelles ?
Les données héritées ne bénéficient pas d'une exemption. Si cela alimente encore une décision client aujourd'hui, un régulateur peut toujours demander des preuves à ce sujet, peu importe quand l'enregistrement a été initialement créé.
À quelle fréquence une entreprise devrait-elle tester si elle peut produire cette preuve ?
Il n'y a pas d'intervalle réglementaire fixe, mais les entreprises leaders le traitent comme une répétition générale, en effectuant le test en interne sur un scénario client réel plutôt que d'attendre qu'un régulateur le fasse en premier.