Viele Unternehmen aus dem Bank-, Finanzdienstleistungs- und Versicherungssektor (BFSI) sind der Ansicht, dass ihre Kundendaten den Vorschriften entsprechen. Wenn eine Aufsichtsbehörde sie jedoch auffordert, dies nachzuweisen, gerät ihr Selbstvertrauen ins Wanken.
Ein Nachweis ist nicht dasselbe wie eine Richtlinie, die in einem Ordner zur Unternehmensführung schlummert. Die Aufsichtsbehörden wollen etwas Konkreteres als das.
Für einen bestimmten Kunden und eine bestimmte Entscheidung müssen Unternehmen Folgendes nachweisen:
- Welcher Datensatz als vertrauenswürdig eingestuft wurde und warum er für eine bestimmte Entscheidung herangezogen wurde
- Woher die Daten stammten und wem sie gehörten
- Welche Daten und Kontrollmaßnahmen die Entscheidung gestützt haben und wer etwaige Ausnahmen genehmigt hat
Die meisten Compliance-Teams können ihre Prozesse detailliert beschreiben. Doch nur wenige sind in der Lage, diese Belege schnell vorzulegen – für einen bestimmten Kunden, eine bestimmte Entscheidung und einen bestimmten Zeitpunkt.
Eine Richtlinie zu haben ist nicht dasselbe wie nachweisen zu können, dass sie konsequent angewendet wurde – und genau an diesem Unterschied scheitern viele Unternehmen aus dem Finanzsektor. Die Regeln sind zwar vorhanden, aber es fehlt ihnen an einer schnellen, stichhaltigen Möglichkeit, nachzuweisen, dass sie diese auch befolgen.
Hier ist eine einfache Methode, um zu prüfen, ob Ihr Unternehmen diese Nachweise schnell und konsistent vorlegen kann.
Halten Ihre Kundendaten einer behördlichen Überprüfung stand?
Wenn eine Aufsichtsbehörde Sie um Nachweise zu einem Kunden und einer Entscheidung bitten würde, könnte Ihr Team dann innerhalb weniger Minuten antworten, oder würden Sie Wochen damit verbringen, diesen Kunden quer durch Systeme zu suchen, die nie dafür ausgelegt waren, miteinander zu kommunizieren, und Namen und Adressen abzugleichen, die nicht übereinstimmen, bevor Sie überhaupt anfangen könnten?
Eine schnelle Antwort hängt von zwei Faktoren ab:
- Eine einzige vertrauenswürdige Version der Kundendaten statt mehrerer widersprüchlicher
- Ein nachvollziehbarer Pfad, der zeigt, woher die Daten stammen und wer sie genehmigt hat
Viele Unternehmen haben nach wie vor Schwierigkeiten, beides schnell und konsistent zu gewährleisten, insbesondere wenn die zugrunde liegenden Daten über mehrere Systeme verteilt sind.
Was verlangen die Aufsichtsbehörden derzeit?
Unterschiedliche regulatorische Rahmenbedingungen erlegen BFSI-Unternehmen unterschiedliche Verpflichtungen auf, doch viele legen zunehmend Wert auf Governance, Rechenschaftspflicht und nachweisbare Belege.
- Die „Consumer Duty“ und die FCA verlangen von den Unternehmen, die Ergebnisse für Privatkunden zu bewerten, zu verstehen und nachzuweisen
- die DSGVO, die von Unternehmen verlangt, zu verstehen, welche personenbezogenen Daten sie speichern, warum diese verarbeitet werden, wie lange sie aufbewahrt werden sollten und wie die Rechte des Einzelnen gewahrt werden
- DORA, die von Finanzunternehmen verlangt, das IKT-Risikomanagement, die operative Widerstandsfähigkeit und die Aufsicht über kritische Technologieanbieter zu stärken
- Das EU-KI-Gesetz, das für bestimmte in Finanzdienstleistungen eingesetzte KI-Systeme Verpflichtungen in Bezug auf Governance, Transparenz und Risikomanagement einführt.
All dies ist kein Neuland. Was sich geändert hat, ist der Detaillierungsgrad, den die Aufsichtsbehörden auf Anfrage erwarten.
Wenn eine Aufsichtsbehörde einen bestimmten Kunden herausgreift und nach der Begründung für eine bestimmte Entscheidung fragt, müssen Sie in der Lage sein, das Ergebnis mit den Daten, Kontrollmaßnahmen und Genehmigungen in Verbindung zu bringen, auf denen es beruhte.
Wie entstehen durch isolierte Systeme Compliance-Blindflecken für Unternehmen der Finanz-, Versicherungs- und Bankbranche?
Jedes System in einem BFSI-Unternehmen erfasst Kundendaten für einen anderen geschäftlichen Zweck.
Beispielsweise kann eine Kernbankplattform ein Konto erfassen, ein CRM-System eine Kundenbeziehung, ein Policenverwaltungssystem einen Vertrag und eine Schadenbearbeitungsplattform ein Ereignis oder einen Schaden. Jedes dieser Systeme aktualisiert seine eigene Version nach eigenem Zeitplan und verwendet dabei die Angaben, die ein Kunde oder Kollege zu diesem Zeitpunkt eingegeben hat.
Im Laufe von Monaten und Jahren driften diese Datensätze auseinander. Nichts zwingt sie dazu, miteinander übereinzustimmen, und nichts gibt Aufschluss darüber, welcher Version man vertrauen soll.
Das Ergebnis können mehrere Versionen derselben Person oder Organisation sein, mit unterschiedlichen Adressen, Identifikatoren, Rollen und Beziehungen, verteilt über Systeme, die nie dafür ausgelegt waren, diese miteinander abzugleichen.
Was läuft beispielsweise bei einer KYC-Aktualisierung schief?
- Das Kernbankensystem führt eine Adresse von vor drei Jahren auf
- Das CRM enthält eine neuere
- Die Onboarding-Plattform gibt für denselben wirtschaftlichen Eigentümer eine andere juristische Person an, da ein Formular zu einem anderen Zeitpunkt der Geschäftsbeziehung von einer anderen Person ausgefüllt wurde
Jeder Datensatz mag in seinem ursprünglichen Kontext gültig gewesen sein, doch zusammen ergeben sie ein widersprüchliches und unvollständiges Bild. Bevor die Überprüfung beginnen kann, muss das Team feststellen, ob sich die Datensätze auf dieselbe Person beziehen, welche Quelle aktuell ist und welchen Informationen vertraut werden kann.
In solchen Fällen ist es nicht mehr möglich, einer Aufsichtsbehörde innerhalb weniger Minuten eine Antwort zu geben.
Warum macht KI unzureichende Kundendaten zu einem noch größeren Compliance-Risiko?
Ein KI-Modell behandelt jeden Kundendatensatz, den es erhält, als Tatsache. Es trifft innerhalb von Millisekunden eine Entscheidung, ganz gleich, ob diese Entscheidung lautet:
- Einen Kreditrahmen
- Eine Onboarding-Genehmigung
- Eine Eignungsprüfung
- Eine Betrugswarnung
- Eine Entscheidung über einen Schadensfall
- Eine Weiterleitung zur Risikoprüfung
- Eine Bewertung der Kundenanfälligkeit
Sofern widersprüchliche oder veraltete Datensätze nicht bereits im Vorfeld identifiziert und bereinigt werden, können sie mit derselben scheinbaren Zuverlässigkeit verarbeitet werden wie vertrauenswürdige Daten. Ein unzuverlässiger Datensatz kann daher Entscheidungen schnell und in großem Umfang beeinflussen.
Unternehmen müssen zunehmend nicht nur erklären können, wie sich ein Modell bewährt hat, sondern auch, welche Daten dessen Ergebnisse gestützt haben, woher diese Daten stammten und welche Kontrollmaßnahmen angewendet wurden.
- Manuelle Fehler können vereinzelt auftreten oder nur im Einzelfall erkannt werden
- Automatisierte Prozesse können dasselbe Datenproblem auf eine viel größere Datenmenge übertragen
Der zuvor erwähnte Test gilt auch hier. Doch hier läuft das Problem mit Maschinengeschwindigkeit ab. Ein Unternehmen, das für einen einzelnen Kunden nicht innerhalb weniger Minuten eine Antwort geben konnte, hat nun ein Modell, das dieselbe unüberprüfte Entscheidung bei Tausenden von Kunden wiederholt, bevor es jemand bemerkt.
Warum ist es immer noch schwierig, strenge Compliance-Richtlinien nachzuweisen?
Viele Unternehmen aus dem Finanzsektor verfügen bereits über detaillierte Richtlinien, Rahmenwerke zur Datenverwaltung und dokumentierte Kontrollmaßnahmen.
Das Problem tritt auf, wenn es darum geht, nachzuweisen, dass die Richtlinie eingehalten wurde:
- Bei einem Kunden
- An einem Tag
- Bei einer Entscheidung
Der eigentliche Test besteht darin, ob die Daten, Kontrollmaßnahmen und Genehmigungen, die einer Entscheidung zugrunde liegen, erfasst wurden und zum Zeitpunkt der Anfrage abrufbar waren. Die meisten Unternehmen prüfen zwar, ob Richtlinien und Kontrollmaßnahmen vorhanden sind, sind jedoch möglicherweise weniger darauf vorbereitet, zu testen, wie schnell die entsprechenden Belege für einen realen Kunden oder eine konkrete Entscheidung zusammengestellt werden können.
Und genau darin liegt die eigentliche Herausforderung.
Eine aktuelle Studie von McKinsey zur KI-Datenbereitschaft kommt aus technischer Sicht zu einem ähnlichen Ergebnis: KI senkt nicht die Anforderungen an die Datenqualität, sondern erhöht die Kosten und die Geschwindigkeit, mit der Fehler auftreten können. Dieselbe Studie ergab, dass nur 7 % der Unternehmen KI unternehmensweit vollständig skaliert haben. Vor allem, weil die zugrunde liegenden Daten noch nicht bereit waren, dies zu unterstützen.
Wie Unternehmen der Finanz-, Versicherungs- und Bankbranche die Erstellung von Compliance-Nachweisen vereinfachen können
Die Lösung beginnt damit, vertrauenswürdige Kunden- und Partnerdaten als gemeinsame Infrastruktur zu behandeln.
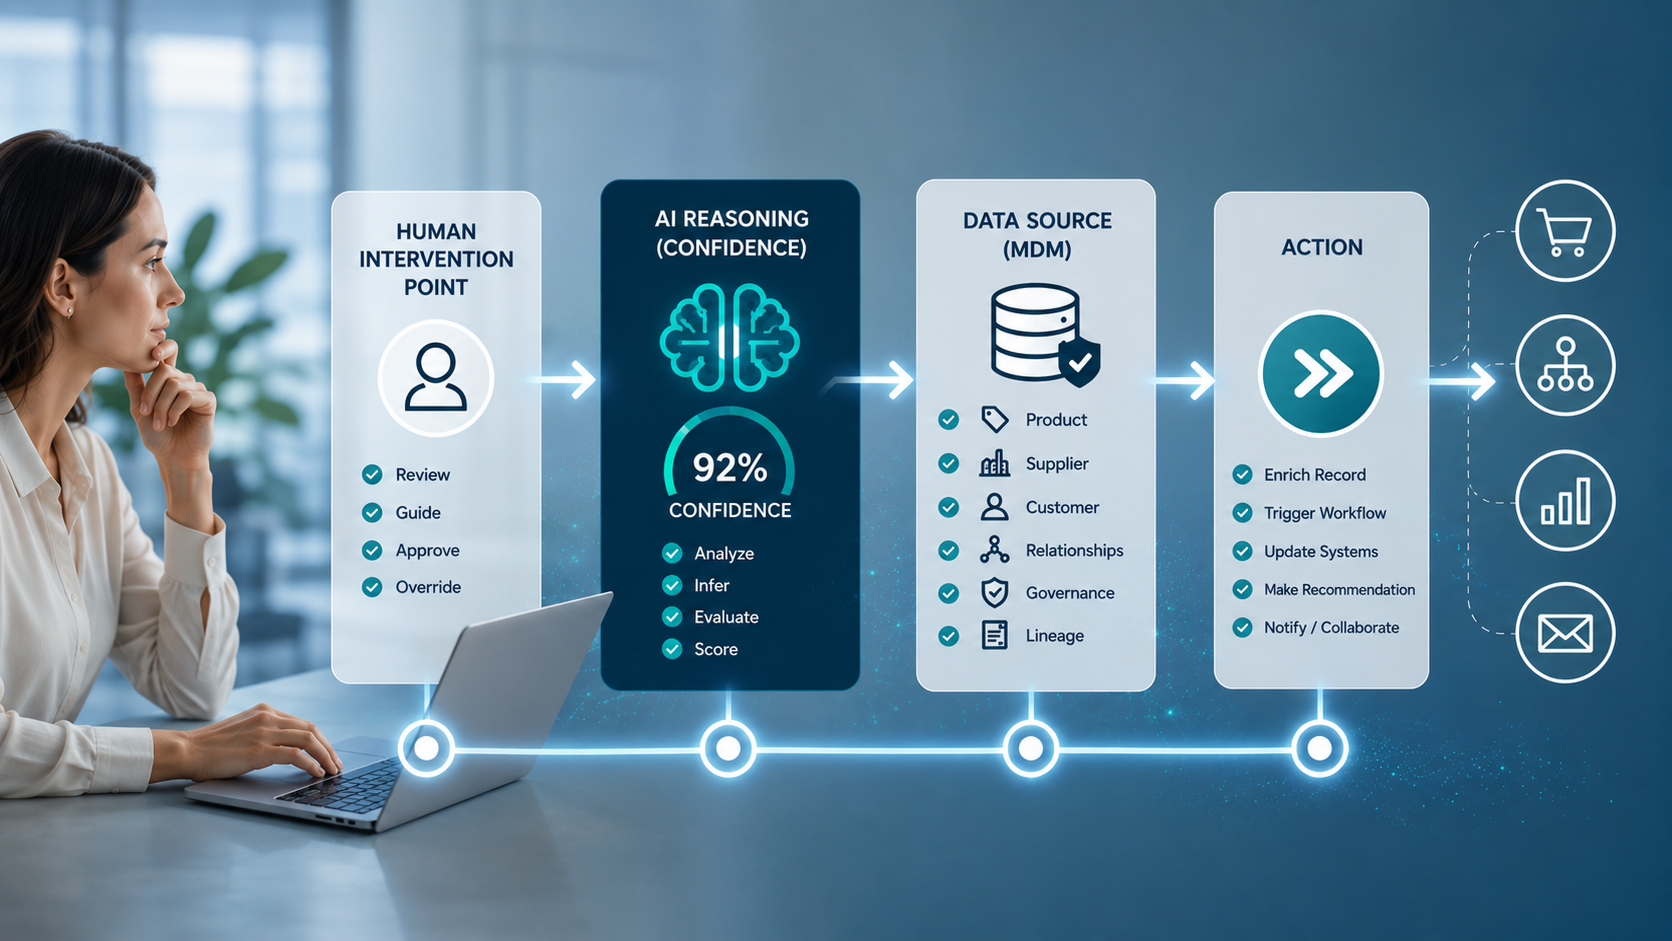
Die „Customer Experience Data Cloud“, die auf STEP – der vertrauenswürdigen Intelligence-Plattform von Stibo Systems – basierende Kundendatenlösung, bietet BFSI-Unternehmen eine geregelte Stammdatenbasis, mit deren Hilfe sie Identitäten verknüpfen, transparente Regeln anwenden und Nachweise darüber aufbewahren können, wie vertrauenswürdige Datensätze erstellt wurden. Die Lösung:
- Wendet transparente Abgleichs- und Überlebensregeln an und hilft Unternehmen so zu verstehen, warum Datensätze verknüpft wurden und welche Werte ausgewählt wurden
- verfolgt die Herkunft der Daten und zeigt, woher jede einzelne Kundendatenangabe stammt und wann sie zuletzt geändert wurde
- verwaltet Beziehungen und Hierarchien zwischen Kunden, Konten, Policen, Organisationen, Maklern und verbundenen Parteien
- unterstützt Stewardship- und Ausnahme-Workflows, sodass wichtige Identitätsentscheidungen überprüft werden können, anstatt in der Systemlogik verborgen zu bleiben
Unternehmen wie Royal London verwalten ihre Kundendaten bereits auf diese Weise. Diejenigen, die die Anforderungen der Aufsichtsbehörde erfüllen, können jedes Mal sofort antworten, wenn eine Frage gestellt wird – unabhängig davon, wie viele Unterlagen in einem Ordner liegen.
FAQ
Was ist der Unterschied zwischen einem CRM, einem Data Lake und einer verwalteten Identitätsschicht für Compliance-Zwecke?
Ein CRM zeichnet Interaktionen mit einem Kunden auf. Ein Data Lake speichert und analysiert Rohdaten. Keines von beiden ist darauf ausgelegt, zu entscheiden, welche Version eines Kundenakts korrekt ist, oder diese Entscheidung erklärbar zu machen, was die Aufgabe einer verwalteten Identitätsschicht ist.
Wann gilt das EU-KI-Gesetz für BFSI-Unternehmen, die KI bei Kundenentscheidungen einsetzen?
Das EU-KI-Gesetz wird im August 2026 vollständig anwendbar, mit spezifischen Verpflichtungen für Hochrisiko-KI-Systeme, die viele KI-gesteuerte Entscheidungen in Bezug auf Kredite, Onboarding, Schadensfälle und Underwriting im BFSI-Sektor abdecken.
Ersetzt eine verwaltete Identitätsschicht die Notwendigkeit eines Daten-Governance-Programms?
Nein. Es gibt einem Governance-Programm etwas, das es durchsetzen kann. Die Richtlinien setzen die Regeln; die Identitätsschicht sorgt dafür, dass diese Regeln anhand eines echten Kundenprofils überprüfbar sind.
Kann ein Unternehmen auf dem Papier konform sein, aber dennoch bei einem KI-Audit durchfallen?
Ja, und dies wird zu einer der häufigeren Lücken, die Regulierungsbehörden finden. Dokumentierte Richtlinien zeigen die Absicht. Ein KI-Audit prüft, ob die Daten hinter einer tatsächlichen Entscheidung mit dieser Absicht übereinstimmen, was eine ganz andere Frage ist.
Was passiert mit den alten Kundendaten, die vor Anwendung der aktuellen Regeln erstellt wurden?
Altdaten erhalten keine Ausnahme. Wenn es heute noch eine Kundenentscheidung beeinflusst, kann ein Regulierungsbehörde immer noch einen Nachweis darüber verlangen, unabhängig davon, wann der Datensatz ursprünglich erstellt wurde.
Wie oft sollte ein Unternehmen testen, ob es diese Beweise erbringen kann?
Es gibt kein festgelegtes regulatorisches Intervall, aber führende Unternehmen behandeln es wie eine Feuerübung, indem sie den Test intern an einem realen Kundenszenario durchführen, anstatt darauf zu warten, dass ein Regulierer ihn zuerst durchführt.