
Las herramientas de generación de informes y los agentes de inteligencia artificial plantean requisitos distintos en cuanto a los datos. Y la mayoría de las empresas solo están preparadas para uno de ellos.
Un entorno de generación de informes necesita datos lo suficientemente precisos como para poder agregarlos y mostrarlos.
Un agente, por su parte, necesita datos que sean:
- Actualizados y coherentes en todos los sistemas en el momento de la toma de decisiones
- Estén interrelacionados entre distintos ámbitos (del producto al proveedor, del proveedor al estado de cumplimiento)
- Trazables, de modo que cada decisión autónoma se pueda remontar a una fuente fiable
Piensa en un agente como en un atleta que se prepara para una carrera importante. Al igual que un atleta necesita algo más que una dieta decente —la nutrición durante el entrenamiento debe ser precisa—, los agentes de IA que compiten en decisiones empresariales de alto riesgo necesitan algo más que datos aptos para la elaboración de informes.
Los macronutrientes te permitieron superar la era de los paneles de control. Pero los micronutrientes son lo que exige la era de los agentes.
Sigue leyendo y descubre:
- Qué diferencia a los datos de nivel de informes de los datos de nivel de agente
- Qué consecuencias tiene ignorar esa distinción
- Qué necesita tu infraestructura para hacerlo bien
¿Por qué los agentes de IA no pueden utilizar simplemente los mismos datos que se utilizan en tus informes?
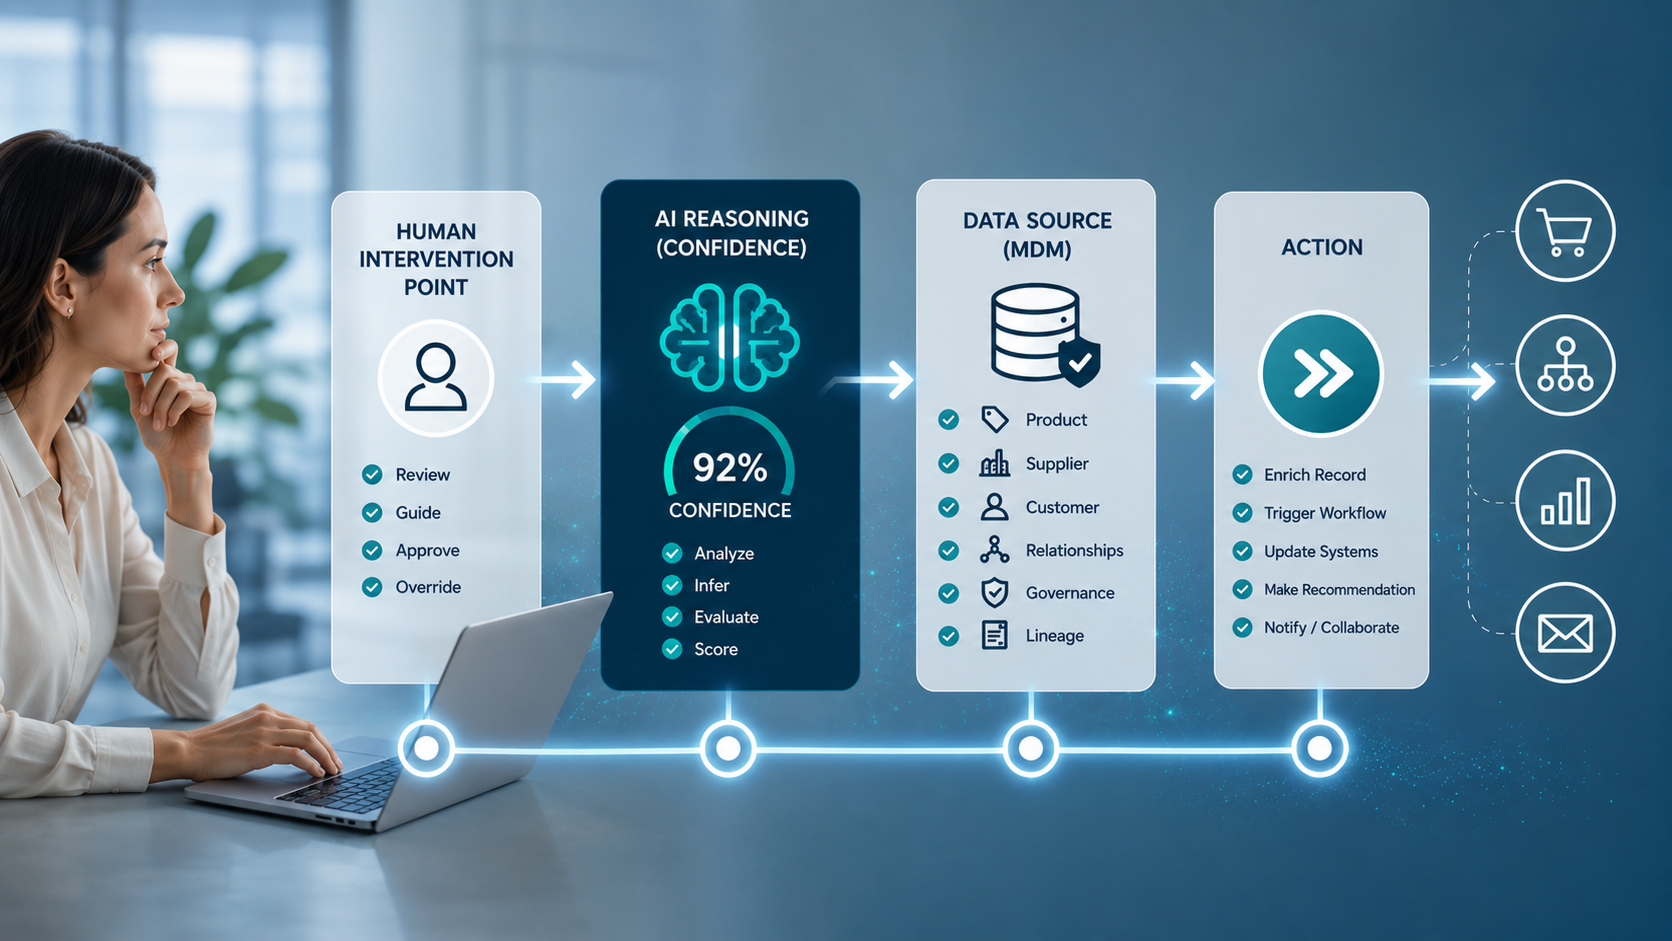
Las herramientas de generación de informes leen tus datos. Los agentes actúan en función de ellos. Lo hacen de forma autónoma, sin que un humano revise el resultado antes de que ocurra algo en el mundo real.
Esto cambia por completo lo que deben contener los datos.
Un registro que supere una auditoría de informes puede mostrar el nombre, la categoría y el precio correctos del producto. Para un panel de control, eso es suficiente.
Sin embargo, para un agente que debe decidir si realizar un pedido o recomendar un producto, no lo es. El agente necesita saber si el proveedor está actualmente autorizado, si el producto se encuentra en distribución activa y si el precio refleja las condiciones contractuales vigentes. Si falta alguno de estos datos, el agente actuará con una confianza que no está justificada.
También existe una dimensión semántica que los informes nunca han tenido en cuenta. Los agentes necesitan comprender qué significan los datos en su contexto, no solo qué valor figura en un campo, y esa distinción es más importante de lo que la mayoría de los equipos de datos esperan.
Por ejemplo, un producto aparece marcado como «activo» en un sistema y como «descatalogado» en otro.
- En un informe de BI, esto no plantea ningún problema visible
- Sin embargo, cuando un agente toma decisiones de gestión de pedidos a gran escala, esto plantea un grave problema
La generación de informes también tolera la latencia:
- Los paneles de control que funcionan con datos de ayer son una norma aceptada
- Un agente que actúe basándose en el estado de los proveedores o en los precios contractuales de ayer supone un riesgo operativo
Y, a diferencia de un informe desactualizado, nadie se da cuenta antes de que se tome la decisión.
¿Qué puede salir mal cuando tus agentes se basan en datos de carácter informativo?
Las consecuencias no siempre son inmediatas. Y eso es parte de lo que hace que sean difíciles de detectar. He aquí dos ejemplos:
Ejemplo 1
- Un agente de compras trabaja con datos de productos y proveedores que son lo suficientemente precisos como para elaborar informes.
- El registro del proveedor muestra un estado «aprobado». Y es que fue aprobado hace seis semanas, antes de que una revisión de cumplimiento detectara un problema y actualizara un sistema, pero no los demás.
- El agente realiza un pedido y la infracción se descubre más adelante, una vez firmado el contrato.
Ejemplo 2
Una situación de atención al cliente se desarrolla de forma diferente, pero acaba en el mismo punto que el ejemplo anterior.
- Un cliente aparece dos veces en tus datos. Se trata de un duplicado, creado al integrar dos sistemas regionales y que nunca se ha resuelto.
- El agente tramita una solicitud de devolución basada en uno de los registros, mientras que el sistema de gestión de pedidos actúa en función del otro.
- Se envíandos respuestas contradictorias antes de que nadie se dé cuenta.
Entonces, ¿qué conecta estos dos escenarios? Desde luego, no se trata de datos erróneos en el sentido tradicional. Los registros subyacentes eran lo suficientemente precisos como para elaborar informes.
Lo que les faltaba era la coherencia entre dominios y el estado actual que un agente necesita para actuar con seguridad.
Si se tratara simplemente de un informe erróneo, una persona podría haber detectado el problema antes de que nadie actuara en consecuencia. Los agentes, por el contrario, no se detienen a comprobar sus suposiciones.
Un atleta que se prepara para una carrera de 10 km no fracasa porque no haya entrenado lo suficiente. Fracasa porque la distancia exige un aporte energético que su plan de nutrición nunca ha cubierto.
¿Qué diferencia a los datos de nivel de agente de todo lo que los precedió?
Los datos de nivel «agent-grade» no son una versión más estricta de los datos limpios. El trabajo que conllevan es completamente diferente: las decisiones se toman sin que un humano compruebe primero el resultado.
Hay cinco cualidades que distinguen los datos de nivel de agente de los datos de nivel de informe:
- Coherencia entre los sistemas conectados y/o interoperables en el momento de la decisión, en lugar de en la última actualización por lotes
- Relaciones que abarcan distintos ámbitos, como un registro de producto que contenga información de la lista de materiales (BOM) sobre las materias primas de un proveedor, la ubicación, la planta o el activo que creó el producto, y cómo eso se ajusta a los requisitos de cumplimiento posteriores o a las exigencias del cliente, de modo que un agente disponga del contexto completo sobre cómo y dónde se fabrica un producto
- Contexto semántico, de modo que los datos transmitan un significado que un agente pueda interpretar, en lugar de limitarse a un valor almacenado en un campo
- Un linaje que se pueda rastrear, de modo que cada decisión autónoma se pueda vincular a la fuente de los datos y a la fecha de su última modificación
- Una gobernanza que el agente hereda automáticamente, en lugar de reglas aplicadas a posteriori en una capa separada
Nada de esto es específico de un ámbito (ni de un departamento). Se aplica tanto si el agente trabaja con datos de productos, de clientes o socios, de proveedores o de ubicación que sean propiedad de departamentos como compras, recepción, almacén, desarrollo de productos, marketing, envíos, seguridad, etc. Y la norma debe aplicarse a los cuatro ámbitos de datos, ya que un agente rara vez se limita a un único ámbito a la hora de tomar una decisión.
¿Cómo consigue Stibo Systems que tus datos cumplan el estándar de calidad para los agentes?
STEP, la plataforma de inteligencia de confianza de Stibo Systems, está diseñada para que los datos maestros cumplan el estándar «agent-grade» en todos los ámbitos con los que interactúa un agente, no solo en el que gestiona un único departamento.
Esto significa que:
- Los datos de productos, clientes, proveedores, socios comerciales y ubicaciones se gestionan como un único sistema conectado, en lugar de cuatro repositorios independientes que un agente tiene que conciliar por su cuenta
- La gobernanza está integrada en la capa de datos, de modo que los agentes heredan las reglas que necesitan para operar de forma fiable, en lugar de tener que esperar a una comprobación de cumplimiento independiente
- Las relaciones, el contexto semántico y el linaje están integrados en la propia arquitectura, de modo que un agente dispone de lo necesario para actuar sin tener que suplir las lagunas con suposiciones
El resultado son datos sobre los que sus agentes pueden actuar de forma independiente, con la trazabilidad y los límites de seguridad que exige la toma de decisiones autónoma.
Se trata de la base de datos maestros que subyace a la capa de agentes, construida antes de que el agente realice ninguna llamada. Para el deportista que se prepara para una gran carrera, esta es precisamente la infraestructura de entrenamiento.
Conclusión
Los datos aptos para la elaboración de informes no son datos de mala calidad. Han llevado a tus paneles de control y a tu equipo de BI exactamente a donde tenían que estar.
Pero tus agentes se enfrentan a un reto diferente y necesitan un nivel de preparación distinto al que jamás han requerido tus informes. Necesitan acceder a los conocimientos implícitos de tu organización para poder razonar y actuar con eficacia.
Un atleta que se alimenta lo justo para terminar una carrera no sube al podio. Lo mismo ocurre con tus datos. Lo que te permite tener un panel de control operativo no llevará a tus agentes a tomar una decisión en la que puedas confiar.
Para solucionar esto, hay que estructurar los datos de forma diferente desde cero.
Preguntas frecuentes
¿Cuál es la diferencia entre la calidad de los datos para informes y la calidad de los datos para agentes de IA?
La elaboración de informes necesita datos que sean lo suficientemente precisos para agregarse y mostrarse, y tolera cierta latencia e inconsistencias aisladas porque un humano está interpretando el resultado.
Los agentes de IA actúan directamente sobre los datos, sin que un humano verifique primero el resultado, por lo que necesitan datos que se mantengan consistentes en todos los sistemas, que lleven un contexto que puedan interpretar y que se puedan rastrear hasta su origen.
¿Por qué los agentes de IA necesitan datos en tiempo real cuando los paneles no?
Un panel de control basado en los datos de ayer es una limitación conocida y aceptada. Un agente que actúa basándose en el estado o los precios desactualizados de un proveedor toma una decisión basada en algo que puede que ya no sea cierto, y a diferencia de un informe obsoleto, nadie revisa esa decisión antes de que entre en vigor.
¿Pueden los agentes de IA trabajar con los mismos datos maestros utilizados para la inteligencia empresarial?
Pueden usar los mismos registros subyacentes, pero los datos maestros de calidad BI generalmente carecen de las relaciones entre dominios, el estado actual y la trazabilidad que un agente necesita para actuar de manera segura.
La mayoría de los fallos ocurren no porque los datos fueran incorrectos, sino porque nunca se construyeron para apoyar una decisión autónoma.
¿Qué pasa si se despliegan agentes de IA en datos que no son de calidad para agentes?
Los agentes proceden con los datos que se les proporcionan, incluso cuando esos datos están incompletos o desactualizados, porque no hay un humano en el circuito para detectar la brecha.
Esto puede llevar a decisiones basadas en aprobaciones desactualizadas, registros duplicados o información contradictoria entre sistemas, a menudo sin advertencia hasta que las consecuencias se manifiestan más adelante.