
Berichtstools und KI-Agenten stellen unterschiedliche Anforderungen an Ihre Daten. Und die meisten Unternehmen sind nur auf eine davon vorbereitet.
Eine Berichtsumgebung benötigt Daten, die genau genug sind, um aggregiert und dargestellt zu werden.
Ein Agent hingegen benötigt Daten, die:
- zum Zeitpunkt der Entscheidung aktuell und systemübergreifend konsistent sind
- domänenübergreifend verknüpft sind (vom Produkt zum Lieferanten, vom Lieferanten zum Compliance-Status)
- rückverfolgbar sind, wobei jede autonome Entscheidung auf eine vertrauenswürdige Quelle zurückgeführt werden kann
Stellen Sie sich einen Agenten wie einen Sportler vor, der sich auf ein großes Rennen vorbereitet. Genauso wie ein Sportler mehr als nur eine vernünftige Ernährung braucht – die Ernährung während des Trainings muss genau abgestimmt sein –, benötigen KI-Agenten, die bei unternehmenskritischen Entscheidungen im Einsatz sind, mehr als nur Daten in Berichtsqualität.
Die Makronährstoffe haben Sie durch das Dashboard-Zeitalter gebracht. Doch die Mikronährstoffe sind das, was das Zeitalter der Agenten erfordert.
Lesen Sie weiter und erfahren Sie mehr:
- Was Daten auf Reporting-Ebene von Daten auf Agenten-Ebene unterscheidet
- Was es kostet, wenn diese Unterscheidung ignoriert wird
- Was Ihre Infrastruktur benötigt, um dies richtig umzusetzen
Warum können KI-Agenten nicht einfach dieselben Daten verwenden, auf denen Ihre Berichte basieren?
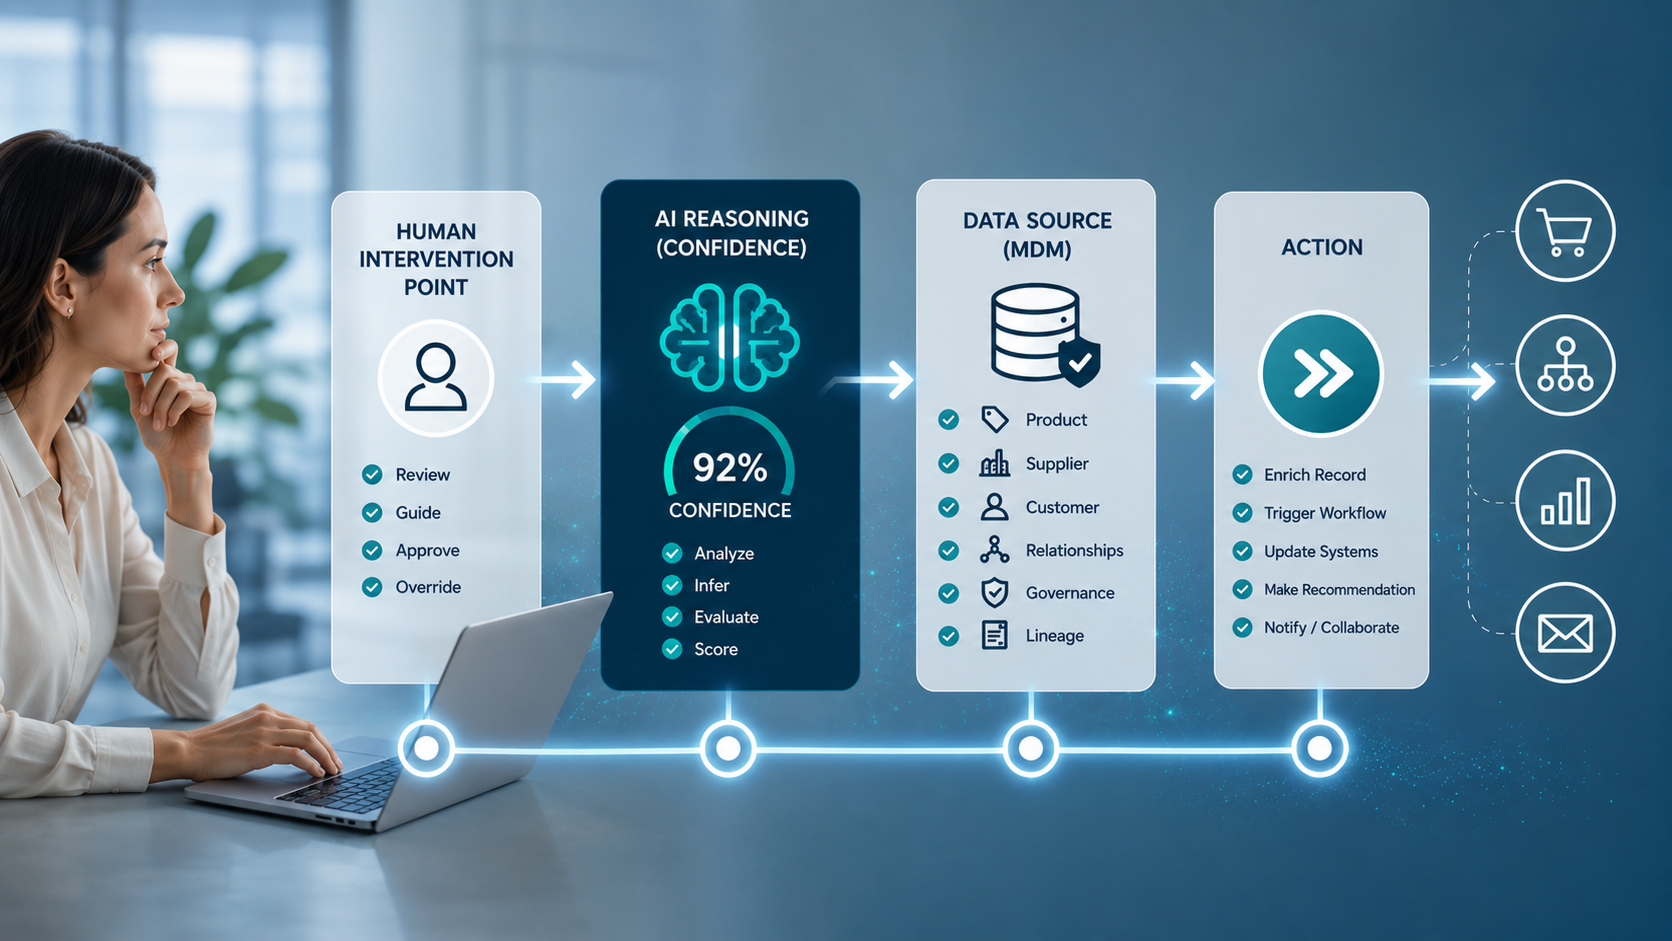
Berichtstools lesen Ihre Daten. Agenten handeln darauf basierend. Sie tun dies autonom, ohne dass ein Mensch die Ergebnisse überprüft, bevor in der realen Welt etwas geschieht.
Das verändert grundlegend, was die Daten enthalten müssen.
Ein Datensatz, der eine Berichtsprüfung besteht, enthält möglicherweise den korrekten Produktnamen, die Kategorie und den Preis. Für ein Dashboard reicht das aus.
Für einen Mitarbeiter, der entscheiden muss, ob er eine Bestellung aufgibt oder ein Produkt empfiehlt, reicht das jedoch nicht aus. Der Mitarbeiter muss wissen, ob der Lieferant derzeit zugelassen ist, ob das Produkt aktiv vertrieben wird und ob die Preisgestaltung den aktuellen Vertragsbedingungen entspricht. Fehlt eine dieser Informationen, handelt der Mitarbeiter mit einer Zuversicht, die er nicht verdient hat.
Es gibt zudem eine semantische Dimension, die für die Berichterstattung nie erforderlich war. Mitarbeiter müssen verstehen, was Daten im Kontext bedeuten, und nicht nur, welcher Wert in einem Feld steht – und dieser Unterschied ist wichtiger, als die meisten Datenteams erwarten.
Beispielsweise wird ein Produkt in einem System als „aktiv“ und in einem anderen als „auslaufend“ gekennzeichnet.
- In einem BI-Bericht führt dies zu keinem sichtbaren Problem
- Wenn ein Mitarbeiter jedoch in großem Umfang Entscheidungen zur Auftragsabwicklung trifft, entsteht dadurch ein ernstes Problem
Auch bei der Berichterstellung werden Verzögerungen toleriert:
- Dashboards, die auf den Daten von gestern basieren, sind eine akzeptierte Norm
- Ein Mitarbeiter, der auf der Grundlage des gestrigen Lieferantenstatus oder der vertraglich vereinbarten Preise handelt, stellt ein operatives Risiko dar
Und anders als bei einem veralteten Bericht bemerkt es niemand, bevor die Entscheidung getroffen wird.
Was läuft schief, wenn Ihre Agenten auf der Grundlage von Daten arbeiten, die eigentlich nur für Berichte gedacht sind?
Die Folgen sind nicht immer sofort erkennbar. Und genau das macht es so schwer, sie zu erkennen. Hier sind zwei Beispiele:
Beispiel 1
- Ein Einkäufer stützt sich auf Produkt- und Lieferantendaten, die für Berichtszwecke ausreichend genau sind.
- Der Lieferanteneintrag weist den Status „genehmigt“ auf. Denn er wurde genehmigt – vor sechs Wochen, bevor bei einer Compliance-Prüfung ein Problem festgestellt und ein System aktualisiert wurde, die anderen jedoch nicht.
- Der Mitarbeiter gibt eine Bestellung auf, und der Verstoß wird erst später, nach Vertragsunterzeichnung, entdeckt.
Beispiel 2
Ein Kundenservice-Szenario verläuft anders, führt jedoch zum gleichen Ergebnis wie das vorherige Beispiel.
- Ein Kunde ist in Ihren Daten zweimal vorhanden. Es handelt sich um ein Duplikat, das bei der Integration zweier regionaler Systeme entstanden ist, aber nie bereinigt wurde.
- Der Mitarbeiter bearbeitet eine Rücksendeanfrage für einen Datensatz, während ein Fulfillment-System auf den anderen Datensatz reagiert.
- Es werden zwei widersprüchliche Antworten versendet, bevor es jemand bemerkt.
Was verbindet also diese beiden Szenarien? Es handelt sich sicherlich nicht um fehlerhafte Daten im herkömmlichen Sinne. Die zugrunde liegenden Datensätze waren für die Berichterstellung genau genug.
Was ihnen fehlte, war die domänenübergreifende Konsistenz und der aktuelle Status, den ein Sachbearbeiter benötigt, um sicher handeln zu können.
Wäre es nur ein fehlerhafter Bericht gewesen, hätte ein Mensch das Problem möglicherweise erkannt, bevor jemand darauf reagiert hätte. Agenten hingegen halten nicht inne, um ihre Annahmen zu überprüfen.
Ein Athlet, der sich auf einen 10-km-Lauf vorbereitet, scheitert nicht, weil er nicht genug trainiert hat. Er scheitert, weil die Distanz einen Energiebedarf erfordert, den sein Ernährungsplan nie abgedeckt hat.
Was unterscheidet Daten auf Agentenniveau von allem, was es zuvor gab?
Daten auf Agentenniveau sind keine strengere Version von bereinigten Daten. Der damit verbundene Arbeitsaufwand ist völlig anders: Entscheidungen werden getroffen, ohne dass ein Mensch die Ergebnisse zuvor überprüft.
Fünf Eigenschaften unterscheiden Daten auf Agent-Niveau von Daten auf Berichtsebene:
- Konsistenz über vernetzte und/oder interoperable Systeme hinweg zum Zeitpunkt der Entscheidung, statt erst bei der letzten Stapelaktualisierung
- Domänenübergreifende Beziehungen, wie beispielsweise ein Produktdatensatz, der Stücklisteninformationen zu Rohstoffen eines Lieferanten, den Standort/das Werk/die Anlage, an dem/der das Produkt hergestellt wurde, sowie Angaben dazu enthält, inwiefern dies mit nachgelagerten Compliance-Vorgaben oder Kundenanforderungen übereinstimmt, sodass ein Agent den vollständigen Kontext darüber hat, wie und wo ein Produkt hergestellt wird
- Semantischer Kontext, sodass die Daten eine Bedeutung tragen, die ein Mitarbeiter interpretieren kann, anstatt nur einen Wert in einem Feld darzustellen
- Eine nachvollziehbare Herkunft, sodass jede autonome Entscheidung auf die Quelle der Daten und den Zeitpunkt der letzten Änderung zurückverfolgt werden kann
- Governance, die der Agent automatisch übernimmt, anstatt dass Regeln nachträglich in einer separaten Ebene angewendet werden
Nichts davon ist domänenspezifisch (oder abteilungsspezifisch). Es gilt unabhängig davon, ob der Agent mit Produktdaten, Kunden-/Partnerdaten, Lieferantendaten oder Standortdaten arbeitet, die sich im Besitz von Abteilungen wie Einkauf, Wareneingang, Lager, Produktentwicklung, Marketing, Versand, Sicherheit usw. befinden. Und der Standard muss für alle vier Datenbereiche gelten, da ein Agent bei der Entscheidungsfindung selten innerhalb eines einzigen Bereichs bleibt.
Wie bringt Stibo Systems Ihre Daten auf den „Agent-Grade“-Standard?
STEP, die Trusted Intelligence Platform von Stibo Systems, wurde entwickelt, um Stammdaten in jedem Bereich, mit dem ein Mitarbeiter zu tun hat, auf den „Agent-Grade“-Standard zu bringen – nicht nur in dem Bereich, der einer einzelnen Abteilung untersteht.
Das bedeutet:
- Produkt-, Kunden-, Lieferanten-, Geschäftspartner- und Standortdaten werden als ein einziges, vernetztes System verwaltet – statt in vier separaten Datenbeständen, die ein Mitarbeiter selbst abgleichen muss
- In die Datenebene integrierte Governance, sodass Mitarbeiter die Regeln, die sie für einen zuverlässigen Betrieb benötigen, automatisch erhalten, anstatt auf eine separate Konformitätsprüfung warten zu müssen
- Beziehungen, semantischer Kontext und Datenherkunft sind in die Architektur selbst integriert, sodass ein Agent über alles verfügt, was er zum Handeln benötigt, ohne Lücken mit Annahmen füllen zu müssen
Das Ergebnis sind Daten, auf deren Grundlage Ihre Agenten eigenständig handeln können – mit der Rückverfolgbarkeit und den Sicherheitsvorkehrungen, die eine autonome Entscheidungsfindung erfordert.
Es handelt sich um die Stammdatengrundlage unterhalb der Agentenebene, die bereits geschaffen ist, bevor der Agent überhaupt einen Aufruf tätigt. Für den Sportler, der sich auf das große Rennen vorbereitet, ist dies genau die Trainingsinfrastruktur.
Zusammenfassung
Daten in Berichtsqualität sind keine schlechten Daten. Sie haben Ihre Dashboards und Ihr BI-Team genau dorthin gebracht, wo sie hin mussten.
Aber Ihre Mitarbeiter befinden sich in einem ganz anderen Wettlauf und benötigen ein anderes Maß an Vorbereitung, als es Ihre Berichte jemals getan haben. Sie benötigen Zugang zum „Stammeswissen“ Ihres Unternehmens, um effektiv zu denken und zu handeln.
Ein Sportler, der gerade genug Energie zu sich nimmt, um ein Rennen zu beenden, steht nicht auf dem Podium. Das Gleiche gilt für Ihre Daten. Was Ihnen ein funktionierendes Dashboard liefert, führt Ihre Mitarbeiter nicht zu einer Entscheidung, der Sie vertrauen können.
Um das zu beheben, müssen Sie Ihre Daten von Grund auf anders aufbauen.
FAQ
Was ist der Unterschied zwischen Datenqualität für Berichterstattung und Datenqualität für KI-Agenten?
Reporting benötigt Daten, die genau genug sind, um aggregiert und angezeigt zu werden, und es toleriert eine gewisse Latenz und isolierte Inkonsistenzen, da ein Mensch das Ergebnis interpretiert.
KI-Agenten handeln direkt auf Daten, ohne dass ein Mensch das Ergebnis zuerst überprüft, daher benötigen sie Daten, die in den Systemen konsistent bleiben, einen Kontext tragen, den sie interpretieren können, und auf ihre Quelle zurückverfolgt werden können.
Warum benötigen KI-Agenten Echtzeitdaten, wenn Dashboards das nicht tun?
Ein Dashboard, das auf den Daten von gestern basiert, ist eine bekannte und akzeptierte Einschränkung. Ein Agent, der auf veralteten Lieferantenstatus oder Preisen handelt, trifft eine Entscheidung basierend auf etwas, das möglicherweise nicht mehr zutrifft, und im Gegensatz zu einem veralteten Bericht überprüft niemand diese Entscheidung, bevor sie in Kraft tritt.
Können KI-Agenten mit denselben Stammdaten arbeiten, die für Business Intelligence verwendet werden?
Sie können dieselben zugrunde liegenden Datensätze verwenden, aber BI-qualifizierte Stammdaten fehlen normalerweise die bereichsübergreifenden Beziehungen, der aktuelle Status und die Nachverfolgbarkeit, die ein Agent benötigt, um sicher zu handeln.
Die meisten Fehler passieren nicht, weil die Daten falsch waren, sondern weil sie nie darauf ausgelegt waren, eine autonome Entscheidung zu unterstützen.
Was passiert, wenn KI-Agenten auf Daten eingesetzt werden, die nicht agentenwürdig sind?
Agenten arbeiten mit den Daten, die ihnen gegeben werden, selbst wenn diese unvollständig oder veraltet sind, weil kein Mensch im Prozess ist, um die Lücke zu erkennen.
Dies kann zu Entscheidungen auf der Grundlage veralteter Genehmigungen, doppelter Datensätze oder widersprüchlicher Informationen in verschiedenen Systemen führen, oft ohne Vorwarnung, bis die Konsequenzen im Nachhinein sichtbar werden.