Wenn ein KI-Agent eine falsche Antwort gibt, liegt das Problem wahrscheinlich nicht beim Modell. Es liegt vielmehr an den Daten, die nie dafür konzipiert wurden, systemübergreifend abgeglichen zu werden.
Im Pilotprojekt mag alles perfekt aussehen. Das liegt daran, dass Pilotprojekte oft erfolgreich sind, weil jemand die Daten manuell aufbereitet und den Umfang so eng hält, dass er überschaubar bleibt.
Im Produktivbetrieb sind diese Voraussetzungen nicht gegeben.
Wenn ein Mitarbeiter gleichzeitig mit Lieferanten-, Produkt-, Finanz- und Marktdaten arbeiten muss, treten fünf spezifische Schwachstellen zutage.
Jeder einzelne davon ist für sich genommen wohlbekannt. Zusammen erklären sie jedoch, warum so viele KI-Programme nach einem vielversprechenden Start ins Stocken geraten. Schauen wir uns also kurz jeden einzelnen an und wie man sie beheben kann, damit Ihre agentenbasierte KI skalierbar wird.
1. Veraltete oder widersprüchliche Stammdaten
Beginnen wir mit dem grundlegendsten Fehler: Der Agent vertraut einem Datensatz, der bereits veraltet ist.
Unternehmensdaten befinden sich selten an einem einzigen Ort. Ein Produkt kann fünf Versionen haben, die über verschiedene ERP-Instanzen (Enterprise Resource Planning), ein PIM-System (Product Information Management), eine regionale Datenbank und ein Lieferantenportal verteilt sind. Jede dieser Versionen wird nach eigenem Zeitplan und von einem eigenen Team aktualisiert.
Ein Agent weiß nicht, welche Version aktuell ist. Er fragt das System ab, mit dem er verbunden ist, und betrachtet die Antwort als Tatsache.
So kommt es, dass ein Preisagent am selben Tag für dasselbe Produkt in einer Region eine Preiserhöhung um 12 % und in einer anderen Region einen unveränderten Preis empfiehlt. Keine der beiden Empfehlungen ist an sich falsch. Jede spiegelt lediglich eine andere, veraltete Version desselben Datensatzes wider.
Sobald der Unterschied auffällt, vertraut keine der beiden Regionen mehr dem Ergebnis.
2. Widersprüchliche Definitionen über Domänen hinweg
Der Begriff „Datensatz“ kann je nachdem, wen man in der Organisation fragt, unterschiedliche Bedeutungen haben.
Einkaufs-, Finanz- und Vertriebsteams definieren dieselbe Entität oft auf ihre eigene Weise. Ein „Produkt“ in einem Produktlebenszyklus-Managementsystem entspricht möglicherweise nicht einem „Produkt“ in der Preisgestaltung, und die Lieferantenklassifizierung in einem System steht möglicherweise im Widerspruch zu einer Risikobewertung in einem anderen.
Ein domänenübergreifend arbeitender Agent hat keine Möglichkeit, dies eigenständig zu klären. Er wählt einfach eine Definition aus und handelt entsprechend.
Ohne domänenübergreifende gemeinsame Definitionen kann ein Agent keine verlässlichen Erkenntnisse liefern. Er kann lediglich eine Vermutung anstellen, die zufällig mit der Sichtweise eines Systems übereinstimmt.
3. Keine nachvollziehbare Herkunft
Wenn die Ausgabe eines Agenten falsch erscheint, lautet die nächste Frage immer dieselbe: Warum hat er diese Entscheidung getroffen?
Ohne Nachverfolgbarkeit lässt sich diese Frage nicht beantworten. Niemand kann die Empfehlung zurückverfolgen bis zu:
- die Quelldatensätze
- den Beziehungen zwischen ihnen
- Die dabei angewandten Geschäftsregeln
Die Entscheidung existiert ohne Herkunftsnachweis, was eine Reproduktion oder Verteidigung unmöglich macht.
Dies hat Konsequenzen, die weit über das Datenteam hinausreichen. Das EU-KI-Gesetz schreibt vor, dass KI-Systeme mit hohem Risiko Ergebnisse liefern müssen, die interpretierbar, dokumentierbar und rückverfolgbar sind.
In regulierten Branchen führt eine fehlende Nachverfolgbarkeit dazu, dass jede unerklärbare Entscheidung eines Agenten zu einem Compliance-Risiko wird.
4. Keine klare Datenzuordnung oder Verantwortlichkeit
Produktdaten gehören einem Team. Lieferantendaten gehören einem anderen, und in den meisten Unternehmen ist niemand für die Beziehung zwischen beiden zuständig.
Das funktioniert gut, solange Menschen jede Entscheidung innerhalb ihres eigenen Zuständigkeitsbereichs treffen. Es versagt jedoch in dem Moment, in dem ein Akteur domänenübergreifend abgestimmte Daten benötigt, um handeln zu können.
Niemand hat die Befugnis, einen Konflikt zwischen einem Produktdatensatz und einem Lieferantendatensatz zu lösen, da die Zuständigkeit an den Grenzen der jeweiligen Systeme endet.
Ohne eine klare Verantwortungsstruktur funktioniert domänenübergreifende Steuerung schlichtweg nicht.
5. Keine Vertrauensschwellenwerte oder Eskalationswege für Maßnahmen der Sachbearbeiter
Eine Entscheidung zu empfehlen und sie umzusetzen, sind nicht mit dem gleichen Risiko verbunden. Die meisten Governance-Rahmenwerke wurden nur für den ersten Fall entwickelt.
Ein Agent ohne definierte Vertrauensschwelle wendet bei jeder Entscheidung das gleiche Maß an Autonomie an.
Dabei spielt es keine Rolle, wie unsicher die zugrunde liegenden Daten sind. Es gibt keinen Punkt, an dem das System innehält und die Entscheidung stattdessen an einen Menschen weiterleitet.
Das bedeutet, dass eine einzige fehlerhafte Eingabe zu einem systemischen Fehler führt. Der Agent wiederholt denselben Fehler bei jedem Datensatz, den er verarbeitet – und zwar mit maschineller Geschwindigkeit, bevor es jemand bemerkt.
So beheben Sie diese 5 Datenfehler und machen agentenbasierte KI zuverlässig
Jeder dieser Fehler lässt sich auf dieselbe Ausgangssituation zurückführen. Die Daten wurden für die Berichterstattung strukturiert und nicht für Maschinen, die mit hoher Geschwindigkeit arbeiten.
Um dies zu beheben, gehen Sie wie folgt vor:
- Weisen Sie domänenübergreifend Verantwortlichkeiten zu, sodass jemand die Befugnis hat, einen Konflikt zwischen einem Produktdatensatz und einem Lieferantendatensatz zu lösen. Lassen Sie nicht zu, dass sich daraus eine Pattsituation zwischen den Teams entwickelt.
- Verankern Sie Governance-Regeln direkt in der Dateninfrastruktur, damit fehlerhafte Daten bereits abgefangen werden, bevor sie einen Mitarbeiter erreichen (und nicht erst Wochen später bei einer Überprüfung).
- Verbinden Sie Domänen über ein gemeinsames Beziehungsmodell, anstatt jede einzelne isoliert zu verwalten. Ein Mitarbeiter, der mit Lieferanten-, Produkt- und Marktdaten arbeitet, sollte ein einheitliches Gesamtbild vorfinden.
- Behandeln Sie die Datenherkunft als etwas, das jeder Datensatz standardmäßig enthält, und nicht als etwas, das ein Compliance-Team später zusammenfügen muss.
Zu viele Unternehmen gehen dies schrittweise an, anstatt alles auf einmal zu erledigen. Beispielsweise beginnen sie mit der Zuständigkeit, dann folgt die Governance und erst danach verbinden sie die Domänen. Die Herkunftsnachverfolgung ergibt sich als Nebenprodukt, wenn die übrigen Schritte gut umgesetzt werden.
STEP, unsere bewährte Intelligence-Plattform, bewältigt all dies in einem einzigen, vernetzten System.
Wie Stibo Systems all diese Probleme auf einen Schlag behebt
STEP löst diese Probleme, indem es eine geregelte Stammdatenbasis mit mehreren Domänen als ein einziges vernetztes System betrachtet und nicht als fünf separate Probleme.
Die Zuständigkeiten werden durch ein gemeinsames Metadatenmodell geregelt. Produkt-, Lieferanten-, Kunden- und Standortdaten werden auf einer einzigen Plattform mit einem einheitlichen Governance-Rahmen verwaltet, sodass kein Bereich außerhalb der Kontrolle eines Verantwortlichen liegt.
Governance-Regeln werden direkt in die Daten selbst integriert. Rollenbasierte Zugriffskontrolle und Prüfprotokolle gelten für jeden Datensatz, unabhängig davon, ob die Änderung von einem menschlichen Verwalter oder einem Agenten vorgenommen wird.
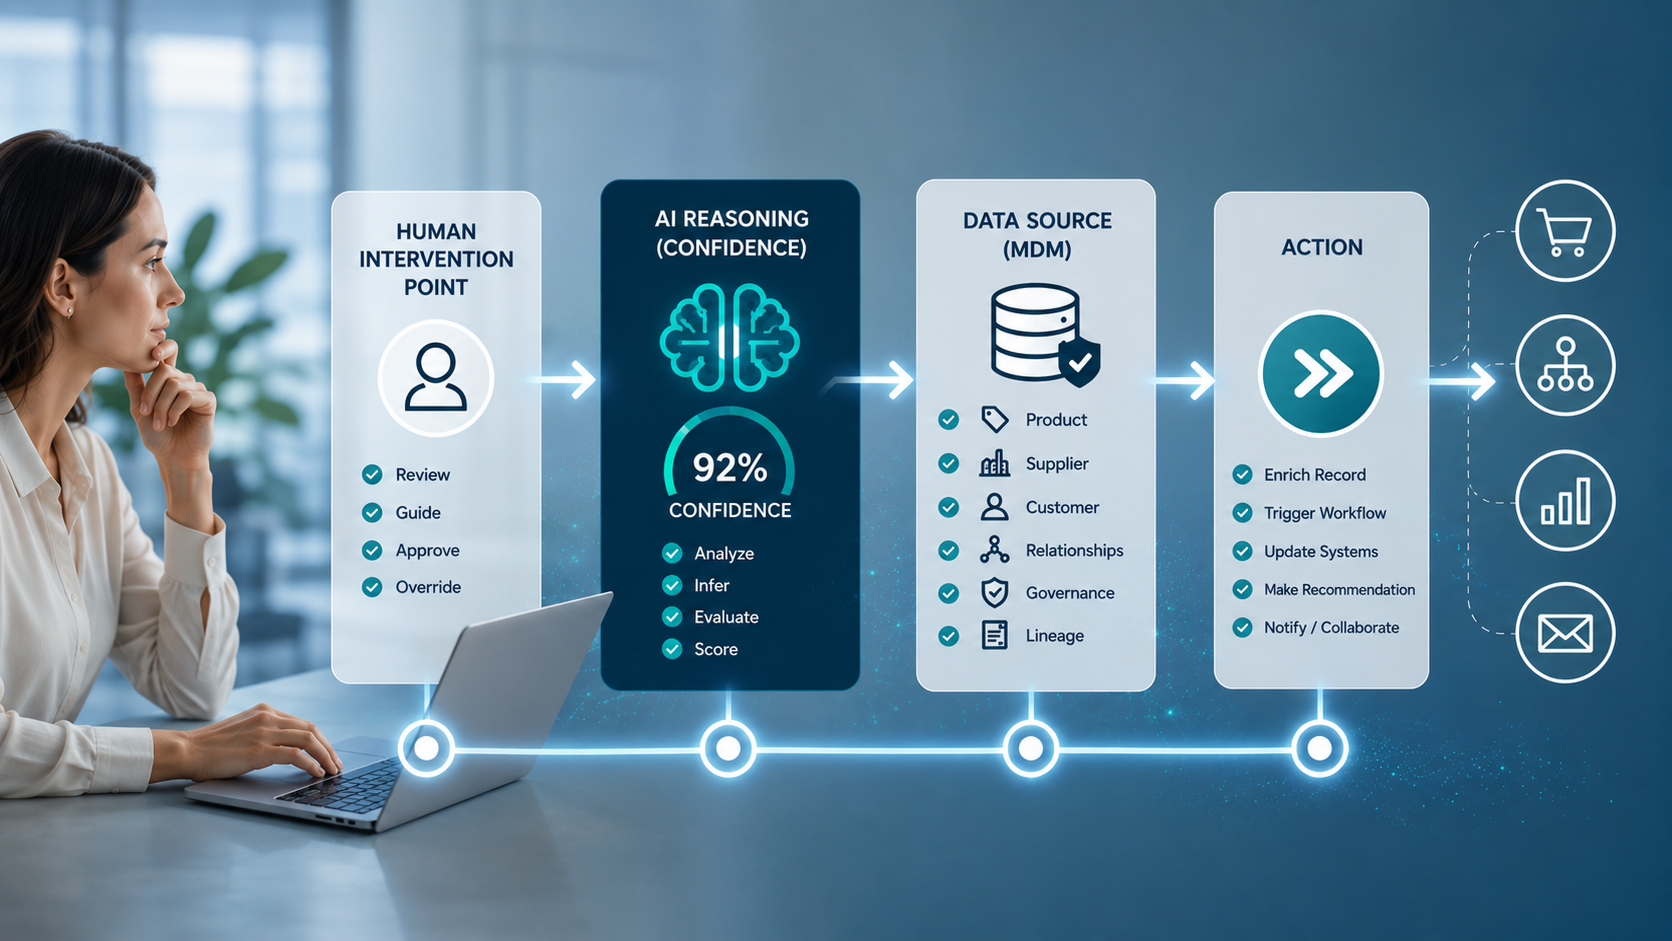
Die Grenzen der Agenten werden durch die fundierte agentische Ebene der Plattform definiert, die die Vertrauensschwellen und Eskalationsregeln festlegt, innerhalb derer ein Agent arbeiten muss, bevor er autonom handeln kann.
Und die Rückverfolgbarkeit wird zum Standard. Jede Entscheidung – ob von einem Menschen oder einer Maschine – wird versioniert und lässt sich bis zu dem Datensatz, der Beziehung und der Regel zurückverfolgen, die zu ihr geführt haben.
Zusammenfassung
Behebt man die Fehler, muss der Agent nicht mehr raten. Er arbeitet auf der Grundlage eines einzigen geregelten Datensatzes mit einem klaren Verantwortlichen, einem nachvollziehbaren Entscheidungspfad und einer definierten Grenze dessen, was er ohne menschliche Überprüfung tun darf. So sieht vertrauenswürdige Intelligenz in dem Moment aus, in dem ein Agent darauf reagiert.
Um genauer zu verstehen, warum diese Datenfehler bei KI-Programmen in Unternehmen so häufig vorkommen, laden Sie das Whitepaper „AI at Scale“ herunter, das wir gemeinsam mit Accenture verfasst haben. Das Whitepaper erläutert die Datenvoraussetzungen, die den Unterschied zwischen einem Pilotprojekt und einer KI im großen Maßstab ausmachen.
FAQ
Warum gibt meine KI inkonsistente Antworten über dasselbe Produkt oder denselben Kunden?
Der Agent greift wahrscheinlich auf mehr als eine Version dieses Datensatzes zu.
Verschiedene Systeme, wie ERP, PIM oder eine regionale Datenbank, halten oft unterschiedliche Werte für dasselbe Produkt oder denselben Kunden, und ein Agent hat keine eingebaute Möglichkeit zu wissen, welcher Wert aktuell ist. Es antwortet einfach aus der Quelle, die es zufällig abfragt.
Was verursacht, dass KI-Agenten Fehler machen, selbst wenn das zugrunde liegende Modell gut ist?
Ein fähiges Modell kann dennoch auf schlechte Eingaben reagieren, wie zum Beispiel:
- Veraltete Aufzeichnungen
- Widersprüchliche Definitionen in verschiedenen Bereichen
- Fehlende Abstammung
- Unklare Eigentumsverhältnisse
Diese erzeugen alle Fehler, die auf den ersten Blick wie Modellfehler aussehen. In den meisten Fällen liegt die Ursache in den Daten, die dem Agenten gegeben wurden, und nicht darin, wie das Modell darüber nachgedacht hat.
Das erneute Trainieren oder Austauschen von Modellen löst selten ein Problem, das bereits in der Datenbasis selbst begonnen hat.
Wie unterscheidet sich agentische KI von KI-Empfehlungen in Bezug auf Datenrisiken?
Eine Empfehlung wird vor jeglicher Handlung von einem Menschen überprüft. Ein Agent überspringt diesen Schritt, sodass eine fehlerhafte Eingabe sofort in eine fehlerhafte Aktion umschlägt, und dies kann sich über jeden ähnlichen Datensatz wiederholen, bevor jemand es bemerkt.
Ist das Master Data Management noch relevant, jetzt wo die meisten KI auf großen Sprachmodellen basieren?
Relevanter, nicht weniger. Große Sprachmodelle (LLMs) beherrschen die Sprache gut, aber sie sind immer noch auf verwaltete Stammdaten angewiesen, um zu wissen:
- Welcher Lieferanten-Datensatz ist aktuell
- Wie ein Produkt klassifiziert werden sollte
- Welcher Kundenstamm ist marktübergreifend maßgeblich?
Ohne diese Grundlage produziert ein LLM fließende Antworten, die auf falschen Fakten basieren.
Was ist eine verankerte agentische Schicht?
Es ist Teil der Architektur einer Plattform, die definiert, was ein Agent selbst entscheiden kann und wann eine Entscheidung stattdessen an eine Person weitergeleitet werden muss.
Es legt Vertrauensschwellen und Eskalationsregeln direkt in die Dateninfrastruktur fest, sodass ein Agent, der mit unsicheren oder minderwertigen Daten arbeitet, an einen Menschen weitergeleitet wird, anstatt auf einer Vermutung zu basieren.
Verlangsamt die Behebung dieser Datenfehler den AI-Fahrplan?
Nicht unbedingt. Eigentum, Governance und Abstammungsarbeit können parallel zur KI-Entwicklung stattfinden, anstatt als separate Phase, die alles andere verzögert.
Teams, die diesen Schritt überspringen, verlieren später tendenziell mehr Zeit, um das Vertrauen in einen Agenten wiederherzustellen, der einen sichtbaren Fehler in der Produktion gemacht hat. Die frühzeitige Behebung der Grundlage ist in der Regel der schnellere Weg.