
レポート作成ツールとAIエージェントは、データに対してそれぞれ異なる要件を課します。そして、ほとんどの企業は、そのうちのどちらか一方にしか対応できていません。
レポート作成環境には、集計や表示を行うのに十分な精度を持つデータが必要です。
一方、エージェントには次のようなデータが必要です:
- 意思決定の時点で最新であり、システム間で一貫性があること
- ドメイン間で関連付けられている(製品からサプライヤーへ、サプライヤーからコンプライアンス状況へ)
- 追跡可能であり、自律的な意思決定のすべてが信頼できる情報源に紐付けられている
エージェントを、大舞台のレースに備えるアスリートのようなものと考えてみてください。アスリートが単なる「まともな食事」以上のもの――トレーニングのための栄養管理が正確でなければならないのと同様に、重要な企業意思決定の場で競い合うAIエージェントには、単なる報告用のデータ以上のものが必要です。
ダッシュボード時代を乗り切れたのは「主要栄養素」のおかげでした。しかし、エージェント時代に求められるのは「微量栄養素」なのです。
続きを読んで、以下のことを学びましょう:
- 「レポートグレード」のデータと「エージェントグレード」のデータの違いとは
- その違いを無視した場合に生じるコスト
- これを適切に実現するためにインフラストラクチャに求められること
なぜAIエージェントは、レポートで処理されているのと同じデータを使えないのか?
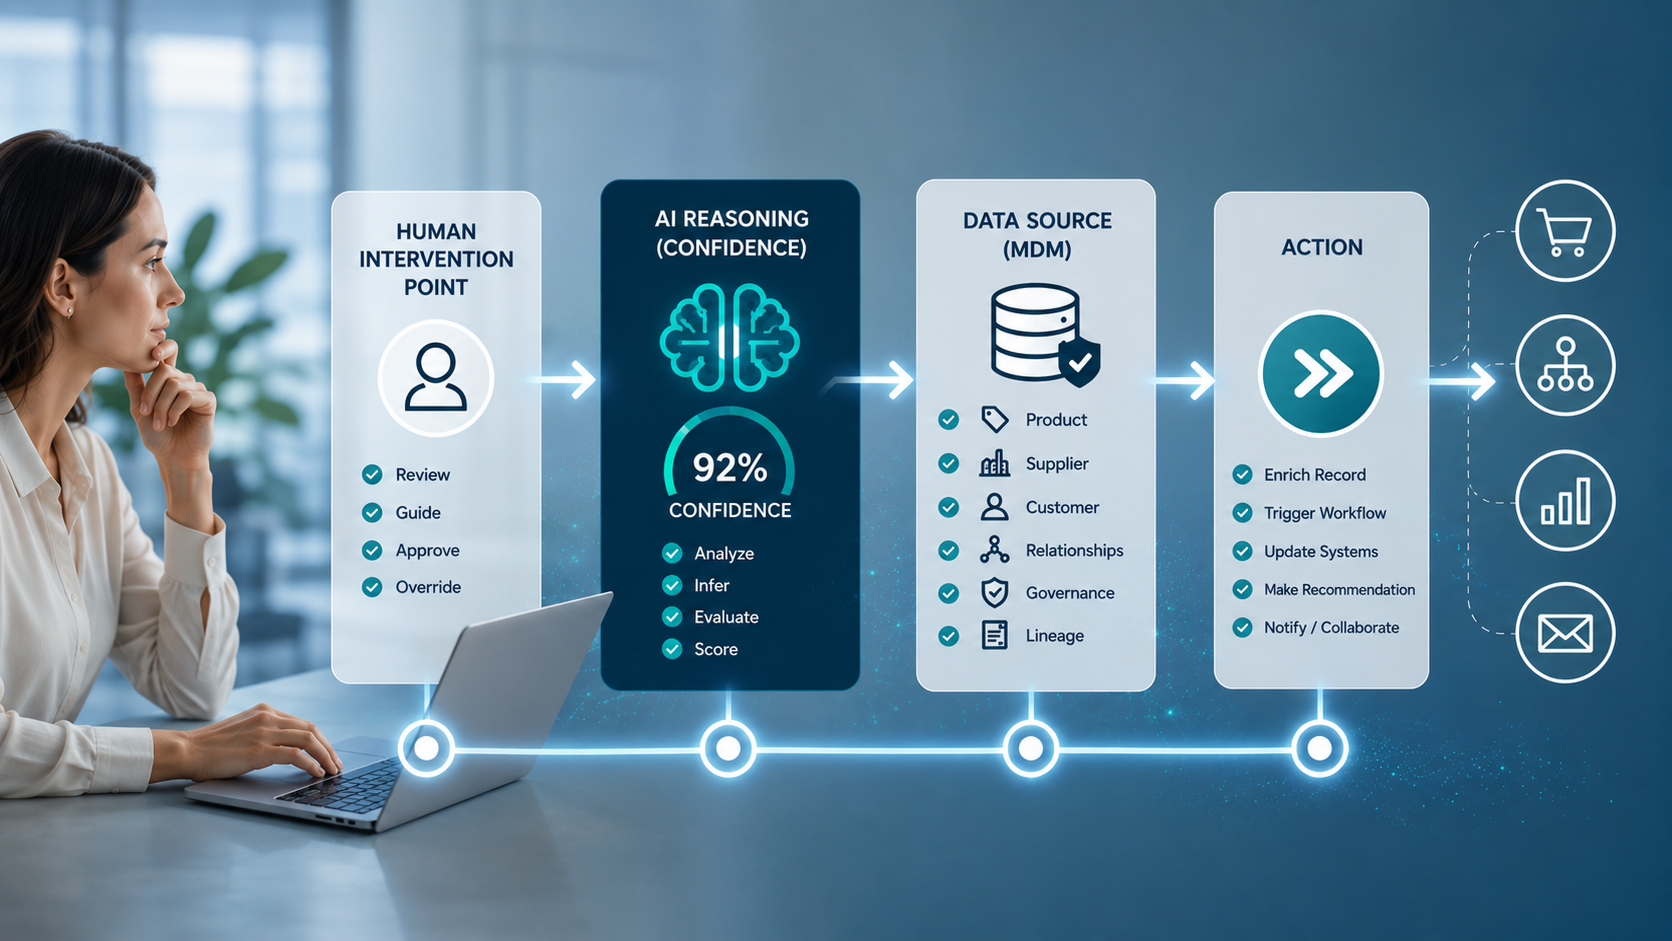
レポート作成ツールはデータを読み取ります。エージェントはそれに基づいて行動します。エージェントは自律的に行動し、現実世界で何かが起こる前に、人間が出力を確認することはありません。
そのため、データに含まれるべき内容も根本的に変わってきます。
レポート監査に合格したレコードには、正しい製品名、カテゴリ、価格が記載されているかもしれません。ダッシュボードとしては、それで十分です。
しかし、注文を行うか、製品を推奨するかを判断する担当者にとっては、それだけでは不十分です。担当者は、そのサプライヤーが現在承認されているか、その製品が現在流通中であるか、そして価格が現在の契約条件を反映しているかを知っておく必要があります。これらの情報のいずれかが欠けていれば、担当者は根拠のない自信を持って行動することになってしまいます。
また、レポート作成ではこれまで必要とされなかった「意味論的側面」も存在します。担当者は、単にフィールドにどの値が入っているかだけでなく、その文脈においてデータが何を意味するのかを理解する必要があります。そして、その区別は、多くのデータチームが想定している以上に重要なのです。
例えば、あるシステムでは「販売中」と表示されている製品が、別のシステムでは「販売終了」と表示されているといったケースがあります。
- BIレポート上では、これによって目に見える問題は生じません
- しかし、エージェントが大規模に注文処理の決定を行っている場合、これは深刻な問題を引き起こします
レポート処理においても遅延は許容されます:
- 昨日のデータに基づいて動作するダッシュボードは、容認されている標準である
- エージェントが昨日のサプライヤーの状況や契約価格に基づいて行動することは、業務上のリスクとなります
そして、古いレポートとは異なり、意思決定が行われる前にそれに気づく者は誰もいない。
担当者がレポート用データに基づいて業務を行うと、どのような問題が生じるのでしょうか?
その影響がすぐに現れるとは限りません。そして、それが発見を困難にしている一因でもあります。以下に2つの例を挙げます:
例1
- ある調達担当者は、報告目的には十分な精度を持つ製品およびサプライヤーのデータに基づいて業務を行っています。
- サプライヤーの記録には「承認済み」と表示されている。というのも、6週間前に承認されていたからだ。その時点では、コンプライアンス審査で問題が指摘され、あるシステムは更新されたものの、他のシステムは更新されていなかったためである。
- 担当者は発注を行い、契約締結後の下流工程でコンプライアンス違反が発見される。
例2
カスタマーサービスのシナリオは展開が異なりますが、結果としては前の例と同じ結末に至ります。
- データ内に同じ顧客が2回登録されています。これは、2つの地域別システムが統合された際に発生した重複データであり、その後も解消されていません。
- 担当者は一方のレコードに対して返品依頼を処理する一方で、フルフィルメントシステムは他方のレコードに基づいて処理を行ってしまいます。
- 誰にも気づかれる前に、矛盾する2つの応答が送信されてしまいます。
では、これら2つのシナリオを結びつけるものは何でしょうか?それは、従来の意味での「不良データ」では決してありません。元となるレコードは、レポート作成には十分な精度を備えていました。
しかし、エージェントが安全に業務を行うために必要な、ドメイン間の整合性や最新の状態という情報が欠けていたのです。
もし単に不備のあるレポートだっただけなら、誰かがそれに基づいて行動を起こす前に、人間ならその問題に気づいていたかもしれません。一方、エージェントは、自分の仮定を確認するために立ち止まることはありません。
10キロのレースに向けて準備するアスリートが失敗するのは、トレーニングが足りなかったからではありません。失敗するのは、その距離を走るために必要なエネルギーが、自身の栄養計画ではカバーされていなかったからです。
エージェント級のデータと、それ以前のあらゆるデータを分けるものは何でしょうか?
エージェントグレードのデータは、クリーンデータのより厳格なバージョンというわけではない。その背後にある作業は全く異なるものであり、人間がまず出力を確認することなく意思決定が行われる。
エージェントグレードのデータとレポートグレードのデータには、以下の5つの特徴による違いがあります:
- 最後のバッチ更新時点ではなく、意思決定の瞬間に、接続されたシステムおよび/または相互運用可能なシステム間で一貫性が保たれていること
- ドメインをまたぐ関係性。例えば、ある製品レコードには、サプライヤーからの原材料に関するBOM情報、その製品を製造した場所/工場/資産、およびそれが下流のコンプライアンスや顧客要件とどのように整合しているかといった情報が含まれており、これによりエージェントは、製品がどのように、どこで製造されたかという完全な文脈を把握できる
- セマンティックなコンテキスト。これにより、データは単にフィールドに格納された値であるだけでなく、エージェントが解釈できる意味を持つ
- 追跡可能なデータリネージ。これにより、あらゆる自律的な意思決定を、データの出所や最終変更日時まで遡って紐づけることができる
- エージェントが自動的に継承するガバナンス。事後的に別のレイヤーで適用されるルールではなく
これらはいずれも、特定のドメイン(または特定の部門)に限定されたものではありません。 エージェントが、購買、受入、倉庫、製品開発、マーケティング、出荷、安全などの部門が所有する製品データ、顧客/パートナーデータ、サプライヤーデータ、位置情報のいずれを扱っているかに関わらず適用されます。また、エージェントが意思決定を行う際、単一のドメイン内に留まることはめったにないため、この標準は4つのデータドメインすべてにわたり適用されなければなりません。
Stibo Systemsは、どのようにしてお客様のデータを「エージェントグレード」の基準まで引き上げるのでしょうか?
Stibo Systemsの信頼性の高いインテリジェンスプラットフォーム「STEP」は、単一の部門が所有するドメインだけでなく、担当者が関わるあらゆるドメインにおいて、マスターデータを「エージェントグレード」の基準に引き上げるように設計されています。
つまり、次のようなことが可能です:
- 製品、顧客、サプライヤー、ビジネスパートナー、および拠点のデータが、エージェントが独自に照合しなければならない4つの別々のリポジトリではなく、1つの連携したシステムとして管理される
- ガバナンスがデータレイヤーに組み込まれているため、担当者は別途のコンプライアンスチェックを待つことなく、確実に業務を遂行するために必要なルールを自動的に引き継ぐことができます
- 関係性、意味論的コンテキスト、およびデータリネージがアーキテクチャ自体に組み込まれているため、エージェントは仮定で空白を埋めることなく、行動に必要な情報を得ることができる
その結果、自律的な意思決定に不可欠なトレーサビリティと安全策を備えつつ、エージェントが独自にアクションを起こせるデータが実現されます。
これは、エージェントが呼び出しを行う前に構築される、エージェント層の下に位置するマスターデータの基盤です。大きなレースに向けて準備を進めるアスリートにとって、これはまさにトレーニングの基盤そのものです。
まとめ
レポート作成に適したデータは、決して質の低いデータではありません。そのデータのおかげで、ダッシュボードやBIチームは必要な場所に確実に到達できたのです。
しかし、現場の担当者は別の戦いを繰り広げており、レポートとは異なるレベルの準備を必要としています。彼らは、効果的に判断し行動するために、組織に蓄積された「暗黙知」にアクセスできる必要があります。
レースを完走するのに必要な最低限のエネルギーしか補給しないアスリートは、表彰台に立つことはできません。データについても同じことが言えます。ダッシュボードを機能させるだけのデータでは、担当者が信頼できる意思決定を下すことはできないのです。
この問題を解決するには、データを一から異なる方法で構築する必要があります。
よくある質問
報告用のデータ品質とAIエージェント用のデータ品質の違いは何ですか?
レポーティングには、集計して表示するのに十分な精度のデータが必要であり、出力を人間が解釈するため、ある程度の遅延や孤立した不整合を許容します。
AIエージェントはデータを直接処理し、人間が結果を確認することなく動作するため、システム間で一貫性があり、解釈可能なコンテキストを持ち、元のソースに遡ることができるデータが必要です。
なぜAIエージェントはリアルタイムデータを必要とし、ダッシュボードは必要としないのですか?
昨日のデータに基づいて作成されたダッシュボードは、既知の受け入れられた制限です。 古いサプライヤーのステータスや価格に基づいて行動するエージェントは、もはや真実でないかもしれない情報に基づいて決定を下しますが、古いレポートとは異なり、その決定が実行される前に誰もその決定を確認しません。
AIエージェントはビジネスインテリジェンスで使用されるのと同じマスターデータで作業できますか?
彼らは同じ基礎データを使用できますが、BIグレードのマスターデータは通常、エージェントが安全に行動するために必要なドメイン間の関係、現在の状態、およびトレーサビリティが欠けています。
ほとんどの失敗はデータが間違っていたからではなく、自律的な意思決定をサポートするように作られていなかったからです。
エージェントグレードでないデータにAIエージェントが展開された場合、何が起こりますか?
エージェントは与えられたデータに基づいて進めますが、そのデータが不完全であったり古くなっていたりしても、ギャップをキャッチする人間がループにいないためです。
これは、古い承認に基づく決定、重複した記録、またはシステム間での矛盾する情報に基づく決定につながる可能性があり、その結果が下流で現れるまで警告がないことがよくあります。