
Gli strumenti di reporting e gli agenti basati sull'intelligenza artificiale pongono requisiti diversi ai dati. E la maggior parte delle aziende è preparata solo per uno dei due.
Un ambiente di reporting necessita di dati sufficientemente accurati da poter essere aggregati e visualizzati.
Un agente, d'altra parte, necessita di dati che siano:
- Aggiornati e coerenti tra i vari sistemi al momento della decisione
- Collegati tra i diversi ambiti (dal prodotto al fornitore, dal fornitore allo stato di conformità)
- Tracciabili, con ogni decisione autonoma riconducibile a una fonte attendibile
Immaginate un agente come un atleta che si prepara per una gara importante. Proprio come un atleta ha bisogno di qualcosa di più di una dieta adeguata – l’alimentazione durante l’allenamento deve essere precisa – gli agenti di IA che competono nelle decisioni aziendali ad alto rischio hanno bisogno di qualcosa di più dei semplici dati da reportistica.
I macronutrienti vi hanno permesso di superare l’era dei dashboard. Ma sono i micronutrienti ciò che l’era degli agenti richiede.
Continua a leggere e scopri:
- Cosa distingue i dati di livello "reporting" da quelli di livello "agente"
- Quali sono i costi quando si ignora questa distinzione
- Di cosa ha bisogno la tua infrastruttura per farlo nel modo giusto
Perché gli agenti di intelligenza artificiale non possono semplicemente utilizzare gli stessi dati su cui si basano i vostri report?
Gli strumenti di reportistica leggono i dati. Gli agenti agiscono sulla base di essi. Lo fanno in modo autonomo, senza che un operatore umano verifichi i risultati prima che avvenga qualcosa nel mondo reale.
Questo cambia completamente ciò che i dati devono contenere.
Un record che supera una verifica di reporting potrebbe riportare il nome corretto del prodotto, la categoria e il prezzo. Per una dashboard, questo è sufficiente.
Per un agente che deve decidere se effettuare un ordine o consigliare un prodotto, invece, non lo è. L’agente deve sapere se il fornitore è attualmente autorizzato, se il prodotto è in distribuzione attiva e se il prezzo riflette le attuali condizioni contrattuali. Se manca una di queste informazioni, l’agente procede con una sicurezza che non ha motivo di avere.
Esiste inoltre una dimensione semantica che il reporting non ha mai richiesto. Gli agenti devono comprendere il significato dei dati nel contesto, non solo il valore contenuto in un campo — e questa distinzione è più importante di quanto la maggior parte dei team di analisi dei dati si aspetti.
Ad esempio, un prodotto è contrassegnato come «attivo» in un sistema e come «fuori produzione» in un altro.
- In un report di BI, ciò non crea alcun problema visibile
- Quando un operatore deve prendere decisioni relative all’evasione degli ordini su larga scala, ciò crea un problema serio
Anche la reportistica tollera la latenza:
- I dashboard che utilizzano i dati del giorno precedente sono una norma accettata
- Un agente che agisce sulla base dello stato dei fornitori o dei prezzi contrattuali di ieri rappresenta un rischio operativo
E, a differenza di un report obsoleto, nessuno se ne accorge prima che la decisione venga presa.
Cosa va storto quando i vostri agenti si basano su dati di tipo reportistico?
Le conseguenze non sono sempre immediate. Ed è proprio questo che le rende difficili da individuare. Ecco due esempi:
Esempio 1
- Un addetto agli acquisti sta lavorando sulla base di dati relativi a prodotti e fornitori che sono sufficientemente accurati ai fini della rendicontazione.
- La scheda del fornitore indica lo stato "approvato". Questo perché era stato approvato sei settimane prima, prima che una verifica di conformità segnalasse un problema e aggiornasse un sistema, ma non gli altri.
- L’addetto effettua un ordine e la violazione viene scoperta a valle, dopo la firma del contratto.
Esempio 2
Uno scenario relativo al servizio clienti si svolge in modo diverso, ma porta allo stesso risultato dell’esempio precedente.
- Un cliente è presente due volte nei vostri dati. Si tratta di un duplicato, creatosi in seguito all’integrazione di due sistemi regionali e mai risolto.
- L'operatore gestisce una richiesta di reso in base a un record, mentre il sistema di evasione ordini agisce in base all'altro.
- Vengono inviatedue risposte contrastanti prima che qualcuno se ne accorga.
Cosa accomuna questi due scenari? Certamente non si tratta di dati errati nel senso tradizionale del termine. I record sottostanti erano sufficientemente accurati per la reportistica.
Ciò che mancava era la coerenza tra i domini e lo stato attuale di cui un agente ha bisogno per agire in sicurezza.
Se si fosse trattato solo di un rapporto errato, un essere umano avrebbe potuto individuare il problema prima che qualcuno agisse sulla base di esso. Gli agenti, d’altra parte, non si fermano a verificare le proprie ipotesi.
Un atleta che si prepara per una 10K non fallisce perché non si è allenato abbastanza. Fallisce perché la distanza richiede un apporto energetico che il suo piano nutrizionale non ha mai previsto.
Cosa distingue i dati di livello “agente” da tutto ciò che li ha preceduti?
I dati di livello “agent-grade” non sono una versione più rigorosa dei dati puliti. Il lavoro richiesto è completamente diverso: le decisioni vengono prese senza che un essere umano controlli prima il risultato.
Cinque caratteristiche distinguono i dati di livello "agent-grade" dai dati di livello "reporting-grade":
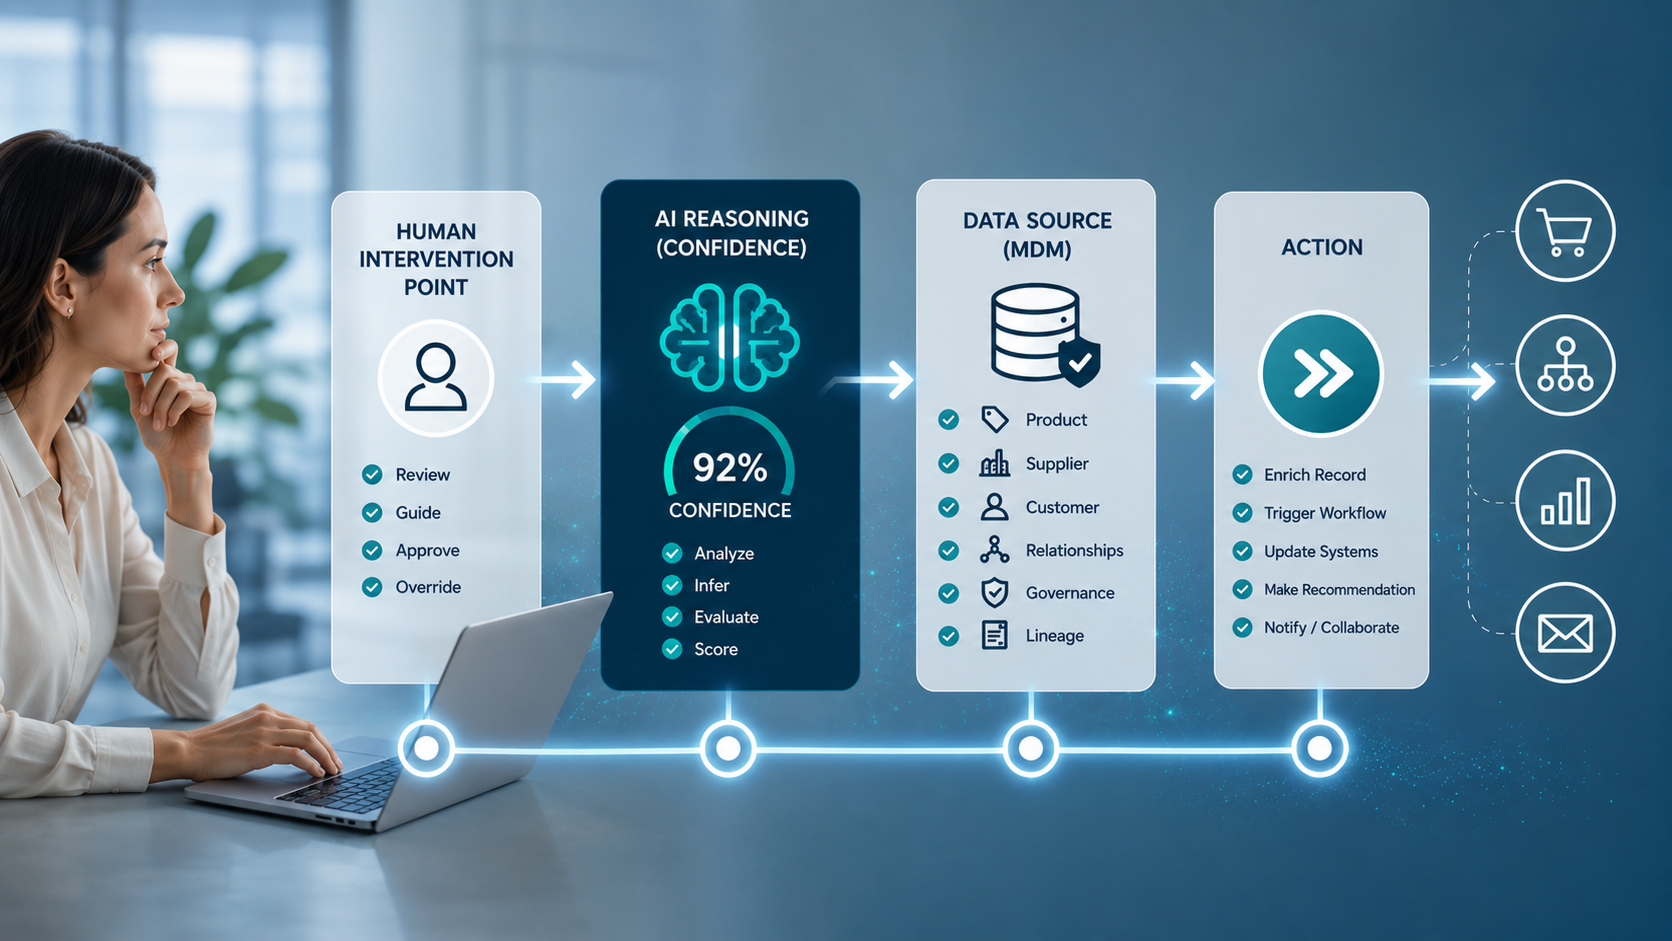
- Coerenza tra sistemi collegati e/o interoperabili al momento della decisione, anziché all’ultimo aggiornamento in batch
- Relazioni che abbracciano diversi ambiti, come ad esempio un record di prodotto che contiene informazioni sulla distinta base (BOM) relative alle materie prime provenienti da un fornitore, la sede/lo stabilimento/il bene che ha creato il prodotto e come ciò si allinea alle conformità a valle o ai requisiti del cliente, in modo che un agente disponga del contesto completo su come e dove viene realizzato un prodotto
- Contesto semantico, in modo che i dati abbiano un significato interpretabile dall’agente, anziché essere semplicemente un valore contenuto in un campo
- Una genealogia tracciabile, in modo che ogni decisione autonoma possa essere ricondotta alla fonte dei dati e al momento dell’ultima modifica
- Una governance che l’agente eredita automaticamente, anziché regole applicate a posteriori in un livello separato
Nulla di tutto ciò è specifico di un determinato settore (o reparto). Si applica sia che l’agente stia lavorando con dati di prodotto, dati di clienti/partner, dati di fornitori o dati di localizzazione di proprietà di reparti quali acquisti, ricevimento merci, magazzino, sviluppo prodotti, marketing, spedizioni, sicurezza, ecc. E lo standard deve valere per tutti e quattro i domini di dati, poiché un agente raramente rimane all’interno di un unico dominio quando prende una decisione.
In che modo Stibo Systems porta i vostri dati allo standard "agent-grade"?
STEP, la Trusted Intelligence Platform di Stibo Systems, è progettata per portare i dati master allo standard “agent-grade” in ogni ambito con cui un agente entra in contatto, non solo in quello di competenza di un singolo reparto.
Ciò significa che:
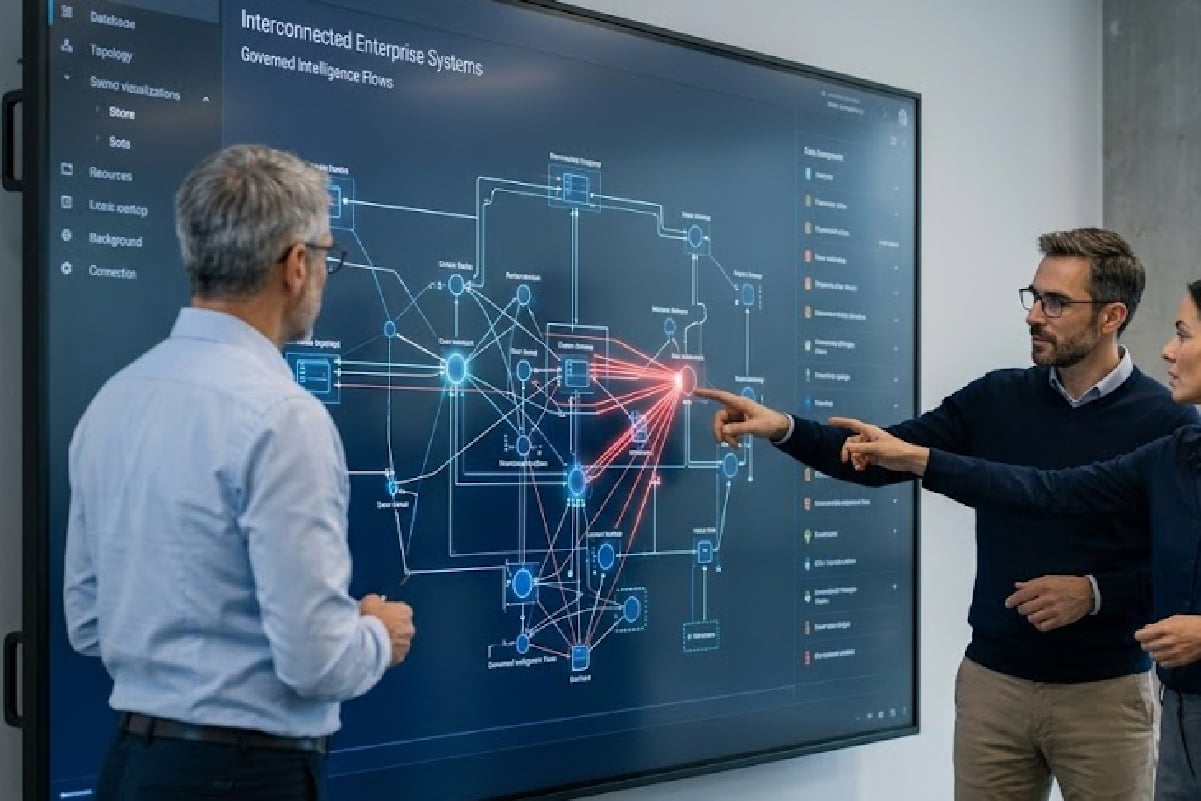
- I dati relativi a prodotti, clienti, fornitori, partner commerciali e sedi vengono gestiti come un unico sistema interconnesso, anziché come quattro archivi separati che un agente deve riconciliare autonomamente
- La governance è integrata a livello di dati, così gli agenti ereditano le regole di cui hanno bisogno per operare in modo affidabile, invece di dover attendere un controllo di conformità separato
- Relazioni, contesto semantico e provenienza integrati nell’architettura stessa, in modo che un agente disponga di ciò che gli serve per agire senza dover colmare le lacune con supposizioni
Il risultato sono dati su cui i vostri agenti possono agire in modo indipendente, con la tracciabilità e i meccanismi di controllo che il processo decisionale autonomo richiede.
Si tratta della base di dati di riferimento sottostante al livello degli agenti, costruita prima ancora che l’agente effettui una chiamata. Per l’atleta che si prepara alla grande gara, questa è proprio l’infrastruttura di allenamento.
Conclusione
I dati adatti alla reportistica non sono dati scadenti. Hanno permesso alle vostre dashboard e al vostro team di BI di raggiungere esattamente l’obiettivo prefissato.
Ma i vostri agenti stanno affrontando una sfida diversa e hanno bisogno di un livello di preparazione diverso rispetto a quello richiesto dai vostri report. Hanno bisogno di accedere al sapere collettivo della vostra organizzazione per poter ragionare e agire in modo efficace.
Un atleta che si nutre solo quanto basta per portare a termine una gara non sale sul podio. Lo stesso vale per i vostri dati. Ciò che vi permette di ottenere una dashboard funzionante non porterà i vostri agenti a prendere una decisione di cui potete fidarvi.
Per risolvere questo problema, è necessario costruire i dati in modo diverso, partendo da zero.
FAQ
Qual è la differenza tra la qualità dei dati per la reportistica e la qualità dei dati per gli agenti AI?
La reportistica ha bisogno di dati che siano abbastanza accurati da essere aggregati e visualizzati, e tollera una certa latenza e incoerenze isolate perché un essere umano sta interpretando il risultato.
Gli agenti AI agiscono direttamente sui dati, senza che un umano controlli prima il risultato, quindi hanno bisogno di dati che rimangano coerenti tra i sistemi, portino un contesto che possano interpretare e possano essere tracciati fino alla loro fonte.
Perché gli agenti di intelligenza artificiale hanno bisogno di dati in tempo reale mentre i dashboard non ne hanno bisogno?
Un cruscotto basato sui dati di ieri è una limitazione nota e accettata. Un agente che agisce su uno stato o un prezzo del fornitore obsoleto prende una decisione basata su qualcosa che potrebbe non essere più vero, e a differenza di un rapporto obsoleto, nessuno rivede quella decisione prima che entri in vigore.
Gli agenti di intelligenza artificiale possono lavorare con gli stessi dati master utilizzati per l'intelligence aziendale?
Possono utilizzare gli stessi registri sottostanti, ma i dati master di livello BI di solito mancano delle relazioni interdominio, dello stato attuale e della tracciabilità di cui un agente ha bisogno per agire in sicurezza.
La maggior parte dei fallimenti non avviene perché i dati erano errati, ma perché non sono mai stati costruiti per supportare una decisione autonoma.
Cosa succede se gli agenti AI vengono distribuiti su dati che non sono di livello agente?
Gli agenti procedono con i dati che ricevono, anche quando quei dati sono incompleti o obsoleti, perché non c'è un umano nel circuito per rilevare la lacuna.
Questo può portare a decisioni basate su approvazioni obsolete, registri duplicati o informazioni contrastanti tra i sistemi, spesso senza alcun avviso fino a quando le conseguenze non si manifestano a valle.